Материал: Статистическая значимость в парной линейной регрессии
. Условие Величины ei взаимно независимы со всеми значениями объясняющих переменных xi. Обычно считают, что объясняющие переменные являются неслучайными величинами.
Здесь, во всех условиях i=1,2,…,n.
Эти предпосылки образуют первую группу предпосылок, необходимых для проведения регрессионного анализа в рамках классической модели.
Вторая группа предпосылок дает достаточные условия для обоснованного проведения проверки статистической значимости эмпирических регрессий:
. Условие Совместное распределение случайных величин e1, …, en является нормальным.
При выполнении предпосылок первой и второй групп случайные величины e1, …, en оказываются взаимно независимыми, одинаково распределенными случайными величинами, подчиняющимися нормальному распределению с нулевым математическим ожиданием и дисперсией s2. Модель (1.9), удовлетворяющая приведенным выше условиям, называется классической нормальной линейной моделью парной регрессии.
Возможно использование теоремы Гаусса-Маркова
если регрессионная модель 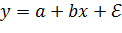 , удовлетворяет условиям, то оценки МНК a и b, (1.3) имеют
наименьшую дисперсию в классе всех линейных несмещенных оценок.
Заметим, что после построения уравнения выборочной регрессии, наблюдаемые значения yi можно представить в виде
i=`yi+ei, i=`1,n, (1.1.7)
где 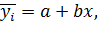 i=1,n, коэффициенты a и b, определяются по формуле (1.3).
Остатки ei, являются, в отличие от возмущений ei, наблюдаемыми величинами, с помощью которых можно
оценить воздействие неучтенных факторов и ошибок наблюдений. Говорят, что ei
является выборочной оценкой возмущения ei.
Можно показать, что статистика (выборочная остаточная
дисперсия), определяемая с помощью остатков ei (см. (6)):
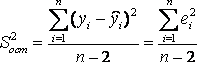 (1.1.8)
является несмещенной оценкой дисперсии s2 - дисперсии возмущений (теоретической остаточной дисперсии).
При выполнении условий Гаусса-Маркова первой и второй групп справедливы утверждения:
Утверждение 1. Статистика распределена по закону
Стьюдента с n-2 степенями свободы, здесь:
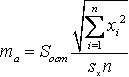 , (1.1.9)
представляет собой стандартную ошибку коэффициента a,
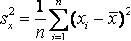 - выборочная дисперсия.
Утверждение 2. Статистика распределена по закону
Стьюдента с n-2 степенями свободы, здесь:
 , (1.1.10)
представляет собой стандартную ошибку коэффициента b,
- выборочная дисперсия.
Утверждение 3. Если y и x некоррелированы, то
статистика:
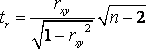 (1.1.11)
распределена по закону Стьюдента с n-2 степенями
свободы. Здесь r
(x,y) - теоретический коэффициент парной корреляции, rxy- выборочный
коэффициент парной корреляции:
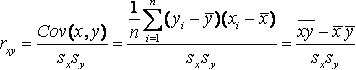 , (1.1.12)
где , 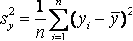 - выборочные дисперсии x и y соответственно, Cov(x,y)-
выборочная ковариация между x и y.
1.2 Показатели качества регрессии
Коэффициент детерминации является одной из наиболее эффективных оценок адекватности регрессионной модели, т. е. мерой качества уравнения регрессии (соответствия регрессионной модели эмпирическим данным).
После построения выборочного уравнения регрессии, как уже указывалось выше, значение зависимой переменной y в каждом наблюдении можно разложить на две составляющие:
i=`yi+ei, i=`1,n,
здесь остаток ei представляет собой ту
часть зависимой переменной y, которую невозможно «объяснить» с помощью
выборочной регрессии. Можно показать, что выборочная дисперсия наблюдений yi
может быть представлена в виде суммы:
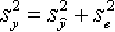 , (1.2.1)
в которой первое слагаемое 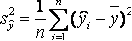 представляет собой часть,
«объясненную» регрессионным уравнением (или обусловленную регрессией), а второе
слагаемое
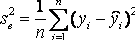 - «необъясненную» часть, характеризующую влияние неучтенных
факторов и т. п. Необходимо заметить, что такое разложение справедливо только в
том случае, когда в уравнение регрессии включена константа a, при этом
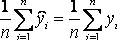 .
Разложение (1.2.1) часто записываю в следующем виде:
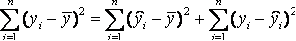 , (1.2.2)
где  представляет собой общую сумму квадратов отклонений зависимой
переменной от средней,
 есть сумма квадратов отклонений, обусловленная регрессией, а
 - остаточная сумма квадратов.
Коэффициент детерминации определяется по формуле:
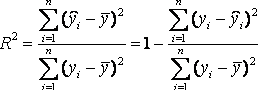 . (1.2.3)
Величина R2, как видно из формул (1) и (3), представляет собой часть (долю) вариации (разброса, дисперсии) зависимой переменной, обусловленную («объясненную») уравнением регрессии (иногда говорят - обусловленную вариацией объясняющей переменной).
Свойства коэффициента детерминации:
Свойство 1. 0 £R2£ 1;
Свойство 2. Чем ближе R2 к единице, тем лучше регрессия аппроксимирует эмпирические данные, т. е. эмпирические наблюдения ближе к линии выборочной регрессии. Если R2,=1 то между x и y есть линейная функциональная зависимость, в этом случае все эмпирические точки наблюдений лежат на прямой регрессии;
Заметим, что коэффициент детерминации R2 имеет смысл рассматривать только при наличии свободного члена в уравнении регрессии, так как лишь в этом случае справедливо равенство (1.2.1).
Оценка качества соответствия выборочного равнения
регрессии наблюдаемым данным может производиться и с помощью средней ошибки
аппроксимации регрессии по формуле:
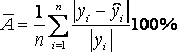 . (1.2.4)
Как указывают некоторые авторы, в практических исследованиях значение этой ошибки в пределах 5-7 % свидетельствует о хорошем соответствии модели эмпирическим данным.
Коэффициент регрессии b, как уже отмечалось выше, показывает, на сколько единиц в среднем изменяется значение показателя y, когда фактор x увеличивается на одну единицу, поэтому он также может служить мерой тесноты связи между x и y. Однако b зависит от единиц измерения переменных. Именно поэтому удобно использовать некоторую «стандартную» систему единиц измерения тесноты связи, в которой различные данные были бы сравнимы между собой. В качестве единиц измерения такой системы используется среднее квадратическое отклонение переменных, а показателем тесноты связи служит коэффициент корреляции.
Действительно, используя понятия выборочных дисперсий,
ковариации и корреляции, оценки МНК можно записать специальным образом:
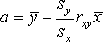 ,
 ,(1.2.5)
где  ,
 - выборочные средние, ,
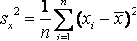 - выборочные дисперсии, rxy -
выборочный коэффициент корреляции (см. (1.2.5)).
Следовательно, парная эмпирическая линейная регрессия
может быть записана в виде:
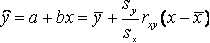 . (1.2.6)
Таким образом, величина
 (1.2.7)
показывает, на сколько величин Sy изменится (в среднем) y, если x увеличится на одно sx, поэтому выборочный коэффициент корреляции rxy также является показателем тесноты связи (более точно - характеризует тесноту линейной зависимости) между переменными.
Выборочный коэффициент корреляции является безразмерной величиной и обладает следующими свойствами:
Свойство 1. -1£ rxy £1;
Свойство 2. При rxy = ± 1 корреляционная зависимость представляет собой линейную функциональную зависимость (все наблюдаемые значения располагаются на прямой линии регрессии);
Свойство 3. При rxy = 0 линейная корреляционная связь отсутствует (линия регрессии параллельна оси Ox).
Заметим, что выборочный коэффициент корреляции rxy полностью оценивает тесноту связи только в случае совместного нормального распределения случайных величин x и y, в других случаях выборочный коэффициент корреляции является оценкой меры только линейной зависимости.
Практически наиболее удобна следующая формула
вычисления rxy (которая непосредственно может быть получена из
определения):
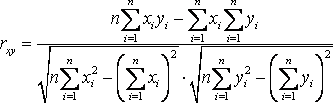 (1.2.8)
В случае парной линейной регрессии между коэффициентом детерминации R2и коэффициентом корреляции rxy существует следующая связь:
2 = r2xy. (1.2.9)
2. Проверка статистической значимости
в парной линейной регрессии
Проверка значимости (статистической) уравнения регрессии означает проверку соответствия модели, выражающей зависимость между переменными, экспериментальным данным, а также проверку достаточности включенных в уравнение объясняющих переменных для описания зависимой переменной.
Правило проверки статистической значимости оценок a и b основывается на статистических свойствах оценок МНК и проверке статистических гипотез H0: a=0, H1: a¹0 и H0: b=0, H1: b¹0. Невозможность отклонения нулевой гипотезы означает статистическую незначимость соответствующего коэффициента и наоборот, отклонение нулевой гипотезы по сравнению с альтернативной означает, что соответствующий коэффициент статистически значим.
Как всегда, проверка статистических гипотез осуществляется при некотором уровне значимости. В практических эконометрических исследованиях наиболее часто используются 5 и 1 %-ный уровни значимости. Выбор того или иного уровня значимости определяется исследователем.
Напомним, что если нулевая гипотеза отклоняется при 1 %-ном уровне значимости, то она автоматически отклоняется и при 5 %-ном уровне.
Если нулевая гипотеза принимается при 5 %-ном уровне значимости, то она принимается и при 1 %-ном уровне.
Если же при 5 %-ном уровне значимости нулевая гипотеза отклоняется, то необходимо проверить ее при 1 %-ном уровне, и если при этом уровне она принимается, то результаты проверки гипотезы приводятся для двух уровней значимости.
. Правило проверки значимости коэффициента b
Статистика tb=b/mb при выполнении гипотезы H0:b=0 распределена по закону Стьюдента с n-2 степенями свободы.
Из таблицы распределения Стьюдента с n-2 степенями свободы по заданному уровню значимости выбирается значение t как критическая точка, соответствующая двусторонней критической области. Тогда:
) если | tb | ≥ t, то гипотезу H0:b=0 следует отклонить и, следовательно, признать коэффициент b статистически значимым;
) если | tb | £ t, то гипотезу H0:b=0 следует принять и, следовательно, признать коэффициент b статистически незначимым.
. Правило проверки значимости коэффициента a
Статистика ta=a/ma при выполнении гипотезы H0:a=0 распределена по закону Стьюдента с n-2 степенями свободы.
Из таблицы распределения Стьюдента с n-2 степенями свободы по заданному уровню значимости выбирается значение t как критическая точка, соответствующая двусторонней критической области. Тогда:
) если | ta | ≥ t, то гипотезу H0:a=0 следует отклонить и, следовательно, признать коэффициент a статистически значимым;
) если | ta | £ t, то гипотезу H0:a=0 следует принять и, следовательно, признать коэффициент a статистически незначимым.
. Правило проверки значимости коэффициента корреляции rxy
Статистика 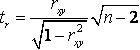 при выполнении гипотезы H0:
rxy =0 (т. е. при отсутствии корреляционной связи, здесь -
генеральный коэффициент корреляции) распределена по закону Стьюдента с n-2
степенями свободы.
Из таблицы распределения Стьюдента с n-2 степенями свободы по заданному уровню значимости выбирается значение t как критическая точка, соответствующая двусторонней критической области. Тогда: