Материал: Уч_пос_АрхКомп_2017
П2. Краткое введение в программирование на языке Ассемблера
Ассемблер – машинно-ориентированный язык, предназначенный для написания программ, наиболее эффективных по времени и потреблению ресурсов, или обеспечивающих расширенные функциональные возможности по использованию ресурсов, недоступные из языков высокого уровня. Обычно он используется для написания относительно коротких программ или фрагментов кода, включаемых в программы на языках высокого уровня.
Особенностями ассемблера по сравнению с языком машинных команд являются:
-
символическое наименование операций и операндов;
-
отсутствие привязки к конкретным адресам памяти;
-
возможность специализации программ с помощью макросредств.
Процесс подготовки, трансляции и выполнения ассемблерной программы можно пояснить с помощью схемы, приведенной на рис. П2.1.
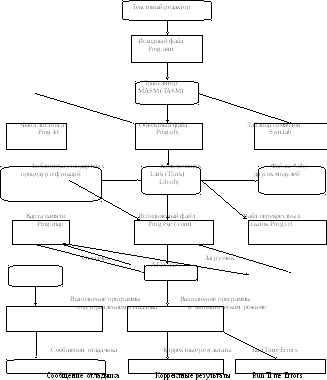
Рис. П2.1
Дальнейшее изложение ориентировано на использование ассемблеров Intel 80X86 – MASM и TASM.
П2.1 Формат оператора ассемблера
В ассемблере различают два вида форматов:
-
формат исполняемого оператора имеет вид
[метка:] операция операнд(ы)] [ ; комментарий]
-
формат директивы имеет вид
[имя] директива [аргумент(ы)] [ ; комментарий]
Указанные поля форматов имеют следующий смысл:
- метка/имя символически задает адрес данной команды в исполняемом файле /адрес директивы в исходном тексте;
- операция символически задает дейстие, выполняемое над операндами при выполнении программы;
- директива символически задает действие, выполняемое над аргументами при трансляции программы и генерации объектного файла.
- операнды – имена, числа, символы, участвующие в операции (может быть 0/1/2 операнда);
- аргументы – имена, числа, символы, используемые в директиве (число аргументов не ограничено);
- комментарий – пояснение к тексту программы, при трансляции не рассматривается.
Директива (иногда называется псевдокоманда) ассемблера выполняется на этапе трансляции исходного текста программы в объектный файл, исполняемых машинных команд не порождает.
Исполняемый оператор в процессе трансляции исходного текста порождает машинные команды, которые выполняются на этапе выполнения программы.
П2.2. Директивы ассемблера
1. Директивы задания данных
1.1. Директивы определения имен
а) идентификатор EQU выражение
Позволяет символически именовать константы в программе.
Например
N EQU 100h
TABLE EQU DS:[BP][SI]
MINS_DAY EQU 60*24
b) идентификатор = выражение
Позволяет символически именовать переопределяемые в программе константы. Используется только для числовых выражений.
1.2. Директивы выделения памяти
Имеет формат:
идентификатор D* список значений
Здесь D* - одна из приведенных ниже директив:
DB – выделить байты;
DW – выделить слова;
DD – выделить двойные слова;
DF – выделить блоки по шесть байт;
DQ – выделить учетверенные слова;
DT – выделить блоки по десять байт.
Данная директива позволяет зарезервировать в памяти блоки заданного размера и присвоить им, если требуется, определенные значения, заданные в списке. Например:
text_string db ‘Hello world’ ; выделяет 11 байт и заполняет их кодами символов
b_max db 255 ; выделяет 1 байт и записывает в него число 255
b_min db -128 ; выделяет 1 байт и записывает в него число –128
rez_w dw ? ; выделяет 1 слово и не заполняет его (обычно ; используется в программе для записи результата)
rez_tab dw 20dup(?) ; выделяет 20 слов, но не заполняет их данными
b_tab db 4dup(?),8,5,4dup(1); выделяет 10 байт: 4 не заполняются, затем
; записываются числа 8, 5 и четыре раза по 1
fl_num dd 5.03E-2 ; выделяется двойное слово и в него записывается
; число с плавающей запятой 5.0Е-2.
2. Директивы сегментации программы
Два способа задания сегментов в программе.
Полное описание сегментов
имя_сегмента SEGMENT атрибуты
тело сегмента
имя_сегмента ENDS
Пример
dat_s1 segment byte public ‘data’
a db ?
dat_s1 ends
Атрибуты:
-
ReadOnly – сегмент доступен только для чтения; при попытки записи в этот сегмент MASM выдаст сообщение об ошибке.
-
Атрибут выравнивания – указывает ассемблеру и компоновщику, с какого адреса может начинаться сегмент.
BYTE – с любого адреса.
WORD – с четного адреса.
DWORD – с адреса, кратного 4.
PARA – с адреса, кратного 16 (установлен по умолчанию).
PAGE – с адреса, кратного 256.
-
Атрибут группирования, комбинирования.
PUBLIC- конкатенация (присоединение частей сегментов друг к другу).
COMMON – размещение сегментов данного класса с одного адреса (для сегментов кода и оверлейных программ).
PRIVATE – сегмент с таким атрибутом не объединяется с другими сегментами (значение по умолчанию).
-
Атрибут типа данных.
USE16 – сегмент работает с 16-битными данными.
USE32 – сегмент работает с 32-битными данными.
-
Атрибут класса – это любая метка, взятая в одинарные кавычки. Этот атрибут влияет на расположение сегментов в скомпонованной программе.
Связь сегментов с соответствующими сегментным регистром.
ASSUME {регистр_сегментный: имя_сегмента,…}
Обычно эта директива идет вслед за сегментом кода.
Пример
assume cs: code_s, ds: d_seg,
ss: stack, es: nothing
NOTHING – не устанавливать связь или отменить ее, если она была установлена.
Загрузка начальных адресов сегментов в соответствующие регистры.
mov ax, seg d_seg ; seg- необязательный оператор
mov ds, ax
3. Директивы группирования.
GROUP имя_сегмента1, имя_сегмента2,…
Все перечисленные сегменты относятся к одной группе и могут адресоваться относительно одного регистра (обычно в одну группу объединяют сегменты одного назначения, например, data и stack).
Сокращенное описание сегментов.
При таком описании требуется обязательное задание модели памяти, в условиях которой используется данная программа.
.MODEL тип_модели_памяти
Эта директива накладывает ограничения на комбинирование сегментов (таблица).
|
Модель |
Тип доступа к коду |
Тип доступа к данным |
Сегментные регистры |
Примечания |
|
TINY |
Near |
Near |
(cs)=DGroup (ds)=(ss)=DGroup |
.com |
|
SMALL |
Near |
Near |
(cs)=_Text (ds)=(ss)=DGroup |
.exe |
|
MEDIUM |
Far |
Near |
(cs)=<имя_сегмента>_Text (ds)=(ss)=DGroup |
|
|
LARGE |
Far |
Far |
(cs)=<имя_сегмента>_Text (ds)=(ss)=DGroup |
|
|
HUGE |
Far |
Far |
|
|
.CODE – директива описания сегмента кода; эта запись аналогична
_TEXT SEGMENT Word Public ‘CODE’
или
<имя_сегмента> _TEXT Word Public ‘CODE’
для модели памяти выше MEDIUM
.DATA
_DATA SEGMENT Word Public ‘DATA’
.STACK
STACK SEGMENT Para Public ‘STACK’
.CONST
CONST SEGMENT Word Public ‘CONST’
.DATA?
_BSS SEGMENT Word Public ‘BBS’
Отличие от полного описания сегментов заключается в отсутствии директивы ENDS. Таким образом, в результате создаются предопределенные переменные, которые содержат начальные адреса сегментов: @Code, @Data, @Stack, @Const, @BBS. Следовательно, можно написать:
mov ax, @data
mov ds, ax