Курсовая работа (т): Вероятностно-статистический анализ продаж автомобилей BMW
Статистические функции.
КОРЕЛЛ - связь между двумя множествами данных. Данная функция позволяет рассчитать коэффициент корреляции между двумя интервалами ячеек. Коэффициент корреляции обычно используется для определения взаимосвязи между двумя свойствами объекта. КОРЕЛЛ (массив1;массив2) где массив1 - первый интервал ячеек; массив2 - второй интервал ячеек. Аргументы должны быть числами или именами, массивами или ссылками, содержащими числа. Если аргумент, который является массивом или ссылкой, содержит тексты, логические значения или пустые ячейки, то такие значения игнорируются; однако ячейки с нулевыми значениями учитываются. Функция КОРЕЛЛ выдает значение ошибки #Н/Д в том случае, если массив1 и массив2 имеют различное количество данных и значение ошибки #ДЕЛ/0! в том случае, если массив1 или массив2 пуст, или, если отклонение их значений равно нулю. Пример. КОРЕЛЛ({3;2;4;5;6};{9,7,12,15,17} равняется 0,997054. МАКС - максимальное значение из списка чисел. Позволяет рассчитать наибольшую величину из набора числовых значений. МАКС(число1;число2;…) где число1, число2,… - до 30 чисел, среди которых ищется максимальное значение. Можно задавать аргументы, которые являются числами, пустыми ячейками, логическими значениями или текстовыми представлениями чисел. Аргументы, которые являются значениями ошибки или текстами, не преобразуемыми в числа, вызывают ошибку. Если аргумент является массивом или ссылкой, то в нем учитываются только числа. Пустые ячейки, логические значения или текст в массиве или ссылке игнорируются. Если логические значения или текст не должны игнорироваться, следует использовать функцию МАКСА. Пример. Определить максимальное значение, если ячейки А1:А5 содержат числа 12,5,6,29 и 3. МАКС(А1:А5) равняется 29. МАКСА (А1:А5;40) равняется 40. Если аргументы не содержат чисел, то функция МАКС выдает 0 (ноль). СРЗНАЧ - среднее арифметическое. Позволяет рассчитать среднее (арифметическое) двух чисел. СРЗНАЧ (число1;число2;…) где число1, число2,… - до 30 аргументов, для которых вычисляется среднее арифметическое. Аргументы должны быть числами или именами, массивами или ссылками, содержащими числа. Если аргумент, который является массивом или ссылкой, содержит тексты, логические значения или пустые ячейки, то такие значения игнорируются; однако, ячейки, которые содержат нулевые значения, учитываются. Вычисляя средние значения ячеек, следует учитывать различие между пустыми ячейками и ячейками, содержащими нулевые значения, особенно если не установлен флажок Нулевые Значения на панели Вид в диалоговом окне Параметры. Пустые ячейки не учитываются, но нулевые ячейки учитываются. Чтобы открыть диалоговое окно Параметры, надо выбрать команду Параметры в меню Сервис. Пример: Пусть ячейки А1:А5 имеют имя Баллы и содержат числа 10, 7, 9, 27 и 2, тогда СРЗНАЧ(А1:А5) равняется 11 СРЗНАЧ(Баллы) равняется 11 СРЗНАЧ(А1:А5;5) равняется 10 СРЗНАЧ(А1:А5 равняется СУММ(А1:А5)/СЧЕТ(А1:А5) и равняется 11. МОДА - наиболее часто встречающееся значение. Функция позволяет рассчитать наиболее часто встречающееся или повторяющееся значение в массиве или интервале данных. МОДА(число1;число2;…) где число1, число2,… - до 30 аргументов, среди которых вычисляется наиболее часто встречающееся значение. Можно использовать массив или ссылку на массив вместо аргументов, разделяемых точкой с запятой. Аргументы должны быть числами, именами, массивами или ссылками, которые содержат числа. Если аргумент, который является массивом или ссылкой, содержит тексты, логические значения или пустые ячейки, то такие значения игнорируются; однако, ячейки, которые содержат нулевые значения, учитываются. Функция МОДА выдает значение ошибки #Н/Д! в том случае, если множество данных содержит не однотипные данные. Пример. МОДА({5;6;4;4;3;2;4}) равняется 4.
Выборка и анализ данных в Excel.
В Excel имеется набор инструментов для анализа данных, называемый пакет анализа, который может быть использован для решения статистических или экономических задач. Для использования одного из этих инструментов необходимо указать входные данные и выбрать параметры. Анализ будет проведен с помощью подходящей статистической или инженерной макрофункции, и результаты будут представлены в выходном диапазоне. Некоторые инструменты позволяют представить результаты анализа в графическом виде. Статистический пакет анализа данных. Для его установки в меню Сервис выбирается команда Надстройки и далее в списке Пакет анализа. Для использования инструментов анализа, анализируемые данные следует представить в виде строк или столбцов. Совокупность ячеек, содержащих эти данные, называется входным диапазоном. В меню Сервис выбирается команда Анализ данных. В списке Инструменты анализа выбирается необходимая строка. Далее вводятся входной и выходной диапазоны. Корреляционный анализ. Используется для количественной оценки взаимосвязи двух наборов данных, представленных в безразмерном виде. Корреляционный анализ дает возможность установить: ассоциированы ли наборы данных по величине, то есть, большие значения из одного набора данных связаны с большими значениями другого набора (положительная корреляция), или, наоборот, малые значения одного набора связаны с большими значениями другого (отрицательная корреляция), или данные двух диапазонов никак не связаны (корреляция близка к нулю). Для вычисления коэффициента корреляции между двумя наборами данных используется статистическая функция КОРЕЛ. Ковариационный анализ. Ковариация является мерой связи между двумя диапазонами данных. Используется для вычисления среднего произведения отклонений точек данных относительно средних.
Ковариационный анализ дает возможность
установить, ассоциированы ли наборы данных по величине, то есть, большие значения
из одного набора данных связаны с большими значениями другого набора
(положительная ковариация), или, наоборот, малые значения одного набора связаны
с большими значениями другого (отрицательная ковариация), или данные двух
диапазонов никак не связаны (ковариация близка к нулю). Вычисления ковариации
для отдельной пары данных производятся с помощью статистической функции КОВАР.
Экспоненциальное сглаживание. Предназначается для предсказания значения на
основе прогноза для предыдущего периода, скорректированного с учетом
погрешностей в этом прогнозе. Использует константу сглаживания, по величине
которой определяет, насколько сильно влияют погрешности на прогнозы в
предыдущем прогнозе. Скользящее среднее. Используется для расчета значений в
периоде прогнозирования на основе среднего значения переменной для указанного
числа предшествующих периодов. Скользящее среднее, в отличие от простого
среднего для всей выборки, содержит сведения о тенденциях изменения данных.
Процедура может использоваться для прогноза сбыта, инвентаризации и других
процессов. Генерация случайных чисел. Используется для заполнения диапазона
случайными числами, извлеченными из одного или нескольких распределений. С
помощью данной процедуры можно моделировать объекты, имеющие случайную природу,
по известному распределению вероятностей. Например, можно использовать
нормальное распределение для моделирования совокупности данных по
арифметическим ошибкам в бухгалтерском учете. Чтобы в результате выполнения
вычислений вернуть равномерно распределенное случайное число, большее или
равное 0 и меньшее 1, используется функция СЛЧИС(). Чтобы вернуть случайное
число, лежащее между произвольными заданными значениями, используется функция
СЛУЧМЕЖДУ(). Ранг и персентиль. Используется для вывода таблицы, содержащей
порядковый и процентный ранги для каждого значения в наборе данных. Данная
процедура может быть применена для анализа относительного взаимораспределения
данных в наборе. Регрессия. Линейный регрессионный анализ заключается в подборе
графика для набора наблюдений с помощью метода наименьших квадратов. Регрессия
используется для анализа воздействия на отдельную зависимую переменную значений
одной или более независимых переменных. Например, на объем реализации влияют
несколько факторов, включая цену, выпуск и сезонность. Регрессия
пропорционально распределяет меру реализации по этим трем факторам на основе
данных функционирования организации. Результаты регрессии впоследствии могут
быть использованы для предсказания объема реализации. Выборка. Создает выборку
из генеральной совокупности, рассматривая входной диапазон как генеральную
совокупность. Если совокупность слишком велика для обработки или построения
диаграммы, можно использовать представительную выборку. Кроме того, если
предполагается периодичность входных данных, то можно создать выборку,
содержащую значения только из отдельной части цикла. Например, если входной
диапазон содержит данные для квартальных продаж, создание выборки с периодом 4
разместит в выходном диапазоне значения продаж из одного и того же квартала.
2. Практическое решение задач
математической статистики на ЭВМ
В качестве данных (выборки) взяли значения количества продаж автомобилей BMW в 50 автосалонах Российской Федерации.
Провели исследование выборки в MathCad и MS
Excel.
2.1 MathCad
Ввод исходных данных:= 1
:= 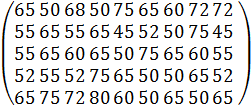
Первичная обработка выборки:
Xmin:= min (A) Xmax:= max(A) R:= Xmax - Xmin
Xmin = 45 Xmax = 80 R = 35
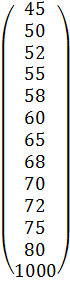
Вариационный ряд
А1:= 
X:= stack ( 1
1
45
2
50
3
50
4
50
5
50
6
50
7
50
8
50
9
50
10
50
11
52
12
52
13
52
14
52
15
55 55
17
55
18
…
1
1
72
2
72
3
65
4
68
5
50
6
75
7
65
8
60
9
50
10
65
11
58
12
75
13
52
14
55
15
65
16
45
17
52
18
…
Построение статистического ряда распределения
1
1
1
2
9
3
4
4
4
5
1
6
5
7
13
8
1
9
1
10
3
11
6
12
2
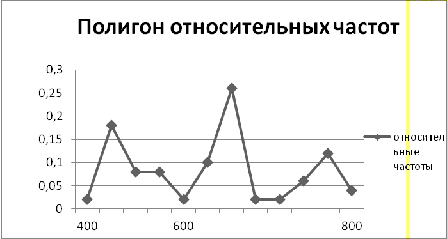
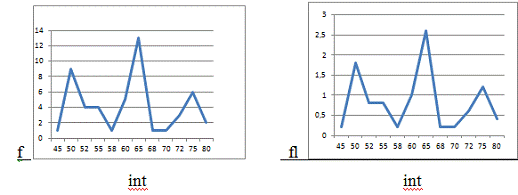
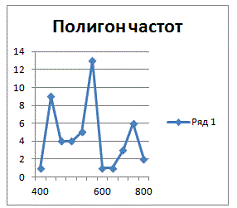
Int:= Построение полигона частот и относительных
частот
Рис. 1
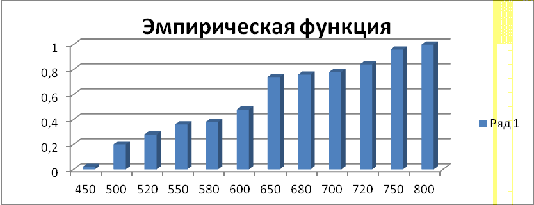
Построение эмпирической функции распределения
:= 1 .. 12
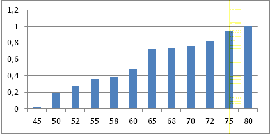
Рис. 2
График эмпирической функции
распределения
Вычисление числовых характеристик
выборки:
в:= mean(X) xв = 61,8 выборочная
средняя
Ме:= median(X) Ме = 65 медиана
Мо:= mode(X) Mo = 65 модав:= var(X)
Dв = 8,788 Вычисление интервальных оценок
% доверительный интервал для
математического ожидания при неизвестной дисперсии:
t:= qt l:= (xl % доверительный интервал для дисперсии:
2.2. MS Excel
Исходные данные: Количество продаж автомобилей
BMW(шт.)
65
50
60
65
75
50
68
65
72
72
55
65
50
52
45
65
55
52
75
58
55
65
65
75
50
65
60
65
60
50
52
55
50
50
65
75
52
80
65
60
65
75
65
50
60
80 70
50
75
n=
50
max=
80
min=
45
R=
35
статистическое распределение частот и
относительных частот
Вариант
а
Частота
ni
Относительная
Накопленная
45
50 52 55 58 60 65 68 70 72 75 80
1
9 4 4 1 5 13 1 1 3 6 2
0,02
0,18 0,08 0,08 0,02 0,1 0,26 0,02 0,02 0,06 0,12 0,04
0,02
0,2 0,28 0,36 0,38 0,48 0,74 0,76 0,78 0,84 0,96 1
выборочная средняя хв= 61,8,
выборочная дисперсия Dв= 8788,
исправленная выборочная дисперсия s2= 8967,35,
среднее квадратическое отклонение исправленное среднее кв. отклонение s= 9,469,
мода Мо= 65 медиана Ме= 65,
интервальная оценка для математического
ожидания:
доверительный уровень: 0,95,
доверительный интервал: 26,912,
нижняя граница: 59,108 t= 2,00958,
верхняя граница: 64,491,
интервальная оценка для дисперсии:
доверительный уровень: 0,95
Рис. 3
нижняя граница: 6257,26
верхняя граница: 13924,9
Рис. 4
Рис. 5
Результаты
описательной статистики:
Среднее
618 Стандартная ошибка 13,39205 Медиана 650 Мода 650 Стандартное отклонение
94,69608 Дисперсия выборки 8967,347 Эксцесс -1,06632 Ассиметричность 0,140713
Интервал 350 Минимум 450 Максимум 800 Сумма 30900 Счет 50 Наибольший(1) 800
Наименьший(1) 450 Уровень надежности(95,0%) 26,91233
Заключение
В данной курсовой работе рассмотрены основные
понятия математической статистики и проведено исследование выборки 50 значений
количества продаж автомобилей BMW.
Расчеты основных характеристик проводились в
среде MathCad и MS Excel.
По результатам исследования получены следующие
значения:
размах варьирования количества продаж автомобилей
BMW равен 35 шт.;
среднее количество проданных автомобилей BMW в
Российской Федерации составляет 61,8 шт.;
разброс количества продаж автомобилей BMW вокруг
средней стоимости составляет 9,4 шт.;
коэффициент вариации равен 15,17%, отсюда
следует, что рассматриваемая совокупность однородная;
с надежностью 0,95 интервал (покрывает
математическое ожидание количества продаж автомобилей BMW;
с надежностью 0,95 интервал покрывает дисперсию
количества продаж автомобилей BMW.
Литература
1. Плис
А.И. Статистические вычисления в среде Excel. Библиотека пользователя. - СПб.:
Питер, 2011.-608с.
2. Справочник
по математике для экономистов / Под редакцией В.И. Ермакова. - Москва.: Высшая
школа, 2007. -486с.
. Дьяконов
В.П. Справочник по MATHCAD. - М.: СК Пресс. 2011. - 396 с.
. Гмурман
В.Е. Теория вероятностей и математическая статистика. - М.: Высш. Ш., 2009. -
479с.
 ,
 X:= sort(X)
 f:=
hist (int, X) f = (частоты)
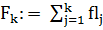 (накопленные
частоты)


 выборочная
дисперсия
 в:=
 в = 9,374
выборочное ср. кв. откл.:= (Stdev(X)
 s2 = 8,967

 исправ.
выборочная дисперсия:= Stedev(X) s = 94,696 исправ. выборочное сред. квад. отк.:=
skew As = 0.141 выборочный коэф. ассиметрии:= kurt Ek = -1.066 выборочный
эксцесс
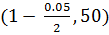 t = 2.009:=
xв
- t
 xl
=591.101:= xв
+ t xp =
644.899
 xp) l = (591.101
644.899)
 20:= qchisq
 ,
49) 20
= 31.555
21:= qchisq
 ,
49) 21=
70.222
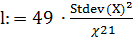 l = 6.257 :=
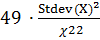 u
= 1.392
 :=
(1 u) II = (6.257
 1.392
)
 50 1 Числовые
характеристики выборки:
=
9,374,
 = 31,554
 = 70,2224