Материал: Влияние подкрепления и наказания на поведение
.4 Научение посредством подкрепления
Множество исследований фокусируются на процессах принятия решений, которые люди и животные употребляют при выборе действий перед лицом награды и наказания. Всё чаще анализ поведения на уровне вычислительных операций опирается на идеи обучения с подкреплением, которое обеспечивает удобную теоретическую основу в рамках которой процесс принятия решений может быть проанализирован.
Фундаментальный вопрос в поведенческой нейробиологии касается процессов принятия решений благодаря которым люди и животные выбирают действия перед лицом награды и наказания, и их нейронным осуществлением. В бихевиоризме этот вопрос был подробно исследован с помощью классической и оперантной парадигмы обуславливания. С их помощью было собрано множество данных, в отношении того, как ассоциации контролируют различные аспекты выученного поведения. Вычислительная сторона обучения с подкреплением обеспечила нормативную структуру, в рамках которой можно понять такое обучение. Здесь оптимальный выбор действий основан на прогнозах долгосрочных последствий, например, что принятие решения направлено на достижение максимальной выгоды и минимизации потерь.
Научные данные, полученные от нейрологии, физиологии, фармакологии, и т.д. о поведении животных позволили обозначить (предварительно) нервные структуры, лежащие в основе ключевых вычислительных конструкций в этих моделях. С вычислительной точки зрения Павловское обуславливание рассматривается как прототип - экземпляр обучения предсказанию - обучение построения прогностических связей между событиями в окружающей среде. Инструментальное обуславливание, с другой стороны, включает в себя обучение выбору действий, которые увеличат вероятность полезных событий, и уменьшат вероятность аверсивных событий. С математической точки зрения, такой процесс принятия решений рассматривается как попытка оптимизировать последствия действий со стороны долгосрочной перспективы, исчисляющиеся в общем количестве вознаграждений, и/или избегания наказания.
Научение посредством подкрепления (далее - НПП)
- это обучение посредством взаимодействия с окружающей средой. Субьект НПП
обучается благодаря обсервации последствий своих действий, вместо простого
эксплицитного обучения, субъект выбирает действия на основе прошлого опыта, и
новым выборам, которое по сути своей представляет метод проб и ошибок.
Различные модели предполагают разные механизмы увеличения ассоциативной связи.
В данной работе мы упомянем о двух из них. Первая из них - модель
Рескорлы-Вагнера является самой перспективной из всех математических моделей
обучения, которая уже неоднократно применялась в эмпирических исследованиях с
большим успехом. Р. Рескорла и А. Вагнер совместно разработали математическую
модель процесса обучения на основе теории подкрепления, с использованием
разностного уравнения. При этом они оперировали теоретической физиологической
переменной, названной ими "ассоциативная сила" и обозначенной через
V. Они предполагали, что после каждого сочетания условного и безусловного
раздражителей. Их предположение состояло в том, что после каждого сочетания
условного и безусловного раздражите лей новое значение изменяется ассоциативной
силы Vnew и равно предшествующему значению, плюс прирост "ассоциативной
силы" ∆V за счет сочетания условного и безусловного раздражителей.
Иными словами: 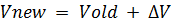 . Они
постулировали, что
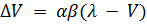 , где V - текущее
значение ассоциативной силы; α - относительная
сила влияния условного раздражителя, варьирующаяся между 0 и 1; λ
- максимум
ассоциативной силы; β - относительная
сила влияния безусловного раздражителя, также варьирующая между 0 и 1.При
эмпирических расчетах по этой формуле необходимо задать начальное значение V0,
значения α, β и λ.
Тогда
после первого сочетания условного и безусловного раздражителей
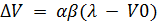 и
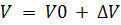 .
Аналогичноiвычисляется значение "ассоциативной силы" при каждом из
следующих сочетаний условного раздражителя и безусловного раздражителя.
Особенно важным в этой модели является тот факт, что авторы допускали ненулевое
начальное значение "ассоциативной силы" V0. В рамках данного
исследования не предполагается адаптация этой модели поведения на полученных
результатах, и их сравнение, по нескольким причинам. Первая - полученные
результаты, какими бы они ни были не могут считаться валидными из-за репрезентативности
выборки. Вторая - адаптация модели, с учётом имеющихся данных потребует
использования специального программного обеспечения, использующегося в
математических вычислениях, иначе - сложность задачи далеко выходит за рамки
возможностей исследователя.
Тем не менее, в рамках данной работы возможен
анализ одной из математических моделей, адаптация под решения которых не
требует больших вычислительных мощностей. Это модель "win-stay,
lose-switch", успешно применявшаяся при решении проблем, связанных с
"игровыми автоматами", "дилеммой заключённого" и др. Модель
утверждает, что выбор следующего действия зависит только от исхода предыдущего
акта поведения. Исходы подразделяются на успешные (награды) и неудачные
(наказания). Если поведение в предыдущем раунде было подкреплено, тогда субъект
повторяет стратегию поведения, если поведение было наказано - то субъект
переключается на другую стратегию поведения. Вероятность, с которой повторение
и изменение поведение будет происходить определяется двумя свободными
параметрами, Preward и Ppenalty. При адаптации метода со значением переменных
Preward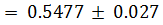 и
Ppenalty
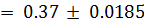 для
группы игроков, и Preward
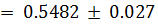 и Ppenalty
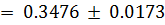 для
контрольной группы. Были получены результаты, приведённые в таблицах 5 и 6 в
приложении. Как можно увидеть, данная модель оказалась неспособной предсказать
реакции испытуемых, в первую очередь благодаря тому, что модель не учитывает
величину подкрепления и наказания.
Подводя итог, вычислительные модели обучения
многое сделали для улучшения нашего понимания процесса принятия решений за
последние несколько десятилетий благодаря своей способности к предсказанию
поведения. Совершенствование математических моделей обучения с подкреплением
продолжается до сих пор, и продолжится в будущем, как и изучение данного метода
исследования подкрепления и наказания.
Выводы
Применение общих правил к конкретному случаю
редко обходится без потерь, особенно в ситуациях, когда существует более чем
одна непредвиденная переменная. Большинство экспериментов в поведенческой
психологии предназначены для освещения одного, определённого явления, подобно
рентгену, просвечивающему кости руки. Кожа, мускулы в этом случае не видны, и в
результате картина будет являться неполной. Но даже видя только кости, мы
способны выдвинуть жизнеспособные предположения о том, как работает рука, её
возможности и ограничения. Принципы Бихевиоризма, обсуждаемые здесь должны
иметь схожие преимущества и ограничения. Существует огромное множество других
факторов, которые влияют на игроков, но базовые паттерны поведения и
математические модели формируют фундамент. Понимая фундаментальные
закономерности, которые лежат в основе игры, мы сможем сформировать более полно
не только модели подкрепления игр, мотивации игроков, но и более успешные
модели поведения и обучения.
Список использованной литературы
1. Thorndike E. L. Human learning. NY.: Century Company, 1931.
2. Cronbach Lee J. Essentials of Psychological Testing (Third Edition). NY.: Harper and Row, 1970
3. Kubanek. J., L. H. Snyder., R. A. Abrams. Reward and punishment act as distincs factors in guiding behavior // J. Kubanek. Elsevier Cognition. NY.: CrossMark, 2015.
4. Sharma, M., Ontañón, S., Mehta, M. and Ram, A. Drama Management and Player Modeling for Interactive Fiction Games. Computational Intelligence Journal, 26(2), 2010. р. 183-211.
5. Toma, C. L. Affirming the Self through Online Profiles: Beneficial Effects of Social Networking Sites. In Proceeding of CHI 2010, р. 1749-1752.
6. Walther, J. B. Selective self-presentation in computer-mediated communication: Hyperpersonal dimensions of technology, language, and cognition. Computers in Human Behavior, 2007.р. 1 - 23, 2538-2557.
7. Bates, B. Game Design: The Art & Business of Creating Games. Prima Publishing, Roseville, CA, 2001.
8. Kazdin, A.E. Behavior Modification in Applied Settings, Belmont, Brooks/Cole, 1989.
. Martin, G., Pear, J., Behavior Modification, New Jersey, Prentice Hall, 1992.
. Medler, B., John, M. and Lane, J. Data Cracker: Developing a Visual Game Analytic Tool for Analyzing Online Gameplay. In Proceedings of CHI 2011. Vancouver, BC Canada.
11. Few, S. Now You See It: Simple Visualization Techniques for Quantitative Analysis. Analytics Press, 2009.
12. Spence,
R. Information Visualization. ACM Press, 2001.Age and Sex Composition: 2010. [Электронный
ресурс] URL: #"898217.files/image023.gif">
Приложение 3
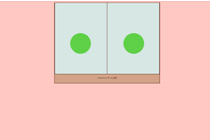
Образец того, как выглядела проба типа 3.
Приложение 4
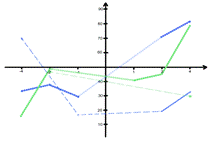
График наглядного представления результатов
методики одним из испытуемых. В случае, если какая либо из величин исхода пробы
не повторялась более 7 раз, результаты её влияния на поведение не учитывались. На
графике это выражено пунктирными линиями. Линия обозначенная синими кругами
представляет результаты задания №1, с зелёными - задания №2, сплошная синяя
линия - задания №3, сплошная зелёная - задания №4.
Результаты прохождения методик.
Опросник Эллерса для оценки мотивации избегания неудач: 19 баллов, умерено высокий уровень мотивации избегания неудач.
Опросник Эллерса для оценки мотивации к успеху: 18 баллов, умеренно высокий уровень мотивации к успеху.
Опросник Шуберта для оценки готовности к риску:
25 баллов,
Приложение 5
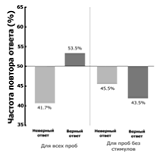
График общего представления результатов методики, без учётов типов задач и величин баллов, закреплёнными за заданиями.
Приложение 6
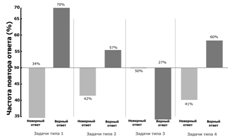
График представления результатов методики по каждому из типов заданий, без учёта величин баллов.