Материал: 00464
Алгоритм 2. Поиск гамильтоновых циклов
выбрать произвольно вершину

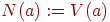
while
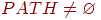 do
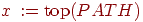
if
then взять

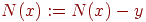
if вершина не находится в PATH
then
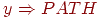
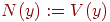
if PATH содержит все вершины
then if смежна с
then выдать цикл
else удалить вершину из PATH
Этот алгоритм очень похож на алгоритм поиска в глубину и отличается от него по существу только тем, что открытая вершина, когда вся ее окрестность исследована, не закрывается, а опять становится новой (исключается из стека). В начале все вершины новые. Процесс заканчивается, когда все вершины опять станут новыми. На самом деле это и есть поиск в глубину, только не в самом графе, а в дереве путей. Вершинами этого дерева являются всевозможные простые пути, начинающиеся в вершине , а ребро дерева соединяет два пути, один из которых получается из другого добавлением одной вершины в конце. На рис. 3.7 показаны граф и его дерево путей из вершины .
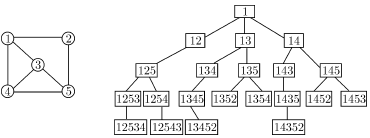
Рис. 3.7.
В
худшем случае время работы этого
алгоритма тоже растет с факториальной
скоростью. Например, для графа
 (граф
с двумя компонентами связности, одна
из которых - полный граф с
вершиной,
другая - изолированная вершина), если в
качестве стартовой выбрана не изолированная
вершина, то будут рассмотрены все
простых
путей длины
 в
большой компоненте. Вместе с тем, если
перед поиском гамильтонова цикла
исходный граф проверить на связность,
то ответ будет получен быстро. Можно
пойти дальше и при обходе дерева путей
поверять на связность каждый встречающийся
"остаточный граф", т.е. граф,
получающийся из исходного удалением
всех вершин рассматриваемого пути. Если
этот граф несвязен, то этот путь не может
быть продолжен до гамильтонова пути.
Поэтому можно не исследовать соответствующую
ветвь дерева, а вернуться к рассмотрению
более короткого пути, удалив последнюю
вершину (т.е. сделать "шаг назад" в
поиске в глубину). Можно пойти еще дальше
и заметить, что если некоторая вершина
DFS-дерева
с корнем
является
развилкой, т.е. имеет не менее двух
сыновей, то в подграфе исходного графа,
полученном удалением всех предков этой
вершины, кроме нее самой, она будет
шарниром. Поэтому путь от
до
в
DFS-дереве не может быть продолжен до
гамильтонова пути. Эти соображения
приводят к следующей модификации
алгоритма: обходим граф поиском в глубину
с построением DFS-дерева, затем находим
в этом дереве самую нижнюю развилку
(развилку с наименьшим глубинным
номером). Если ни одной развилки нет, то
само DFS-дерево представляет собой
гамильтонов путь и остается только
проверить наличие ребра, соединяющего
начало и конец пути. Если же
-
развилка, то возвращаемся из
в
предшествующую вершину пути, помечаем
все вершины, кроме собственных предков
вершины
,
как непосещенные и возобновляем поиск
в глубину с этого места.
Рассмотрим другой алгоритм, выясняющий существование гамильтонова цикла, по сути близкий к поиску в ширину и имеющий не столь быстро (хотя все же быстро) растущую оценку трудоемкости.
Пусть
граф
задан
матрицей смежности
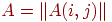 .
Выберем произвольно стартовую вершину
и
определим для каждого
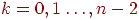 функцию
 ,
где значениями переменной
являются
вершины, отличные от
,
а значениями переменной
 -
-элементные
подмножества множества
 ,
причем вершина
не
должна принадлежать множеству
.
Эти функции определяются так: полагаем
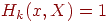 ,
если существует простой путь длины
 из
вершины
в
вершину
,
проходящий только через вершины из
множества
,
и
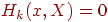 ,
если такого пути не существует. Тогда
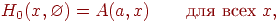
а
для

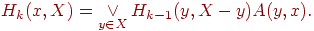
Таким
образом, зная все значения функции
 ,
мы можем вычислить все значения функции
 ,
причем для вычисления одного значения
требуется выполнить
 логических
операций. Общее количество логических
операций для вычисления всех этих
функций составит
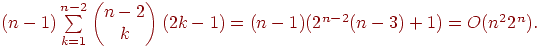
После
того, как будет вычислена функция
 ,
останется только для всех
,
для которых
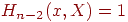 (
в этом случае определяется однозначно),
выяснить, чему равно
 -
если хотя бы в одном случае это 1, то
гамильтонов цикл существует. Очевидный
недостаток данного алгоритма -
необходимость хранения большого
количества промежуточной информации.
Тема 2. Алгоритмы комбинаторного перебора (6 часов).
План лекций.
1. Базовые комбинаторные объекты.
Размещения. Размещения с повторениями. Перестановки. Методы генерации. Подмножества. Разбиения.
2. Коды Грея.
Понятие кодов Грея. Построение кодов Грея. Применения кодов Грея.
3. Применение методов комбинаторного перебора.
Числа Каталана. Расстановка скобок. Подсчет количеств. Комбинаторные методы в олимпиадных задачах.
Лекция 4. Базовые комбинаторные объекты.
Размещения с повторениями
Напечатать все последовательности длины k из чисел 1..n.
Решение. Будем печатать их в лексикографическом порядке (последовательность a предшествует последовательности b, если для некоторого s их начальные отрезки длины s равны, а (s+1) -ый член последовательности a меньше). Первой будет последовательность <1,1,...,1>, последней - последовательность <n,n,...,n>. Будем хранить последнюю напечатанную последовательность в массиве x[1]..x[k].
...x[1]...x[k] положить равными 1
...напечатать x
...last[1]...last[k] положить равным n
{напечатаны все до x включительно}
while x <> last do begin
| ...x := следующая за x последовательность
| ...напечатать x
end;
Опишем, как можно перейти от x к следующей последовательности. Согласно определению, у следующей последовательности первые s членов должны быть такими же, а (s+1) -ый - больше. Это возможно, если x[s+1] меньше n. Среди таких s нужно выбрать наибольшее (иначе полученная последовательность не будет непосредственно следующей). Соответствующее x[s+1] нужно увеличить на 1. Итак, надо, двигаясь с конца последовательности, найти самый правый член, меньший n (он найдется, т.к по предположению x<>last ), увеличить его на 1, а идущие за ним члены положить равными 1.
p:=k;
while not (x[p] < n) do begin
| p := p-1;
end;
{x[p] < n, x[p+1] =...= x[k] = n}
x[p] := x[p] + 1;
for i := p+1 to k do begin
| x[i]:=1;
end;
Замечание. Если членами последовательности считать числа не от 1 до n, а от 0 до n-1, то переход к следующему соответствует прибавлению единицы в n -ичной системе счисления.
В предложенном алгоритме используется сравнение двух массивов ( x <> last ). Устранить его, добавив булевскую переменную l и включив в инвариант соотношение
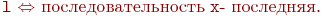
Напечатать все подмножества множества {1...k}.
Решение. Подмножества находятся во взаимно однозначном соответствии с последовательностями нулей и единиц длины k.
Напечатать все последовательности положительных целых чисел длины k, у которых i -ый член не превосходит i.
Перестановки
Напечатать все перестановки чисел 1..n (то есть последовательности длины n, в которые каждое из этих чисел входит по одному разу).
Решение.
Перестановки
будем хранить в массиве x[1]..x[n]
и печатать в лексикографическом порядке.
(Первой при этом будет перестановка
 ,
последней -
 .
Для составления алгоритма перехода к
следующей перестановке
зададимся вопросом: в каком случае k
-ый член перестановки
можно увеличить, не меняя предыдущих?
Ответ: если он меньше какого-либо из
следующих членов (т.е. членов с номерами
больше k
). Мы должны найти наибольшее k,
при котором это так, т.е. такое k,
что
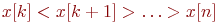
После этого значение x[k] нужно увеличить минимальным возможным способом, т.е. найти среди x[k+1]..x[n] наименьшее число, большее его. Поменяв x[k] с ним, остается расположить числа с номерами k+1..n так, чтобы перестановка была наименьшей, т.е. в возрастающем порядке. Это облегчается тем, что они уже расположены в убывающем порядке.
Алгоритм перехода к следующей перестановке:
{<x[1]...x[n]> <> <n...2,1>}
k:=n-1;
{последовательность справа от k убывающая: x[k+1]>...>x[n]}
while x[k] > x[k+1] do begin
| k:=k-1;
end;
{x[k] < x[k+1] > ... > x[n]}
t:=k+1;
{t <=n, все члены отрезка x[k+1] > ... > x[t] больше x[k]}
while (t < n) and (x[t+1] > x[k]) do begin
| t:=t+1;
end;
{x[k+1] > ... > x[t] > x[k] > x[t+1] > ... > x[n]}
... обменять x[k] и x[t]
{x[k+1] > ... > x[n]}
... переставить участок x[k+1] ... x[n] в обратном порядке
Замечание. Программа имеет знакомый дефект: если t=n, то x[t+1] не определено.