Материал: 62_201
jsr-ia- |
|
ік |
* |
|
|
|
|
|
4 |
|
|
<]L |
|
Ьз |
|
|
|
||
|
|
л |
3 2 1 4 6 |
|
|
ИГ""«ч |
5» |
г) |
|
|
|
|
||
|
|
|
|
|
4
£-#3
5Л0 3 2 1 4 6 5 д)
Мал. 46 (продовження)
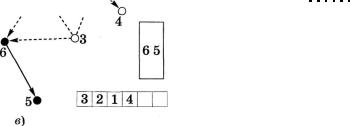
довність (мал. 46, г). Ми фактично завершили сортування. У нас залишилась одна вершина 5, яку необхідно дописати ос танньою в нашу результуючу послідовність (мал. 46, д).
Ми отримали результат, який відрізняється від попередньо го лише послідовністю деяких вершин, однак ніяким чином не порушує умову топологічного сортування.
Запропонований алгоритм є досить простим з точки зору його розуміння, однак складнішим з точки зору реалізації. Чим є наша вхідна інформація? Списком ребер заданого графа. А яким чином ми її коректували? Вилучали зі списку необхідні ребра. Тому для реалізації цього алгоритму необхідно викорис тати таку структуру даних як список і передбачити можливість вилучення з нього елементів.
Фрагмент програми, що є реалізацією запропонованого алго ритму, може бути таким:
read(f _ in, П, Пґі); |
{Введення кількості вершин і ребер графа.} |
new(q); р := q; |
{Визначення адреси початку списку ребер.} |
fo r і := 1 to m - 1 do {Заповнення списку початковою інформацією про ребра графа.}
begin
read(f_in, рл .і, p".j); {Введення номерів вхідної і вихідної вершини поточного ребра.} {Визначення адреси розміщення в пам'яті}
new(p A . next); |
{інформації про наступне ребро.} |
р := p".next; |
{Перехід до цієї адреси.} |
e n d ; |
|
read(f _ in, р p".j); p".next := nil; |
{Запис інформації про останнє ребро.} |
s : = [ 1 . . n ] ; |
{Множина всіх вершин графа.} |
|
{Сортування вершин графа, поки не будуть} |
87
w h i l e S <> [] do |
|
{переглянуті всі його вершини.} |
|
b e g i n |
|
|
|
s1 := s; p := q; |
|
{Початок перегляду елементів списку.} |
|
w h i l e p".next <> nil do |
|
{Поки список не переглянутий до кінця,} |
|
b e g i n |
|
|
|
s1 := s1 - [p" .j]; {вилучення номера вхідної вершини поточного ребра списку;} |
|||
р := p".next; |
|
{перехід до наступного ребра списку.} |
|
end; |
|
|
|
S := S - S1; |
{Визначення номерів вершин, відсутніх у списку як вхідних.} |
||
f o r і := 1 to n do |
{Перегляд усіх вершин графа і виведення тих,} |
||
if і in s1 t h e n write(f_OUt, І, ' '); |
{що визначені як відсутні вхідні.} |
||
р := q; |
|
|
{Перехід у початок списку.} |
|
|
|
{Перегляд елементів списку,} |
w h i l e p".next О nil do |
|
{поки не буде знайдено його кінець.} |
|
if рЛ.І in S1 |
{Якщо номер вихідної вершини був визначений як номер вхідної, то} |
||
t h e n |
|
|
|
b e g i n |
|
|
|
рл .І := p".next".i; |
|
{вилучити цей елемент зі списку.} |
|
p".j := |
p \ n e x t \ j ; |
|
|
if p".next <> nil |
|
{Якщо поточний елемент не є останнім,} |
|
t h e n p".next := рЛ .next".next |
{то перейти до адреси наступного,} |
||
else р := pA .next |
{у протилежному випадку визначити його адресу як nil.} |
||
end; |
|
|
|
e l s e р := p".next; |
{Якщо номер вихідної вершини не є номером вхідної,} |
||
e n d ; |
|
{то перейти до наступного елемента списку.} |
|
Для коректної роботи наведеного фрагмента програми необ хідно організувати опис таких змінних:
t y p e list= / 4list; {Динамічний список, що містить інформацію про ребра графа:}
tlist = record
і, j : b y t e ; |
{номер вихідної і вхідної вершин;} |
next:list |
{адресу інформації про наступне ребро.} |
end;
Цікаво порівняти обидва підходи до топологічного сортуван ня вершин ациклічного орієнтованого графа.
Упершому алгоритмі ми використали відомий базовий алго ритм пошуку в глибину, працювали з таблицею суміжності і кож ного разу переглядали всі ребра графа, відкидаючи ті з них, яким належать уже відвідані вершини. З одного боку, алгоритм досить наочний, зрозумілий, але з іншого, - виконує зайві дії. Однак при тій кількості вершин графа, що можна представити у вигляді таб лиці суміжності, на часі виконання це не позначиться.
Удругому алгоритмі ми весь час коректували список ребер графа, які вже переглянуті, виключаючи їх із цього списку. Якщо нам буде задано граф типу «зірочка», то даний алгоритм на першому ж кроці відкине всі ребра, у які входить вершина, що є центром цієї «зірочки», і алгоритм буде завершено. В алго ритмі ж з використанням пошуку в глибину нам доведеться
88
«гуляти» таблицею суміжності, переходячи в усі вершини, у які ведуть ребра з вершини, що є центром «зірочки». До речі, ще не відомо, як перенумеровані вершини: якщо центром «зірочки» не є вершина з номером 1, то довго будемо блукати таблицею суміжності, кожного разу потрапляючи в тупики.
Ще одна перевага другого алгоритму — він може опрацювати значно більший за кількістю вершин граф, особливо графи з великою кількістю ізольованих вершин. При цьому у вхідній інформації такі вершини будуть відсутні, оскільки вони не нале жать жодному ребру, а в таблиці суміжності їх необхідно враху вати. До єдиного недоліку другого алгоритму можна віднести не обхідність реалізації роботи з динамічним списком, що передба чає достатньо глибоке розуміння тих процесів, що відбуваються у пам'яті комп'ютера під час роботи безпосередньо з її адресами.
Оцінимо ефективність роботи обох розглянутих алгоритмів. Перший алгоритм базується на пошуку в глибину, тому його
оцінка становить 0(п + т).
Другий алгоритм пов'язаний з переглядом двох масивів вер шин графа: у другому масиві визначаються відсутні вершини, а в першому - виключення їх і відповідних їм вершин із друго го масиву. У кращому випадку на першому ж кроці буде пере глянуто два масиви вершин і виключено всі вершини. Оцінка такого варіанта становить О(п). У найгіршому випадку виклю чення вершин буде відбуватися по одній на кожному кроці алгоритму, що відповідає оцінці 0(п2). Середнє значення цих оцінок становитиме 0(п2/2).
Під час тестування задач, розв'язання яких базується на алгоритмі топологічного сортування, необхідно передбачити розгляд графів, які представляють собою як дерево з лінійною структурою, так і досить розгалужені дерева. На другому етапі тестування можна розглянути графи, які утворюють ліс. Ціка вим є тест, у якому два або більше дерев з'єднані між собою ребрами, яким належать нижні (або верхні) вершини цих де рев. Один з тестів може містити опис графа, який не є деревом. Це дасть змогу перевірити алгоритм на коректність введення початкових даних, оскільки топологічне сортування має сенс лише для графів, що не мають циклів.
Завдання
1.Розробити та реалізувати у вигляді програми алгоритм топо логічного сортування вершин заданого ациклічного орієнто ваного графа, використовуючи алгоритм пошуку в глибину.
2.Виконати завдання 1 для ациклічного орієнтованого графа з кількістю вершин N ^ 10. Результат виконання програми вивести у файл.
89
3.Виконати завдання 1 для ациклічного орієнтованого графа з кількістю вершин N = 100. Результат виконання програми вивести у файл.
4.Розробити та реалізувати у вигляді програми алгоритм топо логічного сортування вершин заданого ациклічного орієнто ваного графа, використовуючи структуру даних «список».
5.Виконати завдання 4 для ациклічного орієнтованого графа з кількістю вершин N ^ 10. Результат виконання програми вивести у файл.
6.Виконати завдання 4 для ациклічного орієнтованого графа з кількістю вершин N = 100. Результат виконання програми вивести у файл.
7. Зробити аналіз отриманих результатів.
/ |
|
Запитання для самоконтролю |
1.Що розуміється під топологічним сортуванням вершин заданого графа?
2.Для вершин яких графів існує поняття топологічного сортуван-
Іня? Наведіть приклади.
3.Як називаються графи, що не мають циклів?
4.На якому алгоритмі базується один з алгоритмів топологічного сортування? Обґрунтуйте коректність своєї відповіді.
5.Сформулюйте алгоритм топологічного сортування, що базуєть ся на повному обході вершин графа.
6.Виконайте попередньо описаний алгоритм покроково на конк ретному прикладі.
7.Запишіть фрагмент програми, що реалізує попередньо описа ний алгоритм.
8.Який ще можна запропонувати алгоритм топологічного сортуван ня? Яку вхідну інформацію про заданий граф він використовує?
9.На якій ідеї базується другий алгоритм топологічного сортування?
10.Обґрунтуйте коректність роботи другого алгоритму топологічного сортування на конкретному прикладі, виконавши його покроково.
11.Запишіть фрагмент програми, що реалізує другий алгоритм то пологічного сортування.
12.Порівняйте два варіанти алгоритмів топологічного сортування, відзначивши при цьому їх позитивні та негативні сторони.
Побудова остовного дерева
Давайте поміркуємо над такою задачею. У великому фрук товому саду, де росло багато екзотичних дерев, з давніх часів існувала зрошувальна система: до кожного дерева було прокла дено принаймні один рівчак, по якому постійно подавалася во да. Але ця система була недосконалою, оскільки під час посад ки кожного дерева рівчаки прокладалися довільним чином і так сталося, що до кожного дерева підходила різна їх кіль кість, а це призводило до нераціонального використання води
90
а) |
б) |
в) |
|
|
Мал. 47 |
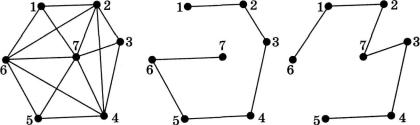
(мал. 47, а). Для економії витрат води вирішено було рекон струювати зрошувальну систему, прибравши в ній зайві рівча ки і залишивши мінімально необхідну їх кількість.
Давайте спочатку визначимо, у чому полягає суть задачі. Мінімальною буде така структура зрошувальної системи, коли всі дерева будуть з'єднані таким чином, що від першого визна ченого дерева буде йти рівчак до будь-якого іншого, потім до будь-якого іншого з тих, що залишились, і т. д. Скільки потріб но таких рівчаків? Якщо дерев у саду N, то зрозуміло, що рів чаків потрібно (N - 1). А чи можна це зробити у нашій задачі? Звісно, що можна, оскільки говорячи мовою графів, нам було задано зв'язний граф. А це означає, що всі дерева зрошувалися водою, а це свідчить про досяжність довільної його вершини з будь-якої іншої.
Отже, рішення полягає в тому, щоб залишити тільки ті реб ра графа, що з'єднають усі його вершини. У результаті також отримаємо граф, але він не буде містити циклів, оскільки почнемо його будувати з будь-якої вершини, пройшовши реш ту лише один раз.
Нагадаємо, що граф, який одержимо у результаті такої «ре конструкції» заданого графа, називається деревом. А дерево, що містить усі вершини заданого графа, називається остовним деревом, або каркасом. Ті ребра графа, що не увійшли до побу дованого остовного дерева, називаються хордами.
На малюнках 47, б та 47, в зображені остовні дерева для гра фа, що зображений на малюнку 47, а. Отже, можна зробити висновок, що таких остовних дерев для одного і того самого графа може бути більше одного.
Перейдемо до розгляду алгоритму побудови остовного дере ва для заданого незваженого неорієнтованого зв'язного графа. Для цього скористаємося пошуком у глибину.
1.Визначити будь-яку вершину і як поточну і запам'ятати її першою у послідовності відвіданих вершин.
2.Визначити змінну count = 1 як лічильник кількості ребер
востовному дереві.
91