Материал: АиСД. Практикум (in dev)
-
Пояснения к выполнению работы.
Определить время выполнения какого-либо фрагмента программы можно с помощью библиотечной функции gettime(), прототип которой находится в заголовочном файле dos.h. Эта функция должна получать аргумент – адрес структуры типа time, в поля которой и заносится информация о текущем времени. В обобщенном виде программа, в которой выполняется контроль времени может выглядеть следующим образом:
#include <dos.h>
void main()
{
time t1,t2;
gettime(&t1);
// Фрагмент, время работы которого измеряется.
gettime(&t2);
// ...
}
Для получения интервала времени следует вычесть поля структуры t1 из полей структуры t2. Представить этот интервал в секундах можно следующим образом:
double delta_t=(t2.ti_hour*360000.+t2.ti_min*6000.+
t2.ti_sec*100.+t2.ti_hund-
(t1.ti_hour*360000.+t1.ti_min*6000.+
t1.ti_sec*100.+t1.ti_hund))/100.;
Современные процессоры выполняют сортировку небольших массивов за время, значительно меньшее, чем тысячная доля секунды (t1.ti_hund), поэтому для получения точного результата нужно выполнить сортировку достаточно большое число раз, например, миллион. При этом необходимо каждый раз сортировать один и тот же неупорядоченный массив. Лучше сортировать второй массив, каждый раз перед сортировкой копируя в него данные из исходного неупорядоченного массива. Копирование занимает некоторое время, которое необходимо учесть.
После завершения всего процесса следует проверить правильность сортировки, выведя содержимое второго массива на экран.
Итоговая программа в обобщенном виде может выглядеть следующим образом:
#include <dos.h>
#include <iostream.h>
const int N = 5; // Размер массива.
const unsigned long NN = 1000000; // Число сортировок.
void main()
{
char arr1[N]={ /* Элементы неупорядоченного массива */ };
char arr[N];
time t1,t2;
double t_copy,t_sort;
gettime(&t1);
// Копирование из массива arr1 в массив arr.
gettime(&t2);
t_copy = (t2.ti_hour*360000.+t2.ti_min*6000.+
t2.ti_sec*100.+t2.ti_hund-(t1.ti_hour*360000.+
t1.ti_min*6000.+t1.ti_sec*100.+t1.ti_hund))/100.;
gettime(&t1);
// Цикл сортировки из большого числа проходов.
gettime(&t2);
t_sort = (t2.ti_hour*360000.+t2.ti_min*6000.+
t2.ti_sec*100.+t2.ti_hund-(t1.ti_hour*360000.+
t1.ti_min*6000.+t1.ti_sec*100.+t1.ti_hund))/100.;
t_sort-=t_copy;
// Контроль содержимого массива arr после сортировки.
// Вывод на экран времени сортировки t_sort.
}
-
Лабораторная работа -Методы поиска
Цель работы: ознакомление с алгоритмами поиска в линейных и нелинейных структурах и оценкой эффективности алгоритмов.
Продолжительность работы: - 2 часа.
-
Теоретические сведения
Предметы (объекты), составляющие множество, называются его элементами. Элемент множества будет называться ключом, и обозначаться латинской буквой “k” с индексом, указывающим номер элемента.
Алгоритмы поиска можно разбить на следующие группы:
М етоды
поиска



последовательный по бору
бинарный хеширование
Фибоначчиев
по бинарному дереву
интерполяционный
Задача поиска:
Пусть дано множество ключей {k1, k2, k3...kn}.
Необходимо отыскать во множестве ключ ki. Поиск может быть завершён в двух
случаях: 1) Ключ во множестве отсутствует;
2) Ключ найден во множестве.
-
Последовательный поиск.
В последовательном поиске исходное множество не упорядоченно, т.е. имеется произвольный набор ключей {k1, k2, k3...kn}. Метод заключается в том, что отыскиваемый ключ ki последовательно сравнивается со всеми элементами множества. При этом поиск заканчивается досрочно, если ключ найден.
-
Бинарный поиск.
В бинарном поиске исходящее множество должно быть упорядоченно по возрастанию. Иными словами каждый последующий ключ больше предыдущего
{k1≤k2≤k3≤k4...kn-1≤kn}.
Отыскиваемый ключ сравнивается с центральным элементом множества, если он меньше центрального, то поиск продолжается в левом подмножестве, в противном случае в правом.
Центральный элемент находится по формуле N эл-та =[n/2]+1,
где квадратные скобки обозначают, что от деления берётся только целая часть (всегда округляется в меньшую сторону). В методе бинарного поиска анализируются только центральные элементы.
Пример. Дано множество
{7,8,12,16,18,20,30,38,49,50,54,60,61,69,75,79,80,81,95,101,123,198}
Найти во множестве ключ K=61.
Шаг 1
N эл-та =[n/2]+1=[22/2]+1=12
K~k12
61>60 Дальнейший поиск в правом подмножестве {61,69,75,79,80,81,95,101,123,198}.
Значок ”~” обозначает сравнение элементов (чисел, значений).
Шаг 2
N эл-та =[n/2]+1=[12/2]+1=7
K~k19
61<95 Дальнейший поиск в левом подмножестве {61,69,75,79,80,81} (относительно предыдущего подмножества).
Шаг 3
N эл-та =[n/2]+1=[6/2]+1=4
K~k16
61<79 Дальнейший поиск в левом подмножестве {61,69,75,79}.
Шаг 4
N эл-та =[n/2]+1=[4/2]+1=3
K~k15
61<75 Дальнейший поиск в левом подмножестве {61,69} .
Шаг 5
N эл-та =[n/2]+1=[2/2]+1=2
K~k14
61<69 Дальнейший поиск в левом подмножестве.
Шаг 6
K~k13
61=61.
Вывод: искомый ключ найден под номером 13.
-
Фибоначчиев поиск.
В этом поиске анализируются элементы, находящиеся в позициях, равных числам Фибоначчи. Числа Фибоначчи получаются по следующему правилу:
каждое последующее число равно сумме двух предыдущих чисел, например:
{1,2,3,5,8,13,21,34,55,…}.
Поиск продолжается до тех пор, пока не будет найден интервал между двумя ключами, где может располагаться отыскиваемый ключ.
Пример. Дано исходное множество ключей
{3,5,8,9,11,14,15,19,21,22,28,33,35,37,42,45,48,52}
Пусть отыскиваемый ключ равен 42. (K=42).
Последовательное сравнение отыскиваемого ключа будет проводиться в позициях, равных числам Фибоначчи: {1,2,3,5,8,13,21,…}
Шаг 1. K~K1 42>3 => отыскиваемый ключ сравнивается с ключом, стоящим в позиции равной числу Фибоначчи.
Шаг 2. K~K2 42>5 => сравнение продолжается с ключом, стоящим в позиции равной следующему числу Фибоначчи.
Шаг 3. K~K3 42>8 => сравнение продолжается
Шаг 4. K~K5 42>11 => сравнение продолжается
Шаг 5. K~K8 42>19 => сравнение продолжается
Шаг 6. K~K13 42>35 => сравнение продолжается
Шаг 7. K~K18 42<52 => найден интервал, в котором находится отыскиваемый ключ: от 13 до 18 позиции, т.е. {35,37,42,45,48,52}
В найденном интервале поиск вновь ведётся в позициях равных числам Фибоначчи.
-
Интерполяционный поиск.
Исходное множество должно быть упорядочено по возрастанию весов.
Первоначальное сравнение осуществляется на расстоянии шага d , который определяется по формуле:
d=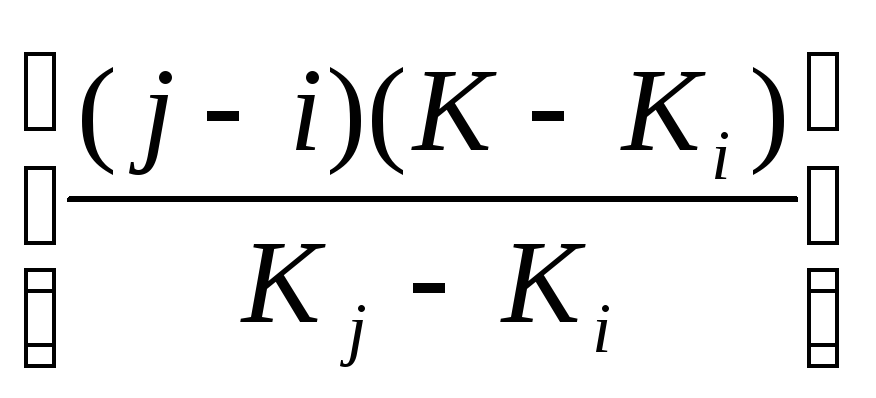
Где:
i – номер первого рассматриваемого элемента
j – номер последнего рассматриваемого элемента
K – отыскиваемый ключ
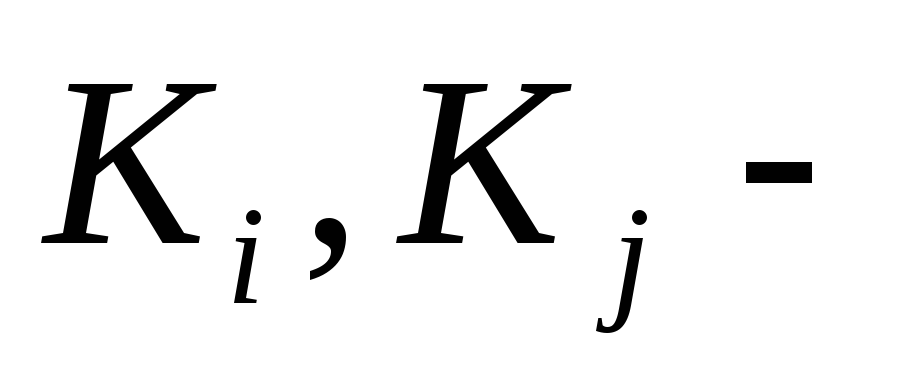 значения ключей в i и j
позициях
[ ] – целая часть от числа.
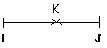
Идея метода заключается в следующем:
ш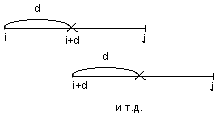 аг
d меняется после каждого
этапа, по формуле приведённой выше.
Алгоритм заканчивает работу при d=0, при этом анализируются соседние элементы, после чего делается окончательно решение.
Этот метод прекрасно работает, если исходное множество представляет собой арифметическую прогрессию или множество, приближенное к ней.
Пример . Дано множество ключей:
{2,9,10,12,20,24,28,30,37,40,45,50,51,60,65,70,74,76}
Пусть искомый ключ равен 70. (K=70).
Шаг 1. Определим шаг d для исходного множества ключей:
d=[ (18-1)(70-2)/(76-2) ]=15
Сравниваем ключ, стоящий под шестнадцатым порядковым номером в данном
множестве с искомым ключом:
K16~K 70=70 ключ найден.
-
Поиск по бинарному дереву.
Использование структуры бинарного дерева позволяет быстро вставлять и удалять записи и производить эффективный поиск по таблице. Такая гибкость достигается добавлением в каждую запись двух полей для хранения ссылок.
Пусть дано бинарное дерево:
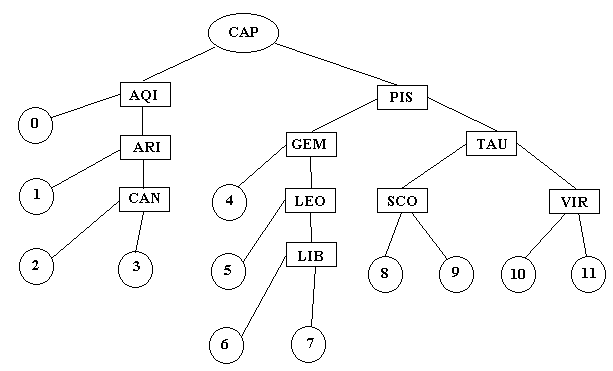
Требуется по бинарному дереву отыскать ключ SAG.
При просмотре от корня дерева видно, что по первой букве латинского алфавита, название SAG больше чем САР. Следовательно, дальнейший поиск будем осуществлять в правой ветви. Это слово больше чем PIS - снова идем вправо; оно меньше чем TAU - идем влево; оно меньше чем SCO и попадаем в узел 8. Таким образом, название SAG должно находиться в узле 8.
При этом узлы дерева имеют следующую структуру:
|
Ключ |
Информационная часть |
Указатель на левое поддерево |
Указатель на правое поддерево |
|
|
/может отсутствовать/ |
LLINK |
RLINK |
|
KEY |
|||