Материал: АиСД. Практикум (in dev)
-
Поиск по сбалансированному дереву.
Бинарное дерево называется сбалансированным, если высота левого поддерева каждого узла отличается от высоты правого не более чем
на 1.
Например:
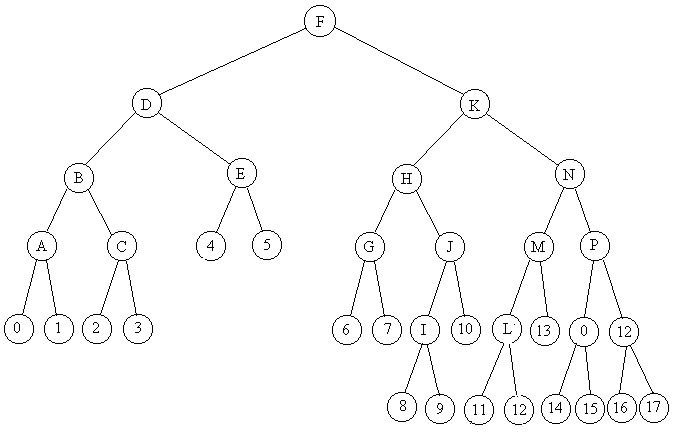
Сбалансированные бинарные деревья занимают промежуточное положение между оптимальными бинарными деревьями ( все внешние узлы, которых расположены на двух смежных уровнях ) и произвольными бинарными деревьями.
Бинарное дерево называется сбалансированным, если высота левого поддерева каждого узла отличается от высоты правого не более чем на 1.
Рассмотрим следующую структуру узлов сбалансированного бинарного дерева:
|
Ключ
|
Указатель на левое поддерево |
Указатель на правое поддерево |
Показатель сбалансированности узла |
|
KEY |
LLINK |
RLINK |
B |
где
В – показатель сбалансированности узла, то есть разность высот правого и левого поддерева ( В = +1; 0; -1 ).
При восстановлении баланса дерева по высоте учитывается показатель В.
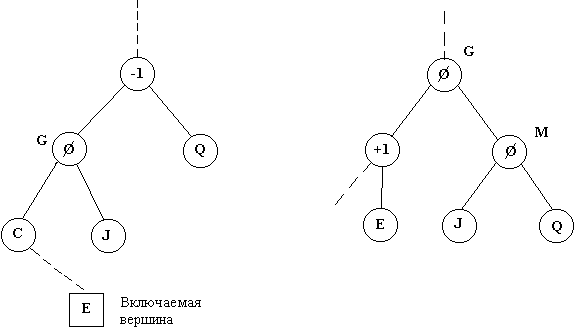
Символы +1, ,-1 указывают, что левое поддерево выше правого, поддеревья равны по высоте, правое поддерево выше левого.
-
Поиск по бору
Особую группу методов поиска образует представление ключей в виде последовательности цифр и букв. Рассмотрим, например, имеющиеся во многих словарях буквенные высечки. Тогда по первой букве данного слова можно отыскать страницы, содержащие все слова, начинающиеся с этой буквы. Развивая идею побуквенных высечек, получим схему поиска, основанную на индексации в структуре бора ( термин использует часть слова выборка ).
Бор представляет собой m –арное дерево. Каждый узел уровня h представляет множество всех ключей, начинающихся с определенной последовательности из h литер. Узел определяет m – путевое разветвление в зависимости от (h + 1) –ой литеры.
Бор представляет собой таблицу, следующего вида:
|
Символы |
1 |
2 |
3 |
... |
N |
|
Пробел(_) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
 Узлы
Пробел ( _ )- обязательный символ таблицы.
В первом узле записывается первая буква или цифра ключа. Во втором узле к ней добавляется ещё один символ и т.д. Если слово начинающееся с определенной буквы (цифры) единственное , то оно сразу записывается в первом узле .
Пример. Дано множество
{A,AA,AB,ABC,ABCD,ABCA,ABCC,BOR,C,CC,CCC,CCCD,CCCB,CCCA}
От исходного множества перейдём к построению бора.
Исходный алфавит = {A,B,C,D}
BOR- единственное слово на букву В и оно побуквенно не разбивается.
|
Символы |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
|
_ |
|
A_ |
AB_ |
ABC_ |
C_ |
CC_ |
CCC_ |
|
A |
2 |
AA |
|
ABCA |
|
|
CCCA |
|
B |
BOR |
3 |
|
|
|
|
CCCB |
|
C |
5 |
|
4 |
ABCC |
6 |
7 |
|
|
D |
|
|
|
ABCD |
|
|
CCCD |
 Узлы
Узлы бора представляют собой векторы, каждая компонента которых представляет собой либо ключ, либо ссылку ( возможно пустую ).
Узел 1 – корень, и первую букву следует искать здесь. Если первой сказалась, например, буква В, то из таблицы видно, что ему соответствует слово BOR . Если же первая буква А, то первый узел передает управление к узлу 2, где аналогичным образом отыскивается вторая буква. Узел 2 указывает, что вторыми буквами будут _, А, В и т. д.
-
Поиск хешированием
В основе поиска лежит переход от исходного множества к множеству хеш-функций h(k). Хеш-функция имеет следующий вид:
h(k)=k mod (m),
где k-ключ, m- целое число, mod-целочисленный остаток от деления.
Например, пусть дано множество {9,1,4,10,8,5}.
Определим для него хеш-функцию h(k)= k mod(m);
-
Пусть m=1, тогда
h(k)={0, 0, 0, 0, 0, 0};
-
Пусть m=20, тогда
h(k)={9, 1, 4, 10, 8, 5};
-
Пусть m равно половине максимального ключа, тогда m=[10/2]=5
h(k)={4, 1, 4, 0, 3, 0};
Хеш-функция указывает адрес, по которому следует отыскивать ключ. Для разных ключей хеш-функция может принимать одинаковые значения, такая ситуация называется коллизией. Таким образом, поиск хешированием заключается в устранении коллизий.
Пример. Дано множество
{7, 13, 6, 3, 9, 4, 8, 5}
Найти ключ K=27.
Хеш-функция равна h(k)= K mod(m);
m=[13/2]=6 (т.к. 13- максимальный ключ)
h(k)={1,1,0,3,3,4,2,5}
Для устранения коллизий построим таблицу.
h(k) Цепочки
ключей 0 6 1 7,12 2 8 3 3,
9 4 4 5 5
По парным сравнением множества хеш-функцийи множества исходных ключей, заполняем таблицу.
Напоминаем, что хеш-функция указывает адрес, по которому следует отыскивать ключ.
Например , если отыскивается ключ K=27, тогда
h(k)=27 mod 6=3-это значит, что ключ K=27 может быть только в 3-й строке. Так как его там нет, то данный ключ
отсутствует в исходном множестве .
-
Алгоритмы поиска словесной информации
В настоящее время наличие сверхпроизводительных микропроцессоров и дешевизна электронных компонентов позволяют делать значительные успехи в алгоритмическом моделировании. Рассмотрим несколько алгоритмов обработки слов.
-
Алгоритм Кнута - Морриса - Пратта
Алгоритм Кнута-Морриса-Пратта (КМП) получает на вход слово
X=x[1]x[2]... x[n]
и просматривает его слева направо буква за буквой, заполняя при этом массив натуральных чисел l[1]... l[n], где
l[i]=длина слова l(x[1]...х[i])
Таким образом: l[i] есть длина наибольшего начала слова x[1]...x[i], одновременно являющегося его концом.
Используя алгоритм КМП определить , является ли слово A подсловом слова B?
Решение. Применим алгоритм КМП к слову A#B, где # - специальная буква, не встречающаяся ни в A, ни в B. Слово A является подсловом слова B тогда и только тогда, когда среди чисел в массиве l будет число, равное длине слова A.
Предположим, что первые i значений l[1]...l[i] уже найдены. Читается очередная буква слова (т.е. x[i+1]) и вычисляется l[i+1].
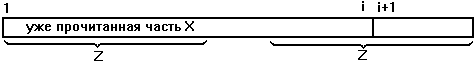
Другими словами, необходимо определить начала Z слова
x[1]...x[i+1,
одновременно являющиеся его концами -из них следует выбрать самое длинное.
Получаем такой рецепт отыскания слова Z. Рассмотрим все начала слова x[1]...x[i], являющиеся одновременно его концами. Из них выберем подходящие - те, за которыми идет буква x[i+1]. Из подходящих выберем самое длинное. Приписав в его конец х[i+1], получим искомое слово Z. Теперь пора воспользоваться сделанными приготовлениями и вспомнить, что все слова, являющиеся одновременно началами и концами данного слова, можно получить повторными применениями к нему функции l .
Вот что получается:
i:=1; 1[1]:=0;
{таблица l[1]..l[i] заполнена правильно}
while i <> n do begin
len:= l[i]
{len - длина начала слова x[1]..x[i], которое является
его концом; все более длинные начала оказались
неподходящими}
while (x[len+1]<>х[i+1]) and (len>0) do begin
{начало не подходит, применяем к нему функцию l}
len:=l[len];
end;
{нашли подходящее или убедились в отсутствии}
if x[len+1]=x[i+1] do begin
{х[1]..x[len] - самое длинное подходящее начало}
l[i+1]:=len+1;
end else begin
{подходящих нет}
l[i+1]:= 0;
end;
i:=i+1;
end;
Запишем алгоритм проверяющий, является ли слово X=x[1]...x[n] подсловом слова Y=y[1]...y[m]
Решение. Вычисляем таблицу l[1]...l[n] как раньше.
j:=0; len:=0;
{len - длина максимального качала слова X, одновременно
являющегося концом слова y[1]..j[j]}
while (len<>n) and (j<>m) do begin
while (x[len+1]<>у[j+1]) and (len>0) do begin
{начало не подходит, применяем к нему функцию l}
len: = l[len];
end;
{нашли подходящее или убедились в отсутствии}
if x[len+1]=y[j+1] do begin
{x[1]..x[len] - самое длинное подходящее начало}
len:=len+1;
end else begin
{подходящих нет}
len:=0;
end;
j:=j+1;
end;
{если len=n, слово X встретилось; иначе мы дошли до конца
слова Y, так и не встретив X}