Курсовая работа (т): Анализ и построение имитационной модели заданного временного ряда
Если наблюдаемое значение t-критерия (вычисленное по выборочным данным) больше критического значения t-критерия (определённого по таблице распределения Стьюдента), т. е. tнабл›tкрит, то основная гипотеза отвергается. Следовательно, ряд остатков является не центрированным.
Если наблюдаемое значение t-критерия (вычисленное по выборочным данным) меньше или равно критического значения t-критерия (определённого по таблице распределения Стьюдента), т. е. tнабл≤tкрит, то основная гипотеза принимается. Следовательно, ряд остатков является центрированным.
Проверка независимости ряда остатков модели осуществляется с целью определения возможной систематической составляющей в составе ряда остатков. Если модель подобрана неудачно, то остатки будут подвержены автокорреляционной зависимости.
Независимость остатков проверяется с помощью критерия Дарбина-Уотсона, связанного с гипотезой о наличии в ряде остатков автокорреляции первого порядка, т. е. о корреляционной зависимости соседних остатков.
Нормальность ряда остатков проверяется с помощью показателей асимметрии и эксцесса (если объём выборочной совокупности не превышает 50 значений). При нормальном распределении показатели асимметрии и эксцесса равны нулю.
На
основании выборочных данных вычисляются эмпирические коэффициенты асимметрии и
эксцесса по формулам:
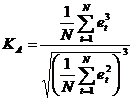 (54)
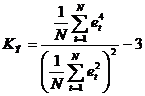 (55)
Если вычисленные коэффициенты близки к нулю, то можно сделать вывод, что ряд остатков подчиняется нормальному закону распределения.
В
дополнение к выборочным коэффициентам асимметрии и эксцесса рассчитывают
показатели среднеквадратических отклонений данных коэффициентов по формулам:
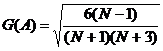 (56)
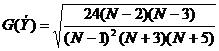 (57)
Если одновременно выполняются следующие неравенства:
) |КА|≤1,5G(A);
) |КЭ|≤1,5G(Э),
то гипотеза о нормальном характере распределения случайной компоненты принимается. Если хотя бы одно из указанных неравенств нарушается, то гипотеза о нормальном распределении остатков отвергается.
Помимо
адекватности выбранной модели, необходимо охарактеризовать её точность.
Наиболее простым критерием точности модели является относительная ошибка,
рассчитываемая по формуле:
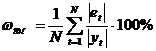 (58)
Если
относительная ошибка равна менее, чем 13 %, то точность подобранной модели
признаётся удовлетворительной.
1.9 Прогнозирование динамики
Прогнозирование экономических показателей на основе трендовых моделей, как и большинство других методов экономического прогнозирования, основано на идее экстраполяции. Под экстраполяцией обычно понимают распространение закономерностей, связей и соотношений, действующих в изучаемом периоде, за его пределы. В более широком смысле слова ее рассматривают как получение представлений о будущем на основе информации, относящейся к прошлому и настоящему. В процессе построения прогнозных моделей в их структуру иногда закладываются элементы будущего предполагаемого состояния объекта или явления, но в целом эти модели отражают закономерности, наблюдаемые в прошлом и настоящем, поэтому достоверный прогноз возможен лишь относительно таких объектов и явлений, которые в значительной степени детерминируются прошлым и настоящим.
Стандартная
(средняя квадратическая) ошибка оценки прогнозируемого показателя  определяется по формуле:
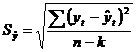 (59)
где
 - фактическое значение уровня временного ряда для
времени t;
 -
расчетная оценка соответствующего показателя по модели (например, по уравнению
кривой роста);
n - количество уровней в исходном временном ряду;
k - число параметров модели.
В
случае прямолинейного тренда для расчета доверительного интервала можно
использовать аналогичную формулу для парной регрессии, таким образом,
доверительный интервал прогноза  в этом
случае будет иметь вид
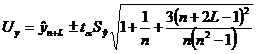 (60)
где L - период упреждения;
 -
точечный прогноз по модели на
 -й момент
времени;
n - количество наблюдений во временном ряду;
стандартная ошибка оценки прогнозируемого показателя, рассчитанная по формуле (1) для числа параметров модели, равного двум;
 -
табличное значение критерия Стьюдента для уровня значимости
 и числа степеней свободы, равного
 .
Если выражение:
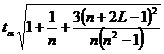 (61)
обозначить
через K, то формула для доверительного интервала примет вид:
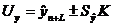 (62)
Иногда
для расчета доверительных интервалов прогноза относительно линейного тренда
применяют приведенную выше формулу в несколько преобразованном виде:
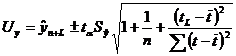 (63)
здесь t - порядковый номер уровня ряда (t = 1, 2, . . . , n);
 - время,
для которого делается прогноз;
 - время,
соответствующее середине периода наблюдений для исходного ряда.
Эту
формулу можно упростить, если, как часто делается на практике, перенести начало
отсчета времени на середину периода наблюдений (=0):
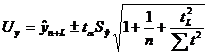 (64)
Формула для расчета доверительных интервалов прогноза относительно тренда, имеющего вид полинома второго или третьего порядка, выглядит следующим образом:
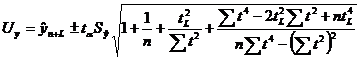 (65)
Аналогично вычисляются доверительные интервалы для экспоненциальной кривой роста, а также для кривых роста, имеющих асимптоту (модифицированная экспонента, кривая Гомперца, логистическая кривая), если значение асимптоты известно.
Проверка
точности одного прогноза недостаточна для оценки качества прогнозирования, так
как она может быть результатом случайного совпадения. Меру качества прогнозов k
можно вычислить по формуле:
 (66)
где p - число прогнозов, подтвержденных фактическими данными;
q -число прогнозов, не подтвержденных практическими данными.
На
практике не всегда удается сразу построить достаточно хорошую модель
прогнозирования, поэтому описанные в данной главе этапы построения трендовых
моделей экономической динамики выполняются неоднократно.
2. Построение, анализ и оценка модели
Для расчетов был взят убывающий динамический ряд, состоящий из 100
элементов. Для наглядности будем работать с двумя первыми и двумя последними
значения.
2.1 Расчет показателей динамики развития экономических рядов
1. Для начала рассчитаем по формулам (1) и (2)
абсолютный прирост и средний абсолютный прирост.
Таблица 1.
|
|
y |
y2 |
Yср. |
Yср. 2 |
|
1 |
- |
- |
- |
- |
|
2 |
-1,00 |
-1,00 |
-1,00 |
-1,00 |
|
… |
… |
… |
… |
… |
|
99 |
-2,00 |
-140,00 |
-2,00 |
-1,43 |
|
100 |
-2,00 |
-142,00 |
-2,00 |
-1,43 |
. Вторым этапом будет нахождение по формулам
(4) и (5) коэффициентов роста и прироста.
Таблица 2.
|
|
Кр |
Kip |
Kiпр |
Кпр |
|
1 |
- |
- |
- |
- |
|
2 |
0,94 |
0,94 |
-0,06 |
-0,06 |
|
… |
… |
… |
… |
… |
|
99 |
1,02 |
-7,24 |
-8,24 |
0,02 |
|
100 |
1,02 |
-7,35 |
-8,35 |
0,02 |
. Заключительным этапом будет нахождение по формулам (7) и (8) темпов роста и прироста.
Таблица 3.
|
|
Тр |
Тпр |
Трi |
Tпр |
|
1 |
- |
- |
- |
|
|
2 |
0,94 |
-0,06 |
94,12 |
93,12 |
|
… |
… |
… |
… |
… |
|
99 |
1,02 |
0,02 |
-723,53 |
-724,53 |
|
100 |
1,02 |
0,02 |
-735,29 |
-736,29 |
2.2 Выявление аномальных уровней ряда. Анализ временного ряда на наличие тренда
Для выявления аномальных уровней временных рядов используются методы, рассчитанные для статистических совокупностей.
Метод Ирвина, описанный в теоретической части, предполагает использование формул (11) и (12).
По итогам расчетов (формула (12)) σ = 41,55
Расчетные
значения  и т. д. сравниваются с табличными значениями критерия
Ирвина
 =1‚ и если оказываются больше табличных, то
соответствующее значение
 уровня ряда считается аномальным.
Таблица 4.
|
t |
Yt |
λ |
λ>λα |
|
1 |
17 |
- |
- |
|
2 |
16,00 |
0,02 |
0 |
|
… |
… |
… |
… |
|
99 |
-123,00 |
0,05 |
0 |
|
100 |
-125,00 |
0,05 |
0 |
В исходном ряде аномальных уровней не выявлено, если бы ситуация была обратной, то обязательно определение причин их возникновения. Если точно установлено, что они вызваны ошибками первого рода, то они устраняются, либо заменой аномальных уровней простой средней арифметической двух соседних уровней ряда, либо заменой аномальных уровней соответствующими значениями по кривой, аппроксимирующей данный временной ряд.
Для определения наличия тренда в исходном временном ряду применяется несколько методов, рассмотрим некоторые.
. Метод проверки разностей средних уровней
Реализация этого метода состоит из четырех этапов.
. На первом этапе исходный временной ряд разбивается на две примерно равные по числу уровней части: в первой части n1 = 49 первых уровней исходного ряда, во второй n2 = 51 остальных уровней (n1+ n2 = n = 100). На втором этапе для каждой из этих частей вычисляются средние значения и дисперсии по формулам (13), (14), (15), (16).
. Третий этап заключается в проверке равенства (однородности) дисперсий обеих частей ряда с помощью F-критерия Фишера, которая основана на сравнении расчетного значения этого критерия (17).
С
табличным (критическим) значением критерия Фишера  =5,06 с заданным уровнем значимости (уровнем ошибки) α.
3. На четвертом этапе проверяется гипотеза об отсутствии тренда с
использованием t-критерия Стьюдента. Для этого определяется расчетное значение
критерия Стьюдента по формуле (18) и (19).
Таблица 5.
|
Yср.1 |
-19,35 |
|
Yср.2 |
-91,78 |
|
σ21 |
6213,28 |
|
σ22 |
5992,49 |
|
Fрас. |
1,04 |
|
Fтаб. |
5,06 |
|
t |
0,19 |
|
σ |
78,11 |
|
tтаб |
2,10 |
Исходя из решения можно сделать вывод, что гипотеза о отсутствии тренда принимается.
Метод Фостера-Стъюарта.
Реализация метода также содержит четыре этапа.
. На первом этапе производится сравнение каждого исходного временного ряда, начиная со второго уровня, со всеми предыдущими, при этом определяются две числовые последовательности по формулам (20) и (21) соответственно.
. На втором этапе вычисляются по формулам (22) и (23) величины s и d.
. Третий этап заключается в проверке гипотез:
o можно ли считать случайными отклонение величины s от величины μ математического ожидания величины s для ряда, в котором уровни расположены случайным образом,
o можно ли считать случайными отклонение величины d от нуля.
Эта проверка проводится с использованием расчетных значений t-критерия Стьюдента для средней и для дисперсии, формулы (24), (25), (26) и (27).
. На четвертом этапе расчетные значения сравниваются ts и td с табличным значением t-критерия Стьюдента с заданным
уровнем значимости tα=2,10.
Таблица 6.
|
S |
99,00 |
|
d |
-99,00 |
|
μ |
6,56 |
|
σ1 |
2,41 |
|
σ2 |
2,89 |
|
ts |
38,43 |
|
td |
34,25 |
|
tтаб. |
2,10 |