Материал: для поступления в магистратуру
81
В действительности правила столь строги, что все популярные так называемые «реляционные» СУБД не соответствуют многим критериям.
Как реляционные БД организуют (структурируют) данные
Теперь, когда у вас есть общее понимание истории реляционной модели, давайте более подробно рассмотрим, как данная модель структурирует данные.
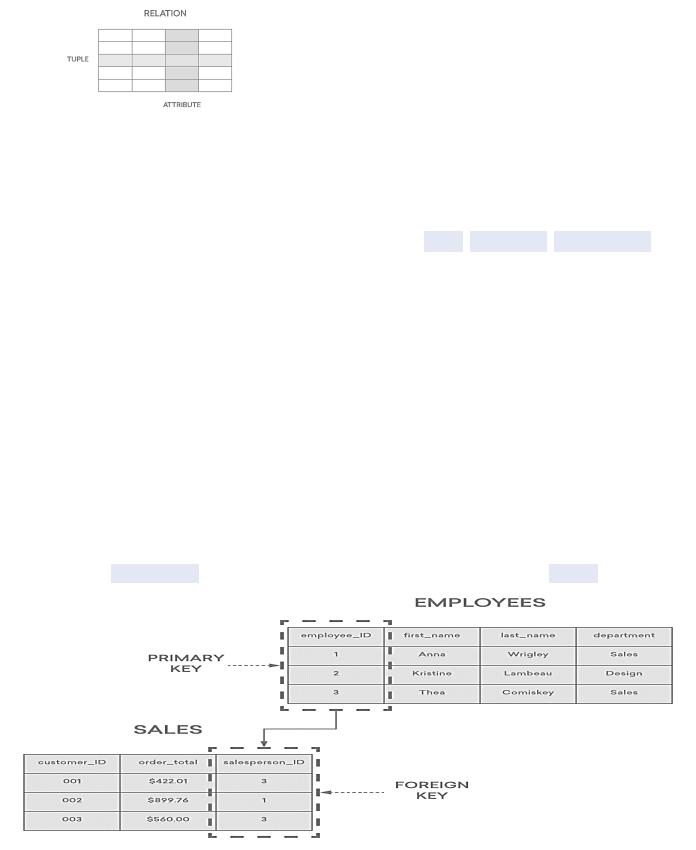
Наиболее значимыми элементами реляционной модели являются отношения, которые известны пользователям и современным РСУБД как таблицы. Отношения — это набор кортежей, или строк в таблице, где каждый кортеж имеет набор атрибутов, или столбцов:
Столбец — это наименьшая организационная структура реляционной базы данных, представляющая различные ячейки, которые определяют записи в таблице. Отсюда происходит более формальное название — атрибуты. Вы можете рассматривать каждый кортеж в качестве уникального экземпляра чего-либо, что может находиться в таблице: категории людей, предметов, событий или ассоциаций. Такими экземплярами могут быть сотрудники компаний, продажи в онлайн-бизнесе или результаты лабораторных тестов. Например, в таблице с трудовыми записями учителей в школе кортежи могут иметь такие атрибуты, как name, subjects, start_date и т.д.
При создании столбцов вы указываете тип данных, определяющий, какие записи могут вноситьсявданныйстолбец.РСУБДчастоиспользуютсвоисобственныеуникальныетипыданных, которые могут не быть напрямую взаимозаменяемы с аналогичными типами данных из других систем. Некоторые распространенные типы данных включают даты, строки, целые числа и логические значения.
В реляционной модели каждая таблица содержит по крайней мере один столбец, который можно использовать для уникальной идентификации каждой строки. Он называется первичным ключом. Это важно, поскольку это означает, что пользователям не нужно знать, где физически хранятся данные на компьютере. Их СУБД может отслеживать каждую запись и возвращать ее в зависимости отконкретной цели.Всвоюочередь,этоозначает,чтозаписинеимеютопределенного логического порядка, и пользователи могут возвращать данные в любом порядке или с помощью любого фильтра по своему усмотрению.
Если у вас есть две таблицы, которые вы хотите связать друг с другом, можно сделать это с помощью внешнего ключа. Внешний ключ — это, по сути, копия основного ключа одной таблицы (таблицы «предка»), вставленная в столбец другой таблицы («потомка»). Следующий пример показывает отношения между двумя таблицами: одна используется для записи информации о сотрудникахкомпании,адругая— дляотслеживанияпродажкомпании.Вэтомпримерепервичный ключ таблицы EMPLOYEES используется в качестве внешнего ключа таблицы SALES:
82
Если вы попытаетесь добавить запись в таблицу «потомок», и при этом значение, вводимое в столбец внешнего ключа, не существует в первичном ключе таблицы «предок», вставка будет недействительной. Это помогает поддерживать целостность уровня отношений, поскольку ряды в обеих таблицах всегда будут связаны корректно.
Структурные элементы реляционной модели помогают хранить данные в структурированном виде, но хранение имеет значение только в том случае, если вы можете извлечь эти данные. Для извлечения информации из РСУБД вы можете создать запрос, т. е. структурированный запрос на набор информации. Как уже упоминалось ранее, большинство реляционных баз данных используют язык SQLдля управления данными и отправки запросов. SQL позволяет фильтровать результаты и обрабатывать их с помощью различных пунктов, предикатов и выражений, позволяя вам контролировать, какие данные появятся в результате.
Преимущества и недостатки реляционных баз данных
Ознакомившись с организационной структурой реляционных баз данных, давайте теперь рассмотрим некоторые из их преимуществ и недостатков.
Современный SQL и базы данных, реализующие его, несколько отличаются от реляционной модели Кодда. Например, модель Кодда диктует, что каждая строка в таблице должна быть уникальной, в то время как из соображений практичности большинство современных РБД допускают дублирование строк. Некоторые пользователи не считают базу данных SQL «настоящей» реляционной базой, если она не соответствует каждой из спецификаций реляционной модели, описанной Коддом. Однако на практике любая СУБД, использующая SQL и хотя бы в некоторой степени придерживающаяся реляционной модели, скорее всего, будет относиться к РСУБД.
Популярность реляционных баз данных быстро росла, а вместе с этим росла и ценность данных. В связи сэтимначали проявляться некоторыенедостатки реляционной модели.Во-первых, реляционную базу данных сложно масштабировать по горизонтали. (Горизонтальное масштабирование – это практика добавления новых машин к существующему стеку, чтобы распределить нагрузку и обеспечить более быструю обработку трафик).
Примечание: Горизонтальное масштабирование часто противопоставляется вертикальному, которое подразумевает обновление оборудования существующего сервера (обычно путем добавления дополнительной оперативной памяти или процессора).
Причина, по которой реляционную базу данных сложно масштабировать по горизонтали,
связана с тем фактом, что реляционная модель предназначена для обеспечения согласованности.
Следовательно, клиенты, запрашивающие одну и ту же базу данных, всегда будут получать одни и те же данные. Но если реляционную базу данных масштабировать по горизонтали и разместить на нескольких машинах, ей становится сложно обеспечить согласованность, поскольку клиенты могут записывать данные на одну ноду, но не на другие. Вероятно, между внесением записи и ее отражением на других нодах пройдет некоторое время, а подобная задержка приведет к несогласованности данных.
Еще одно ограничение, представленное РСУБД, заключается в том, что реляционная модель была разработана для управления структурированными данными (то есть данными, которые соответствуют предопределенному типу или, по крайней мере, организованы некоторым заранее определеннымобразом,благодарячемуихлегкосортироватьиискать).Однакосраспространением персональных компьютеров и появлением Интернета в начале 1990-х годов широкое распространение получили неструктурированные данные (сообщения электронной почты, фотографии, видео и т.п.).
Еще одно преимущество реляционных баз данных состоит в том, что почти каждая СУБД поддерживает транзакции. Транзакция состоит из одного или нескольких отдельных SQLоператоров, выполняемых последовательно как единая задача. Транзакции представляют собой подход «все или ничего»: каждый SQL-оператор в транзакции должен быть действительным; в противном случае вся транзакция не будет выполнена. Это обеспечивает целостность данных при внесении изменений в несколько строк или таблиц.
SQL также является чрезвычайно мощным инструментом, он позволяет добавлять и изменять данные на ходу, а также менять структуру схем и таблиц БД, не влияя на существующие данные.
83
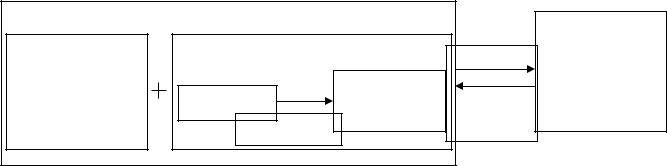
Концептуальное представление модели реляционной базы данных — это набор таблиц,
состоящих из строк и столбцов. (Например, информацию о сотрудниках компании можно просматривать в таблице, где для каждого сотрудника отведена одна строка, а в столбцах содержатся имя (Name), адрес (Address), идентификационный номер (Emplld) и прочие данные.)
Реляционная СУБД включает процедуры, которые позволят приложению выбирать определенные элементы определенной строки таблицы или, к примеру, выводить диапазон значений, найденных в столбце (зарплаты).
Эти процедуры формируют абстрактные инструменты, которые используются приложениями для доступа к базе данных.
Приложение обычно пишется на одном из языков программирования общего назначения. В этих языках обычно не хватает инструментов для обращения к базам данных. Процедуры СУБД расширяют возможности используемого языка, в том смысле, что поддерживают концептуальный образ модели базы данных.
Исходный язык общего назначения расширяется процедурами СУБД, (поэтому его часто называют базовым языком (hostlanguage)). Таким образом, базовый язык, расширенный при помощи СУБД, является программной средой для разработки приложений работающих с базами данных, и при помощи этой программной среды с базой можно работать так, как если бы она была организована согласно концептуальной модели.
|
Программная среда |
|
|
Концептуальное |
|
|
|
|
|
Приложения |
Реляционная СУБД |
Запросы |
представление |
|
написанные на |
|
|
модели |
|
базовом языке |
|
Абстрактные |
Ответы |
реляционной |
программирования |
Процедуры |
элементы |
базы данных |
|
|
формируют |
|
|
|
СУБД на инвертированных файлах
Организация доступа к данным на основе инвертированных списков используется практически во всех современных реляционных СУБД, но в этих системах пользователи не имеют непосредственного доступа к инвертированным спискам (индексам).
База данных, организованная с помощью инвертированных списков, похожа на реляционную БД, но с тем отличием, что хранимые таблицы и пути доступа к ним видны пользователям. При этом:
1.Строки таблиц упорядочены системой в некоторой физической последовательности.
2.Физическая упорядоченность строк всех таблиц может определяться и для всей БД.
3.Для каждой таблицы можно определить произвольное число ключей поиска, для которых строятся индексы. Эти индексы автоматически поддерживаются системой, но явно видны пользователям.
Поддерживаются два класса операторов:
1.Операторы, устанавливающие адрес записи, среди которых:
•прямые поисковые операторы;
•операторы, находящие запись в терминах относительной позиции от предыдущей записи по некоторому пути доступа.
2.Операторы над адресуемыми записями
Общие правила определения целостности БД отсутствуют. В некоторых системах поддерживаются ограничения уникальности значений некоторых полей, но в основном все возлагается на прикладную программу.
Однако такие СУБД обладают рядом ограничений на количество файлов для хранения данных, количество связей между ними, длину записи и количество ее полей.
84
<<В основном файле разрешается выделить один или несколько атрибутов (выделяемый атрибут может быть как первичным, так и вторичным ключом), по значениям которых затем будут формироваться инвертированные файлы и списки связи.
Все записи файлов получают в пределах БД единую нумерацию. Каждому значению ключевого атрибута ставится в соответствие множество номеров записей основных файлов, где это значение связано с именем атрибута.
Определенная таким образом последовательность значений атрибута А и номеров записей основного файла является инвертированным файлом.
Единаянумерациявсехзаписейбазыданныхприводитктому,чтономерзаписистановится первичным ключом во всех основных файлах базы данных независимо от того, какие атрибуты образуют ключ в каждом из этих файлов.
Для двух файлов, имеющих общий атрибут, существуют два списка связи. В первом списке для каждого номера записи из первого файла указываются номера записей из второго файла, имеющие то же самое значение атрибута. Аналогично определяется содержимое второго списка связи.>>
Гипертекстовые и мультимедийные БД
Суть гипертекстовой технологии заключается в том, что текст представляется как многомерный, т.е. с иерархической структурой типа сети. Материал текста делится на фрагменты. Каждый видимый на экране ЭВМ фрагмент, дополненный многочисленными связями с другими фрагментами, позволяет уточнить информацию об изучаемом объекте и двигаться в одном или нескольких направлениях по выбранной связи.
Под гипертекстом понимают систему информационных объектов (статей), объединенных между собой направленными связями, образующими сеть. Каждый объект связывается с информационной панелью экрана, на которой пользователь может выбирать одну из связей. Объекты могут быть текстовыми, графическими, музыкальными, с использованием средств мультипликации, аудио- и видеотехники. Вместо традиционных методов поиска информации по соответствующему поисковому ключу гипертекстовая технология предполагает перемещение от одних объектов информации к другим с учетом их смысловой, семантической связанности.
Структурно гипертекст состоит из информационного материала, тезауруса гипертекста, списка главных тем и алфавитного словаря.
Информационный материал подразделяется на информационные статьи, состоящие из заголовка статьи и текста. Заголовок содержит тему или наименование описываемого объекта. Информационная статья содержит традиционные определения и понятия, должна занимать одну панель и быть легко обозримой.
Тезаурус(лат. сокровище, запас, богатство)гипертекстаэто автоматизированный словарь, отображающий семантические отношения между лексическими единицами дескрипторного информационно-поискового языка и предназначенный для поиска слов по их смысловому содержанию. Он состоит из тезаурусных статей, которые имеют заголовки и список заголовков родственных тезаурусных статей. Заголовок тезаурусной статьи совпадает с наименованием информационной статьи и является наименованием объекта, описание которого содержится в информационной статье.
Список главных тем содержит заголовки всех справочных статей, для которых нет ссылок типа род - вид, часть - целое.
Алфавитный словарь включает в себя перечень наименований всех информационных статей в алфавитном порядке.
Гипертекстовая технология применяется в издательской деятельности, библиотечной работе, обучающих системах, при разработке документации, законов, справочных руководств, баз данных, баз знаний и т. д.
Базы данных, содержащие мультимедийную информацию, теория относит к базам данных пятого (последнего) поколения. Они получили название мультимедийных баз данных (ММБД) (другое название – мультисредные). Особенности ММБД, вызванные структурной сложностью и неоднородностью хранимой в них информации, показывают, что построение
85
систем баз данных пятого поколения является достаточно сложной задачей, которую преждевременно считать решенной.
Системы управления базами данных (СУБД), использующиеся в настоящее время в АСУ, относятся к классу реляционных СУБД (РСУБД). Многие РСУБД обладают возможностью ранения в составе своих таблиц полей с мультимедиа данными. Однако традиционные операции по манипулированию данными, применимые к элементарным данным, в отношении мультимедиа данных в РСУБД не поддерживаются.
По этой причине прямое использование РСУБД в качестве СУ ММБД недостаточно и невозможно, что позволяет определить основную проблему построения ММБД в АСУ как несоответствие используемых в АСУ программно-инструментальных средств управления базами данных потребностям обработки в АСУ мультимедийной информации.
Для решения данной проблемы необходимо использование СУБД, поддерживающих объектно-ориентированную (объектную) модель данных. При этом первоочередной задачей следует считать разработку концептуальной модели (КМ) ММБД, которая модель затем преобразуется в объектно-ориентированную модель ММБД логического уровня.
Таким образом, применение разработанной концептуальной модели в интересах объектноориентированной реализации ММБД связывается с ее преобразованием в объектноориентированную логическую структуру БД в соответствии со специально разработанным для этой цели алгоритмом. Саму разработку такого алгоритма следует считать направлением дальнейших исследований по данной тематике.
Одним из перспективных направлений развития гипертекстовых систем является технология гипермедиа — соединение технологии гипертекста и технологии мультимедиа (интеграция текста, графики, звука, видео).
XML-серверы
По существу, XML сервер – это сервер, на котором хранятся и с которого можно скачать документы в формате XML.
Используя технологии XML, можно производить обмен данными между различными приложениями на различных платформах. Поэтому организации переходят на хранение своих данных в формате XML, чтобы пользоваться преимуществами XML-технологий. Хранение данных в этом формате улучшает доставку и масштабируемость Ваших приложений при низких управленческих и эксплуатационных расходах.
В традиционных реляционных базах данных данные хранятся в виде строк и столбцов, что может быть слишком сложным. Но в случае XML сервера эта сложность устранена и здесь можно хранитьлюбыеданные,включаямультимедийныефайлыидажереляционныеданные.XML-сервер
– это любой сервер, выходным продуктом для которого является документ XML, который может использоваться другими приложениями для обработки.
Компонент<<XML-сервер>>, представляет собой промежуточный уровень между уровнем приложения и уровнем СУБД.
XML-сервер взаимодействует с приложением на основе XML-интерфейса, представляющего собой входные и выходные потоки данных в формате XML.
XML-сервер и СУБД взаимодействуют на основе стандартных интерфейсов доступа к реляционным базам данных, таких как ODBC или JDBC
Задачи, решаемые XML-сервером:
•организация удобного для программистов XML-интерфейса для доступа к СУБД (отпадает необходимость низкоуровнего взаимодействия с СУБД)
•поддержка распределенных и разнородных баз данных (так как каждая СУБД обладает присущими только ей характеристиками, возникает проблема поддержки распределенных и разнородных баз данных. XML Server может учитывать конкретные реализации СУБД, обеспечивая “прозрачность” информационной системы для разработчиков)
•промежуточное хранение данных (однократно запускаемые JAVA и CGI процессы не могут хранить промежуточные данные в ОП. Соответственно XML server может устранить данный недостаток)