Материал: для поступления в магистратуру
86
•кэширование данных (повторные данные берутся непосредственно из XML Server без обращения к СУБД)
•индексирование данных (частичный выбор данных, определенных пользователем)
Объектно-ориентированные базы данных
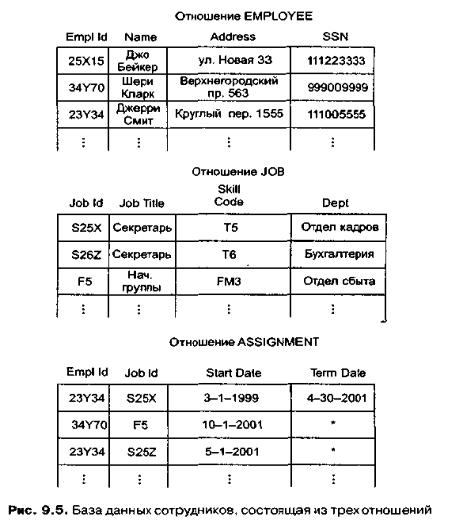
Одной из новейших областей исследований баз данных является их создание на основе объектно-ориентированной парадигмы. В результате получается объектно-ориентированная база данных (object-orienteddatabase), состоящая из объектов, связи между которыми отражают отношения между объектами. Например, объектно-ориентированная реализация базы данных сотрудников:
могла бы включать три класса (то есть три типа объектов): EMPLOYEE, JOB и ASSGNMENT. Объект класса EMPLOYEE мог бы содержать такие элементы, как Emplld, Name, Address и SSNum; объект класса JOB — элементы Jobld, JobTitle, Ski 11 Code и Dept; объект класса ASSGNMENT — элементы StartDate и TermDate.
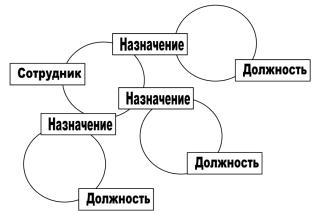
Концептуальное представление такой базы данных (рис. 11) образуется объектами и соединяющими их линиями, показывающими отношения между различными объектами. Рассмотрев объект типа EMPLOYEE, мы увидим, что он связан с набором объектов типа ASSIGNMENT, представляющих различные назначения сотрудникана должности. В свою очередь, каждый из объектов типа ASSIGNMENT связан с объектом типа JOB, обозначающим должность, которуюзанималилизанимаетсотрудник.Такимобразом,всеназначениясотрудниканаразличные должности можно найти, проследив связи, идущие от объекта, представляющего сотрудника. Аналогичноможноузнать,какиесотрудники занимали определеннуюдолжность,изучивссылки от объекта, представляющего должность.
87
Рисунок 11 – Связи между объектами в объектно-ориентированной базе данных
Связи между объектами в объектно-ориентированной базе данных обычно поддерживаются СУБД, поэтому подробности их реализации не касаются программиста, разрабатывающего приложения. Когда новый объект добавляется в базу данных, приложению необходимо только указать, с какими объектами его нужно связать в базе. СУБД сама создает необходимую для регистрации этих связей систему указателей. В частности, СУБД может связать объекты, обозначающие назначения на разные должности определенного сотрудника, в стиле, схожем со связным списком.
Другая задача объектно-ориентированной СУБД — обеспечивать постоянное хранение переданных ей объектов. Такое требование может казаться очевидным, но в действительности хранение отличается от обычного способа работы с объектами. В обыкновенной объектноориентированной программе объекты, созданные в ходе выполнения, удаляются во время завершения программы. В этом смысле объекты считаются временными. Но объекты, созданные и помещенные в базу данных, должны быть постоянными — то есть их необходимо сохранить после того, как программа, создавшая их, завершится. Поэтому обеспечение постоянного хранения объектов — это существенное отклонение от нормы.
Сторонники объектно-ориентированных баз данных приводят множество аргументов в защиту того, что объектно-ориентированный подход к разработке базы данных лучше, чем реляционный. Один из аргументов заключается в том, что он обеспечивает единую парадигму разработки всей системы программного обеспечения (приложения, СУБД и самой базы данных). В противоположность этому, исторически приложения для обмена данными с реляционными базами данных создаются на императивном языке программирования. Но при этом всегда возникают конфликты между императивной и реляционной парадигмами. На нашем уровне изучения это различие едва ли заметно, но оно всегда являлось причиной множества ошибок в программном обеспечении. Однако мы можем оценить тот факт, что объектно-ориентированная база данных в сочетании с объектно-ориентированным приложением создают однородный образ объектов, общающихся между собой внутри единой системы, тогда как реляционная база данных и императивное приложение вызывают образ двух структур различной природы, пытающихся найти общий интерфейс.
Чтобы понять другое преимущество объектно-ориентированных баз данных над их реляционными конкурентами, рассмотрим проблему хранения имен сотрудников в реляционной базе данных. Если полное имя (фамилия, имя и отчество) целиком хранится в одном атрибуте отношения, то выполнять запросы, относящиеся только к фамилиям, становится неудобно. Если же имя хранится в трех разных атрибутах — фамилия, имя и отчество, — то вызывает неудобства обработки имен, не подходящих под шаблон «фамилия, имя, отчество». В объектноориентированной базе данных эти проблемы можно спрятать в объекте, где хранится имя сотрудника. Имя можно записать в интеллектуальный объект, который сможет выдать имя сотрудника в различных форматах. Так, с использованием объектов обработка только фамилий становится такой же простой, как и работа с полными именами, девичьими фамилиями или прозвищами. Детали, связанные с каждой задачей, будут инкапсулированы в пределах объектов.
Возможность инкапсулировать технические подробности различных форматов данных полезна и в других случаях. В реляционной базе данных атрибуты отношения являются частью общего дизайна базы данных, поэтому типы, связанные с этими атрибутами, появляются во всей
88
СУБД. (Необходимо объявлять временные переменные подходящих типов и разрабатывать процедурыдляобработкиданныхразличныхтипов.)Такимобразом,расширениереляционнойбазы данных за счет добавления атрибутов новых типов (к примеру, звуковых и видео) может быть проблематичным. Действительно, это потребует расширения множества процедур во всей базе данных, чтобы они могли работать и с новыми типами. С другой стороны, в объектноориентированной модели процедуры, которые используются для получения объектов, обозначающих имена сотрудников, могут извлекать информацию, например из объекта, представляющеговидеоклип,таккакразличиевтипахможетбытьскрытовнутрисоответствующих объектов. Следовательно, при помощи объектно-ориентированного подхода удобнее конструировать мультимедийные базы данных — эта возможность уже является существенным преимуществом.
Еще одно преимущество, которое объектно-ориентированная парадигма предлагает для разработки баз данных, — это возможность хранения интеллектуальных объектов вместо обычных данных. Это означает, что объект может содержать методы, описывающие, как он будет отвечать на сообщения, относящиеся к его содержимому и связям. Например, каждый объект класса EMPLOYEE (см. рис. 11) может содержать методы для вывода и обновления информации, хранящейся в объекте, а также для вывода предыдущих должностей сотрудника и, возможно, для регистрации перевода сотрудника на новую должность. Аналогично, каждый объект класса JOB может обладать методами для вывода характеристик должности и, возможно, для вывода списка сотрудников, которые занимали эту должность. Так, чтобы получить историю работы сотрудника в компании, нам не нужно будет создавать внешние процедуры, описывающие, какполучитьинформацию.Вместоэтогомыпростопопросимсоответствующийобъектсотрудника рассказать его историю работы. Таким образом, способность создавать базы данных, объекты которых могут интеллектуально отвечать на запросы, предлагает исключительный набор возможностей, далеко превосходящий возможности традиционных реляционных баз данных.
Вобъектно-ориентированныхбазахданных,вотличиеотреляционных,хранятсянезаписи,
аобъекты. ОО-подход представляет более совершенные средства для отображения реального мира, чем реляционная модель, естественное представление данных.
К сожалению, в объектно-ориентированном программировании отсутствуют общие средства манипулирования данными, такие как реляционная алгебра или реляционное счисление. Работа с данными ведется с помощью одного из объектно-ориентированных языков программирования общего назначения, обычно это SmallTalk, C++ или Java.
Подведем теперь некоторые итоги:
Вреляционной модели все отношения принадлежат одному уровню, именно это осложняет преобразованиеиерархическихсвязеймодели«сущность-связь»вреляционнуюмодель.ОО-модель можно рассматривать послойно, на разных уровнях абстракции.
Имеется возможность определения новых типов данных и операций с ними.
Вто же время, ОО-модели присущ и ряд недостатков:
1.· отсутствуют мощные непроцедурные средства извлечения объектов из базы. Все запросы приходится писать на процедурных языках, проблема их оптимизации возлагается на программиста;
2.· вместо чисто декларативных ограничений целостности (типа явного объявления первичных и внешних ключей реляционных таблиц с помощью ключевых слов PRIMARY KEY и REFERENCES) или полудекларативных триггеров для обеспечения внутренней целостности приходится писать процедурный код.
Очевидно, что оба эти недостатка связаны с отсутствием развитых средств манипулирования данными. Эта задача решается двумя способами — расширение ОО-языков в сторону управления данными (стандарт ODMG), либо добавление объектных свойств в реляционные СУБД (SQL-3, а также так называемые объектно-реляционных СУБД).
Основными принципами объектно-ориентированной технологии являются:
•абстракция;
•инкапсуляция;
•модульность;
89
•иерархия;
•типизация;
•полиморфизм;
•наследование.
Объектно-ориентированной БД (ООБД) является БД, которая основывается на принципах объектноориентированной технологии.
Организация процессов обработки данных в БД
Обработка данных включает набор различных функций и операций, которые можно разделить на три группы:
•поиск, фильтрация и сортировка данных;
•запросы к базе данных;
•механизм реализации событий, правил (триггеров) и процедур в базе данных. Отличительная особенность операций по поиску, фильтрации и сортировке данных
заключается в том, что они осуществляются в режиме открытой таблицы или формы. Результатом операций по поиску или фильтрации данных является изменение состояния просмотра открытой таблицы (формы), но не самих данных, которые физически остаются в той же таблице и в том же порядке.
Поиск записи по ее номеру производится на основе механизма распределения записей по страницам файла данных. Результатом такого поиска является перевод табличного курсора в ключевое поле соответствующей записи или «показ» в форме полей искомой записи.
Поиск записи по значению поля осуществляется также на основе механизма распределения записей по страницам файла данных с использованием техники вхождения образца в значения просматриваемого поля. Результатом поиска является установка табличного курсора в соответствующее поле найденной записи. Если записей с искомым значением выделенного поля несколько, тогда, как правило, реализуется последовательная «остановка» (последовательный просмотр) табличного курсора в соответствующих полях найденных записей.
Фильтр представляет собой набор условий, применяемых для отбора подмножества записей. Результатом фильтрации является «показ» (отображение) в открытой таблице или форме только отфильтрованных записей с временным «скрытием» всех остальных записей.
Набор условий, определяющих фильтр, формируется в различных СУБД по-разному, но общепринятым является использование выражении в условиях отбора данных. Аргументами выражения могут быть числа, даты, текст, имена полей, которые соединяются знаками математических операций (+, -, *, /), неравенств ( >,<,=) и логических операций (АND, ОR,NОТ). При этом текстовые значения и аргументы заключаются в кавычки («Иванов»), даты в символы # (#01.01.03#).
Упорядочивание записей по возрастанию/убыванию или по алфавиту по определенному полю реализуется сортировкой данных. При этом в файле базы данных строки таблицы физически остаются не упорядоченными. Сортировка строк открытой таблицы происходит только в буферах страниц в оперативной памяти. Новый порядок расположения строк таблицы может быть зафиксирован специальной командой при закрытии таблицы.
При больших объемах таблиц (при большом количестве строк-записей) операции сортировки могут занимать продолжительное время, которое существенно сокращается, если сортировка осуществляется по индексированному полю.
Запросы являются наиболее распространенным видом обработки данных. Запрос представляет собой спецификацию (предписание) па специальном языке (языке базы данных) для обработки данных. В реляционных СУБД запросы к базе данных выражаются на языке SQL.
Формирование запросов в СУБД может осуществляться в специальном редакторе (командный режим) или через наглядно-диалоговые средства (конструкторы) и пошаговые мастера формирования запросов. Сформированный запрос в виде SQL-инструкции сохраняется в файле базы данных и впоследствии специальной командой СУБД может запускаться (открываться) на выполнение.
С точки зрения решаемых информационных задач и формы результатов исполнения
90
запросов их можно разделить на три группы: запросы на выборку данных; запросы на изменение данных; управляющие запросы.
Запросы на выборку относятся к одному из наиболее часто применяемых видов запросов. Данный вид запросов реализуется SQL-инструкцией SELECT с предложением FROM. Результатом исполнения запроса на выборку является набор данных, который представляет временную таблицу данных со структурой (поля, их типы и параметры), определяемой параметрами запроса и параметрами полей таблиц, из которых выбираются данные. Результаты запросов на выборку помещаютсявспециальнуювременнуютаблицу,размещаемуюнапериодисполнения(«открытия») запроса в оперативной памяти.
Важное значение для решения различных технологических информационных задач по ведению базы данных имеют запросы на изменение данных. В отличие от непосредственного ввода данных в режимах открытой таблицы или формы они вносят изменения сразу в группу записей за одну операцию. Таким образом, результатом запросов на изменение является не набор данных, как в запросах на выборку, а изменение данных в самих таблицах.
При исполнении запроса на удаление за одну операцию осуществляется удаление группы записей из одной или нескольких таблиц. Запросы на удаление реализуются SQL-инструкцией
DELETE:
DELETE (поля) FROM (таблица) WHERE (условие);
Запрос на обновление за одну операцию вносит общие изменения в группу записей одной или нескольких таблиц. Реализуются SQL-инструкцией UPDATE. Запросы на обновления применяются тогда, когда необходимо осуществить глобальные однотипные изменения в какомлибо наборе данных.
UPDATE (таблица) SET (поле = значение) WHERE(условие);
Запрос на добавление осуществляет добавление группы записей из одной или нескольких таблиц в конец другой или группы других таблиц. При этом количество и типы полей при вставке записей должны совпадать.
INTER INTO таблица SELECT поля FROM таблица WHERE (условие);
Запросы на создание таблицы за одну операцию создают новую таблицу с заполненными данными на основе всех или части данных из одной или нескольких таблиц.
SELECT поля INTO таблица FROM таблица WHERE (условие);
В составе языка описания данных DDL имеются ряд SQL-инструкций, на основе которых строятся запросы по созданию/модификации реляционных таблиц или отдельных их элементов. Такие запросы называются управляющими.
Запросы на создание таблицы реализуются SQL-инструкцией CREATEТАВLЕ с ключевыми словами, определяющими типы полей (СНАRACTER, INTEGER, DATETIME и т.д.), предложением CONSTRAINT для создания ограничений на значения полей или связей между таблицами, ключевым словом UNIQUE, задающим свойство уникальности индекса таблицы, а также ключевого слова PRIMERYKEY, определяющего ключевое поле создаваемой таблицы.
Запросы на добавление полей или индексов реализуются SQL-инструкцией ALTERTABLE с использованием зарезервированных слов ADDCOLUMN (добавить поле) и ADDCONSTRAIN (добавить индекс). Этимжезапросомс помощью зарезервированногословаDROPCOLUMN можно удалить поле из существующей таблицы. Как правило, запросы на добавление полей также используются длясоздания внешнихключей,задающих связи-отношения между таблицами.С этой целью используются зарезервированные слова FOREIGNKEY и REFERENCES.
Запросы на удаление таблицы или индексареализуются SQL– инструкцией DROPTABLE с указанием имени удаляемой таблицы или индекса.
Запросы на создание индекса реализуются SQL-инструкцией CREATEINDEX с использованием зарезервированного слова UNIQUE запрета повтора значений в индексируемом поле и необязательного предложения WITH с параметрами DISALLOWNULLи IGNORENULL для запрета/разрешения нулевых (пустых) значений в индексируемом поле. Зарезервированное слово PRIMERY позволяет определить создаваемый индекс ключом таблицы (при этом создаваемый индекс по умолчанию является уникальным, т. е. повторы значений не допускаются).