Материал: Камартина Н. М. Теория вероятностей и математическая статистика. Часть 2. Статистика
В случае когда параметры генерального распределения неизвестны, их оценивание производится по той же выборке, что уменьшает число степеней свободы статистики хи-квадрат.
Критерий Пирсона является правосторонним, его критической областью будет промежуток 12 r , , где 12 r – квантиль порядка 1 – α
распределения хи-квадрат с r = k – l – 1 степенями свободы. Число l зависит от ситуации. Оно представляет собой число параметров распределения генеральной совокупности, оцениваемых по выборке. Критические значения критерия представлены в таблице с двумя входами (приложение, табл. П4).
Статистический вывод формируется на основе сравнения двух значений статистики Пирсона – наблюдаемого и теоретического.
Если 2 |
2 |
r , то гипотеза Н принимается, в противном слу- |
в |
1 |
0 |
чае отвергается.
ПОНЯТИЕ О КОРРЕЛЯЦИОННО-РЕГРЕССИОННОМ АНАЛИЗЕ
При решении многих задач экономики бывает необходимо изучать зависимость наблюдаемой случайной величины Y от одной или нескольких других случайных величин X1, X2, ..., Xk . Случайная величина Y называется откликом, а величины X1, X2, ..., Xk – факторами. Общий тезис о наличии зависимости в математике формулируется в виде функционального
уравнения |
y x1,..., xk . В статистике данное уравнение понимается |
«в среднем», оно устанавливает зависимость среднего значения величины Y |
|
от величин |
x1,..., xk , потому что детерминированной зависимости между |
факторами и откликом быть не может в силу их случайности.
Задача регрессионного анализа состоит в том, чтобы на основании полученной выборки выявить характер связи между фактором X и откликом Y, т. е. получить оценку регрессии Y на X. Эта оценка представляет собой статистику и зависит от неизвестных параметров. Поэтому ее можно записать как функцию y x,a0,a1,...,am , где a0,a1,...,am – неизвестные
параметры.
Для определения типа зависимости сначала строится диаграмма рассеивания. При этом результаты измерений изображаются точками на координатной плоскости. Геометрически задача подбора аналитической функции состоит в проведении такой кривой (ее называют «линия регрессии»), которая возможно «ближе» примыкает к системе точек xi , yi ,
16
полученных в результате n реализаций случайных величин X и Y. Значения параметров определяются для выбранного типа линии так, чтобы функция y x,a0,a1,...,am наилучшим образом соответствовала неизвестной рег-
рессии. Простейшим случаем является линейная регрессия. Она описывается уравнением вида y 0 1x. Коэффициенты этого уравнения будут
статистиками. Для их определения используется метод наименьших квадратов. В расчетах линейной модели используются формулы
|
r |
sX |
; |
|
0 |
y x . |
(14) |
||
|
|||||||||
1 |
XY s |
|
|
|
1 |
|
|||
|
|
Y |
|
|
|
|
|
|
|
Коэффициент |
|
|
|
|
|
|
|
|
|
|
r |
|
xy x y |
|
|
||||
|
|
(15) |
|||||||
|
XY |
|
|
sX sY |
|||||
|
|
|
|
|
|
||||
играет отдельную роль в анализе взаимосвязи признаков. Он называется
выборочным коэффициентом корреляции. Тесноту корреляционной свя-
зи с его помощью оценивают по эмпирическому правилу (шкала Чеддока, табл. 1).
|
|
|
Таблица 1 |
|
|
|
|
|
r |
|
Теснота связи |
|
|
||
|
|
||
Менее 0,1 |
Отсутствует линейная связь |
||
|
|
||
От 0,1 до 0,3 |
Слабая |
||
|
|
||
От 0,3 до 0,5 |
Умеренная |
||
|
|
||
От 0,5 до 0,7 |
Заметная |
||
|
|
||
Более 0,7 |
Сильная (тесная) |
||
|
|
|
|
Рассмотрим простейший пример построения прямой регрессии. Имеются 10 экспериментальных точек – значений десяти измерений двух признаков.
i |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
8 |
9 |
10 |
|
|
|
|
|
|
|
|
|
|
|
xi |
45 |
54 |
63 |
74 |
85 |
93 |
104 |
111 |
123 |
135 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
yi |
52 |
70 |
74 |
87 |
92 |
117 |
123 |
121 |
133 |
157 |
Требуется построить уравнение прямой регрессии «игрек» на «икс» и провести его статистический анализ.
Расчеты оформим таблицей.
17
I |
|
|
|
|
|
x x |
|
|
y y |
|
|
x x |
2 |
|
|
y y |
|
2 |
|
(x x) y y |
ˆ |
|
ˆ |
2 |
|||||||||
xi |
yi |
|
|
|
|
|
i |
|
|
|
|
|
|
|
y |
x |
|
||||||||||||||||
|
|
|
|
i |
|
|
|
|
|
|
|
|
|
|
|
i |
|
|
|
i |
|
|
( yi yx ) |
|
|||||||||
1 |
45 |
52 |
|
|
|
–43,7 |
|
|
–50,6 |
|
|
1909,7 |
|
|
2560,30 |
2211,22 |
|
53,66 |
2,76 |
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
2 |
54 |
70 |
|
|
|
–34,7 |
|
|
–32,6 |
|
|
1204,1 |
|
|
1062,76 |
1131,22 |
|
63,74 |
39,19 |
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||
3 |
63 |
74 |
|
|
|
–25,7 |
|
|
–28,6 |
|
|
660,5 |
|
|
|
817,96 |
735,02 |
|
73,82 |
0,03 |
|
||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
4 |
74 |
87 |
|
|
|
–14,7 |
|
|
–15,6 |
|
|
216,06 |
|
|
243,36 |
229,32 |
|
86,14 |
0,74 |
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
5 |
85 |
92 |
|
|
|
–3,7 |
|
|
–10,6 |
|
|
13,69 |
|
|
|
112,36 |
|
|
39,22 |
|
98,46 |
41,73 |
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
6 |
93 |
117 |
|
|
|
4,3 |
|
14,4 |
|
|
|
18,49 |
|
|
|
207,36 |
|
|
61,92 |
|
107,42 |
91,78 |
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
7 |
104 |
123 |
|
|
|
15,3 |
|
20,4 |
|
|
|
234,09 |
|
|
416,16 |
312,12 |
|
119,74 |
10,63 |
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
8 |
111 |
121 |
|
|
|
22,3 |
|
18,4 |
|
|
|
427,29 |
|
|
338,56 |
410,32 |
|
127,58 |
43,3 |
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
9 |
123 |
133 |
|
|
|
34,3 |
|
30,4 |
|
|
|
1176,49 |
|
924,16 |
1042,72 |
|
141,02 |
64,32 |
|
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
10 |
135 |
157 |
|
|
|
46,3 |
|
54,4 |
|
|
|
2143,69 |
|
2959,36 |
2518,72 |
|
154,46 |
6,45 |
|
||||||||||||||
∑ |
887 |
1026 |
|
|
|
|
|
|
|
|
|
8004,01 |
|
9642,34 |
8691,8 |
|
1026,04 |
300,91 |
|
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
Далее рассчитаем: |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||
|
|
x |
887 |
88,7 ; |
y |
1026 |
|
102,6 ; |
|
xy |
8691,8 |
869,18 ; |
|
|
|||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||||
|
|
|
10 |
|
|
|
|
|
|
|
10 |
|
|
|
|
|
|
|
|
|
10 |
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||
|
|
|
|
s |
|
|
8004,01 |
28, 29 ; |
s |
|
9642,34 |
|
32,05 ; |
|
|
|
|||||||||||||||||
|
|
|
|
X |
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||||||
|
|
|
|
|
|
|
10 |
|
|
|
|
|
|
|
|
|
Y |
|
|
10 |
|
|
|
|
|
|
|
||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
0,99 |
32,05 |
|
1,12 ; |
|
|
|
102,6 88,7 1,12 3,26 . |
|
|
||||||||||||||||||||||
|
|
|
|
|
|
|
|||||||||||||||||||||||||||
|
|
|
1 |
|
|
|
28,29 |
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
Уравнение линейной регрессии Y на X имеет следующий вид: y = 3,26 + 1,12 x.
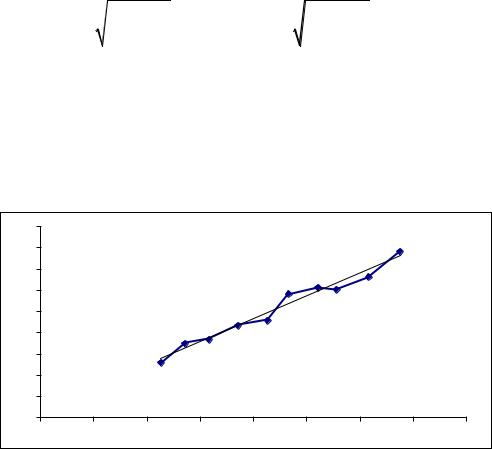
На рис. 1 приведены эмпирические и теоретические значения.
180 |
|
|
|
|
|
|
|
|
160 |
|
|
|
|
|
|
|
|
140 |
|
|
|
|
|
|
|
|
120 |
|
|
|
|
|
|
|
|
100 |
|
|
|
|
|
|
|
|
80 |
|
|
|
|
|
|
|
|
60 |
|
|
|
|
|
|
|
|
40 |
|
|
|
|
|
|
|
|
20 |
|
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
|
|
0 |
20 |
40 |
60 |
80 |
100 |
120 |
140 |
160 |
Рис. 1. Графики эмпирической и теоретической регрессии
Проверку адекватности полученной модели проводят с помощью F- теста. Для этого используется критерий Фишера.
18

Статистика критерия Фишера рассчитывается по формуле
|
n |
|
|
|
|
n k yx y |
|
||
|
|
ˆ |
2 |
|
|
|
|
|
|
Fp |
i 1 |
|
|
. |
n |
|
|
||
|
k 1 yx yi |
|
||
|
|
ˆ |
2 |
|
|
|
|
|
|
i 1
Здесь k – число параметров, оцениваемых по выборке. В нашем случае k = 2, потому что в уравнении линейной регрессии было два неизвестных коэффициента.
Теоретическое значение критерия выбирается из табл. П5 приложения:
1 k 1; 2 n k . Модель считается адекватной при уровне значимости α = 0,05, если Fp Fт .
Для нашего примера Fp = 269,76; v1 = 1; v2 = 8, соответствующее значение Fm = 5,32. Очевидно, модель линейной регрессии можно считать адекватной.
РЕКОМЕНДАЦИИ ПО ВЫПОЛНЕНИЮ КОНТРОЛЬНОЙ РАБОТЫ
Дана выборка объемом 150. Сгруппируем выборку и запишем ряды абсолютных и относительных частот. Для этого вычислим размах выборки: R = xmax – xmin = 53,62 – 25,52 = 28,1. Выберем число интервалов по формуле Стэрджесса: k 1 3,32lg150 8 , тогда длина одного интервала:
h Rk 3,5125 .
Группируем полученные данные и подсчитываем число элементов выборки, попавших в каждый интервал, при этом элемент, совпавший с верхней границей интервала группировки, относим к последующему интервалу. Результаты запишем в табл. 2.
|
|
|
Таблица 2 |
|
|
|
|
|
|
Номер |
Интервалы |
Частоты |
Середины |
|
интервала |
интервалов |
|||
|
|
|||
1 |
25,52–29,03 |
2 |
27,28 |
|
2 |
29,03–32,55 |
10 |
30,79 |
|
3 |
32,55–36,06 |
23 |
34,31 |
|
4 |
36,06–39,57 |
21 |
37,82 |
|
5 |
39,57–43,08 |
33 |
41,33 |
|
6 |
43,08–46,60 |
32 |
44,82 |
|
7 |
46,60–50,11 |
19 |
48,36 |
|
8 |
50,11–53,62 |
10 |
51,87 |
|
∑ |
|
150 |
|
19
Контроль: сумма абсолютных частот по всем интервалам группировки равна объему выборки 150.
Представим выборку графически. Для это нужно построить два графика:
1)полигон абсолютных частот – ломаную линию с вершинами в точках с координатами xi ,mi . За xi примем середины интервалов;
2)ненормированную гистограмму. Для этого на оси абсцисс отложим промежутки, а на оси ординат – частоты.
Оформление произвольное. Графики приведены во второй части примера, для их построения использован Excel.
Найдем характеристики вариации. Для этого таблицу можно расширить или сделать новую (табл. 3).
|
|
|
|
|
|
Таблица 3 |
|
|
|
|
|
|
|
i |
Середина |
Частота |
mi x i |
mi xi x 2 |
mi xi x 3 |
mi xi x 4 |
|
интервала x i |
mi |
|
|
|
|
1 |
27,28 |
2 |
54,56 |
389,21 |
–5429,41 |
75740,27 |
|
|
|
|
|
|
|
2 |
30,79 |
10 |
307,93 |
1089,41 |
–11370,8 |
118682,3 |
|
|
|
|
|
|
|
3 |
34,31 |
23 |
789,15 |
1102,98 |
–7638,13 |
52894,07 |
|
|
|
|
|
|
|
4 |
37,82 |
21 |
794,17 |
244,55 |
–834,521 |
2847,803 |
|
|
|
|
|
|
|
5 |
41,33 |
33 |
1363,89 |
0,33 |
0,033 |
0,0033 |
|
|
|
|
|
|
|
6 |
44,82 |
32 |
1434,96 |
417,61 |
1508,598 |
5449,811 |
|
|
|
|
|
|
|
7 |
48,36 |
19 |
918,75 |
964,55 |
6872,396 |
48965,82 |
|
|
|
|
|
|
|
8 |
51,87 |
10 |
518,68 |
1131,56 |
12037,01 |
128043,7 |
|
|
|
|
|
|
|
∑ |
|
150 |
6181,94 |
5340,193 |
–4854,78 |
432623,8 |
|
|
|
|
|
|
|
Найдем выборочное среднее по формуле (2): xв 6181,94 41,23 и 150
5340,19
дисперсию по формуле (4): Dв 35,60. Исправленная выбороч-
150
ная дисперсия по формуле (5) равна 35,84. Соответственно исправленное среднее квадратическое отклонение s = 5,99.
Медианный интервал у нашей выборки имеет номер 5. Тогда
по формуле (6) вычислим: Me 39,57 3,510,5 150 56 41,59 . Модаль-
33
ный интервал тоже пятый. Распределение унимодальное, значение моды по формуле (7):
Mo 39,57 3,51 |
33 21 |
42,80 . |
|
|||
|
|
|||||
33 21 33 32 |
|
|||||
Коэффициент асимметрии по формуле (8): As |
4854,78 |
|
0,15. |
|||
5,99 3 150 |
||||||
|
|
|
|
|||
20