Материал: Кластеризация данных. методические указания к выполнению практических работ для студентов направления 09.04.03 «Прикладная информатика». Головинский П.А., Шаталова А.О

|
3) |
метрику Минковского |
|
|
|
|||||
|
|
( , ) = |
( 1 |
− 1) + ( 2 − 2) + ( − ) , ≥ 1. |
(7) |
|||||
|
Метрика Минковского |
позволяет регулировать степень удаленность эле- |
||||||||
ментов друг от друга по сравнению с евклидовой метрикой. |
|
|||||||||
|
4) |
метрику Махаланобиса |
|
|
|
|||||
|
|
|
|
|
( , ) = ( − ) −1( − ) = |
(8) |
||||
|
( ) |
= |
=1 |
=1 |
( − ) −1 − |
|
||||
где |
– ковариационная матрица данных. Эта метрика позволяет учитывать |
|||||||||
|
||||||||||
распределение элементов и их взаимозависимость. |
|
|||||||||
|
5) |
метрику Канберра |
( , ) = ∑ =1 | |+| | |
|
||||||
|
|
|
|
|
|
|||||
|
|
|
|
|
|
|
| − | |
. |
(9) |
|
Данная метрика определена, если хотя бы один из двух элементов отличен от нуля.
Можно убедиться, что все перечисленные способы задания метрики удовлетворяет необходимым свойствам метрики, т.е. метрики положительны, выполняется правило треугольника и расстояние между тождественными объектами равно нулю. Очевидно, что выбор метрики может существенно отразиться на процедуре и результатах кластеризации. Например, находящиеся на одном расстоянии по евклидовой метрике точки могут быть на разном расстоянии по манхэттенской метрике, поскольку при одинаковой длине гипотенузы у прямоугольных треугольников могут быть совсем разные катеты и разная сумма их длин. Ясно, что при решении задачи кластеризации желательно выбирать метрику, наиболее точно соответствующую характеру анализируемых данных. В случае если такой выбор заранее неизвестен или неясен, обычно используют евклидову метрику.
Дальнейшее распределение элементов по классам предполагает разделение на кластеры и задание способа определения принадлежности элемента к тому или иному кластеру.
4. ОПРЕДЕЛЕНИЕ РАССТОЯНИЯ МЕЖДУ ВЕКТОРОМ-ОБРАЗОМ ЭЛЕМЕНТА И КЛАССОМ
Если мы сможем определить центр кластера ( ), соответствующего данному классу k, то в качестве естественной меры расстояния от данного образа
6
до класса |
можно выбрать расстояние до центра кластера |
|
( ) |
|
|
в соот- |
||||||||
|
|
( ) |
|
|||||||||||
ветствии с выбранной для классификации метрикой. |
Центр |
|
|
класса) |
|
|||||||||
|
( , |
|
|
|||||||||||
можно определить как среднее арифметическое по |
точкам кластера |
: |
|
|||||||||||
|
|
( ) = 1 |
∑ . |
|
|
|
|
|
|
|
|
(10) |
||
Принадлежность к кластеру |
|
определяется условием ближайшего цен- |
||||||||||||
тра кластера |
|
) = min ( , |
|
) |
|
|
|
|
|
|
|
|
||
|
( , |
( ) |
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
(11) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Другим простым способом определения расстояния от пробного элемента (образа) до класса является метод ближайшего соседа из кластера, т.е. находят
ближайший элемент из всех, и пробный элемент относят к его кластеру |
|
|||
( , |
) = min ( , |
) |
|
|
|
|
|
. |
(12) |
|
|
|
||
В ряде случаев класс плохо описывается одним эталонным образом в виде центра кластера, например, при сильной вытянутости или разветвленности (изрезанности) кластера. В этом случае его можно характеризовать несколькими эталонными образами и вычислять расстояние между предъявляемым образом и классом, как расстояние до ближайшего эталонного образа данного класса.
5.АЛГОРИТМЫ КЛАСТЕРИЗАЦИИ
Кластеризация проводится с целью разделения всего множества элементов на группы похожих между собой. Задача кластеризации элементов обладает значительной неопределенностью в своей постановке. Во-первых, необходимо определить параметры, характеризующие элементы и задать метрику. Вовторых, результат кластеризации зависит от числа задаваемых кластеров, которое чаще всего нужно определить заранее.
Рассмотрим некоторые из основных алгоритмов классификации. A. Алгоритм k-групповых средних.
Этот алгоритм является итерационным( ) . В методе k-средних сначала слу-
чайным образом выбираются центры для k кластеров. Далее согласно близости к одному из заданных таким образом центров все данные группируются в кластеры. Далее за следующий центр кластера принимается среднее значение координат элементов из данного кластера. Затем процедура повторяется, и состав кластеров может измениться. Итерации производятся до сходимости алгоритма, т.е. до тех пор, пока состав кластеров не перестает изменяться. Итерации быстро сходятся. Но результат зависит от инициации.
7
Вариантом решения этой проблемы является многократный прогон про-
цедуры с тем, чтобы выбрать из полученных результатов наилучший, напри- |
|
мер, с минимальной суммой дисперсий каждом из кластеров |
|
= ∑ . |
(13) |
Рассмотренный нами алгоритм относится к семейству так называемых методов жесткой кластеризации, когда каждый образец из набора предназначен строго одному кластеру.
B.Алгоритмы мягкой (нечеткой) кластеризации.
В отличие от алгоритмов жесткой кластеризации, алгоритмы мягкой кластеризации (fuzzy clustering) назначают образец в той или иной степени нескольким кластерам. Степенью принадлежности можно управлять с помощью коэффициента нечеткости. Такой подход позволяет сформулировать алгоритм нечетких k-средних, или, иначе алгоритм c-средних.
C.Иерархическая кластеризация.
Среди алгоритмов иерархической кластеризации выделяют восходящие и нисходящие алгоритмы. В нисходящих алгоритмах вначале все объекты помещаются в один кластер. Затем он разбивается на все более мелкие кластеры. Восходящие алгоритмы в начале работы помещают каждый объект в отдельный кластер, а затем объединяют кластеры во все более крупные, пока все объекты выборки не будут содержаться в одном кластере. Таким образом, строится система вложенных разбиений. Результаты работы таких алгоритмов принято представлять в виде дерева – так называемой дендрограммы. Она показывает детализацию разбиения данных на все большее количество кластеров.
D.Самоорганизующиеся карты Кохонена.
Карты Кохонена дают простой и высокоэффективный метод кластеризации при заданном количестве кластеров. Сначала производится инициализация сети путем выбора случайных векторов в пространстве признаков, или выбора случайным образом k- векторов из набора данных. Далее случайным образом предъявляется один из векторов массива данных, и ближайший вектор сети (центр кластера) смещается в его сторону. Это смещение тем меньше, чем боле расстояние между вектором данных и центром кластера. Убывание смещения с расстоянием чаще всего выбирают в форме функции Гаусса. Далее процесс повторяется, а шаги постепенно уменьшаются. Полученную карту удобнее всего отображать на двумерной картине узлов.
E.Гравитационная кластеризация.
Алгоритм карт Кохонена можно рассматривать как физическое притяжение пробных частиц (центров кластеров) к ближайшим частицам среды. Другим вариантом физической аналогии является алгоритм гравитационной кластеризации. Согласно этому алгоритму точки данных притягиваются друг другу с «силой», убывающей с расстоянием, подобно закону всемирного тяготения
8
Ньютона. Движение под действием такой «силы» будет приводить к слипанию частиц и автоматической кластеризации данных.
Перечисленные нами методы кластеризации не учитывают более глубокие свойства данных, например их симметрию, позволяющую установить сходство между внешне разными объектами. Кроме того, кластеризация данных возможна не всегда. Выбранные признаки могут оказаться таковы, что они не позволят различить элементы, относящиеся к разным группам. Возможно также, что различия между группами элементов могут быть слишком малы для уверенного разделения их на классы.
6.ПРОГРАММА КЛАСТЕРИЗАЦИИ МЕТОДОМ
K-СРЕДНИХ [7,8]
Программа кластеризации методам k-средних состоит из трех шагов:
1.Инициализация.
2.Присвоение.
3.Обновление.
При работе потребуется использовать пакет pandas
https://benalexkeen.com/k-means-clustering-in-python/
П.1. Инициализация
____________________________________________________________________
import pandas as pd import numpy as np
import matplotlib.pyplot as plt #matplotlib in line
df = pd.DataFrame({
'x': [12, 20, 28, 18, 29, 33, 24, 45, 45, 52, 51, 52, 55, 53, 55, 61, 64, 69, 72], 'y': [39, 36, 30, 52, 54, 46, 55, 59, 63, 70, 66, 63, 58, 23, 14, 8, 19, 7, 24] })
np.random.seed(200) k = 3
# centroids[i] = [x, y] centroids = {
i+1: [np.random.randint(0, 80), np.random.randint(0, 80)] for i in range(k)
}
fig = plt.figure(figsize=(5, 5)) plt.scatter(df['x'], df['y'], color='k') colmap = {1: 'r', 2: 'g', 3: 'b'}
for i in centroids.keys():
9
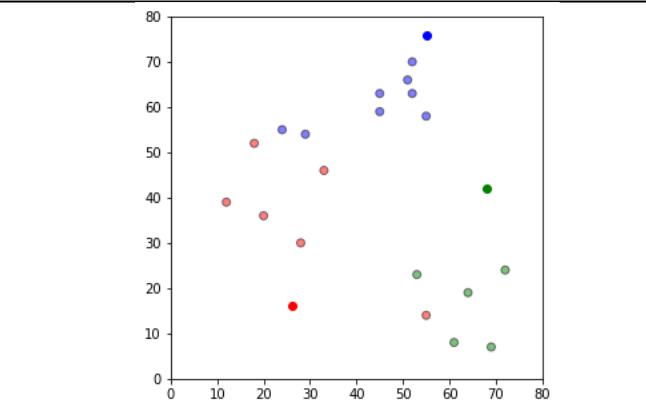
plt.scatter(*centroids[i], color=colmap[i]) plt.xlim(0, 80)
plt.ylim(0, 80) plt.show()
Рис. 1. Исходные данные
П.2. Стадия присвоения центров кластеров и нахождения их элементов
______________________________________________________________
df = pd.DataFrame({
'x': [12, 20, 28, 18, 29, 33, 24, 45, 45, 52, 51, 52, 55, 53, 55, 61, 64, 69, 72], 'y': [39, 36, 30, 52, 54, 46, 55, 59, 63, 70, 66, 63, 58, 23, 14, 8, 19, 7, 24]
})
np.random.seed(200) k = 3
# centroids[i] = [x, y] centroids = {
i+1: [np.random.randint(0, 80), np.random.randint(0, 80)] for i in range(k)
}
fig = plt.figure(figsize=(5, 5)) plt.scatter(df['x'], df['y'], color='k') colmap = {1: 'r', 2: 'g', 3: 'b'}
for i in centroids.keys():
10