Материал: КонспектНМ14_2018
Узагальнення алгоритму нечітких с-середніх
У базовому
алгоритмі нечітких с-середніх відстань
між об'єктом
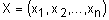 і центром кластера
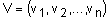 розраховується через стандартну норму
Евкліда:
 .
У кластерному аналізі застосовуються
і інші норми, серед яких часто
використовується діагональна норма і
норма Махалонобіса.
У
загальному вигляді норму можна задати
через симетричну позитивно певну матрицю
B розміром
 таким
чином:
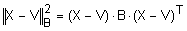 ,
де T – операція транспонування.
Для норми Евкліда матриця B є одиничною матрицею:
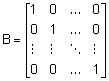 .
Евклідова норма дозволяє виділяти кластери у вигляді гіперсфер.
Для діагональної норми матриця B задається таким чином:
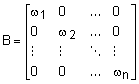 .
Елементи головної діагоналі матриці інтерпретуються як ваги координат. Діагональна норма дозволяє виділяти кластери у вигляді гіпереліпсоїдів, що орієнтовані уздовж координатних вісей.
Для
норми Махалонобіса матриця B розраховується
через коваріаційну матрицю від
 :
 ,
де
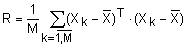 – коваріаційна матриця;
 – вектор
середніх значень даних.
Норма Махаланобіса дозволяє виділяти кластери у вигляді гіпереліпсоїдів, вісі яких можуть бути орієнтовані в довільних напрямах.
Приклади ізоліній різних норм, показані на рис. 9.1. На рис. 9.2 приведений приклад нечіткої кластеризації методом нечітких с-середніх при використанні відстані Евкліда. На лівій частині рисунка показані дані для кластеризації. На правій частині рисунка приведені результати нечіткої кластеризації. Центри нечітких кластерів позначені символами '+'. Вісім ізоліній функцій приналежності нечітких кластерів побудовано для значень 0.67, 0.71, 0.75, 0.79, 0.83, 0.87, 0.91 і 0.95.
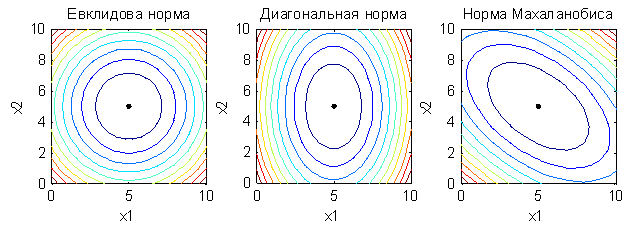
Рис 9.1. Ізолінії різних норм
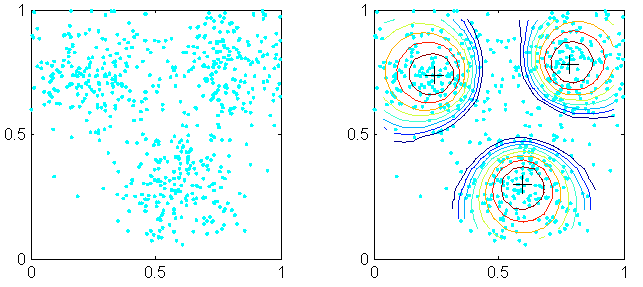
Рис 9.2. Нечітка кластеризація при нормі Евкліда
Для деяких наборів даних "очна кластеризація" дозволяє виділити скупчення даних у вигляді різних геометричних фігур: сфери, еліпсоїди різної орієнтації, ланцюжки і тому подібне В результаті використання алгоритмів кластеризації з фіксованою нормою форма усіх кластерів виходить однаковою. Алгоритми кластеризації якби нав'язують даним невластиву їм структуру, що приводить не тільки до неоптимальних, але іноді і до принципово неправильних результатів, Для усунення цього недоліку запропоновано декілька методів, серед яких виділимо алгоритм Густавсона-Кесселя (Gustafson-Kessel algorithm).
Алгоритм
Густавсона-Кесселя використовує
адаптивну норму для кожного кластера,
тобто для кожного i-го кластера існує
своя норм-породжуюча матриця
 .
У цьому алгоритмі при кластеризації
оптимізуються не тільки координати
центрів кластерів і матриця нечіткого
розбиття, але також і норм-породжуючі
матриці для всіх кластерів. Це дозволяє
виділяти кластери різної геометричної
форми. Критерій оптимальності (9.9)
лінійний відносно відносно
,
тому для отримання ненульових рішень,
вводять деякі обмеження на норм-породжуючі
матриці. У алгоритмі Густавсона-Кесселя
це обмеження на значення визначника
норм-породжуючих матриць:
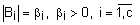 .
Оптимальний розв’язок знаходиться за допомогою методу невизначених множників Лагранжа. Алгоритм Густавсона-Кесселя, в порівнянні з алгоритмом нечітких с-середніх, має значно більшу обчислювальну трудомісткість.
Синтез нечітких правил за результатами нечіткої кластеризації
Нечіткі
правила можна синтезувати за результатами
нечіткої кластеризації. Нехай об'єкти
кластеризації мають дві ознаки ( ).
Тоді результати нечіткого розбиття
можна представити тривимірним графіком:
для кожного об'єкту відкласти по осях
абсцис і ординат значення ознак, а по
вісі аплікат – ступінь приналежності
об'єкту нечіткому кластеру. Кількість
таких графіків буде дорівнювати числу
кластерів (n).
Приклад 9.1. Дані представлені наступною таблицею:
до |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
8 |
9 |
10 |
11 |
12 |
13 |
14 |
15 |
|
1 |
1 |
1 |
3 |
3 |
3 |
5 |
7 |
9 |
11 |
11 |
11 |
13 |
13 |
13 |
|
1 |
4 |
7 |
2 |
4 |
6 |
4 |
4 |
4 |
2 |
4 |
6 |
1 |
4 |
7 |


Графічне
зображення цих даних є "метеликом"
‑ добре відомий в теорії розпізнавання
образів приклад кластеризації. Встановимо
такі параметри алгоритму нечітких
с-середніх: c=2, m=2 і
 .
Після 8-ми ітерацій отримуємо наступне
нечітке розбиття:
до |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
8 |
9 |
10 |
11 |
12 |
13 |
14 |
15 |
|
0.909 |
0.976 |
0.909 |
0.947 |
0.998 |
0.947 |
0.879 |
0.5 |
0.121 |
0.053 |
0.002 |
0.053 |
0.091 |
0.024 |
0.091 |
|
0.091 |
0.024 |
0.091 |
0.053 |
0.002 |
0.053 |
0.121 |
0.5 |
0.879 |
0.947 |
0.998 |
0.947 |
0.909 |
0.976 |
0.909 |


Значення критерію (9.9) для цього нечіткого розбиття дорівнює 82.94. Тривимірні зображення нечітких кластерів приведені на рис. 9.3.
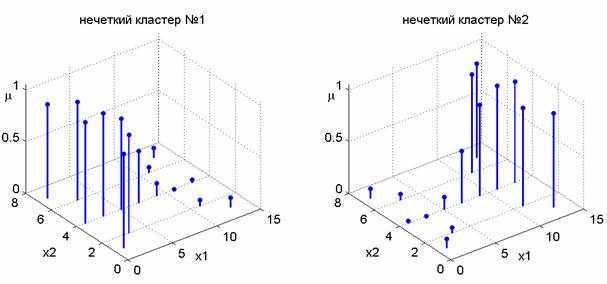
Рис. 9.3. Нечіткі кластери з прикладу 9.1.
Функції приналежності нечітких кластерів (рис. 9.3) нагадують нечіткі відношення (див. рис. 9.1). Отже, кожному кластеру можна поставити у відповідність одне нечітке правило. За результатами нечіткої кластеризації можна синтезувати нечіткі правила різних баз знань: синглтонної, Мамдані і Сугено. Функції приналежності термів в посилках правила виходять проектуванням ступенів приналежності відповідного кластера (рядку матриці нечіткого розбиття ) на вхідні змінні. Потім отримані множини ступенів приналежності апроксимують відповідними параметричними функціями приналежності.
В якості висновку правила синглтонної бази знань вибирають координату центру кластера. Висновки правил бази знань Мамдані знаходять також як і функції приналежності термів вхідних змінних. Висновки правил бази знань Сугено знаходять по методу найменших квадратів. При кластеризації з використанням норми Махалонобіса в якості висновків правил типу Сугено можуть бути вибрані рівняння довгих вісей гіпереліпсоїдів.
Кластеризація без завдання кількості кластерів
На початку розділу висловлюються основні ідеї методу гірської кластеризації, який не вимагає завдання кількості кластерів. Метод запропонований Р. Ягером і Д. Фільовим в 1993 р. Кластеризація за гірським методом не є нечіткою, проте, її часто використовують при синтезі нечітких правил з даних.
Основні ідеї методу гірської кластеризації
На першому кроці гірської кластеризації визначають точки, які можуть бути центрами кластерів. На другому кроці для кожної такої точки розраховується значення потенціалу, що показує можливість формування кластера в її околиці. Чим щільніше розташовані об'єкти в околиці потенційного центру кластера, тим вище значення його потенціалу. Після цього ітераційно вибираються центри кластерів серед точок з максимальними потенціалами.
На
першому кроці необхідно
сформувати потенційні центри кластерів.
Для алгоритму гірської кластеризації
число потенційних центрів кластерів
(Q) повинне бути скінченним. Ними можуть
бути об'єкти кластеризації (рядки матриці
),
тоді
 .
Другий спосіб вибору потенційних центрів
кластерів полягає в дискретизації
простору вхідних ознак. Для цього
діапазони зміни вхідних ознак розбивають
на декілька інтервалів. Проводячи через
точки розбиття прямі, паралельні
координатним осям, отримуємо "решіточний"
гіперкуб. Вузли цієї решітки і
відповідатимуть центрам потенційних
кластерів. Позначимо через
 – кількість значень, які можуть приймати
центри кластерів по й координаті (
 ).
Тоді кількість можливих кластерів буде
дорівнювати:
 .
На другому кроці алгоритму розраховується потенціал центрів кластерів за наступною формулою:
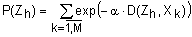 ,
 ,
де
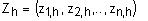 – потенційний центр h-го кластера
;
 – позитивна константа;
 – відстань між потенційним центром
кластера (
 )
і об'єктом кластеризації (
 ).
У евклідовому просторі ця відстань
розраховується по формулі:
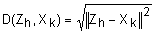 .
У разі, коли об'єкти кластеризації задані двома ознаками ( ), графічне зображення розподілу потенціалу буде поверхнею, що нагадує гірський рельєф. Звідси і назва – гірський метод кластеризації.
На третьому кроці алгоритму в якості центрів кластерів вибирають координати "гірських" вершин. Для цього, центром першого кластера призначають точку з найбільшим потенціалом. Зазвичай, найвища вершина оточена декількома достатньо високими піками. Тому призначення центром наступного кластера точки з максимальним потенціалом серед вершин, що залишилися, привело б до виділення великого числа близько розташованих центрів кластерів. Щоб вибрати наступний центр кластера необхідно спочатку виключити вплив тільки що знайденого кластера. Для цього значення потенціалу для можливих центрів кластерів, що залишилися, перераховується таким чином: від поточних значень потенціалу віднімають внесок центру тільки що знайденого кластера (тому кластеризацію по цьому методу іноді називають субтрактивнодю). Перерахунок потенціалу відбувається за формулою:
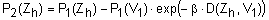 ,
де
 – потенціал на 1-ій ітерації;
 – потенціал на 2-ій ітерації;
 –
центр першого знайденого кластера:
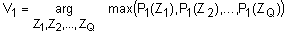 ;
 –
позитивна константа.
Центр другого кластера визначається по максимальному значенню оновленого потенціалу:
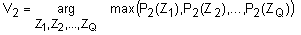 .
Потім знову перераховується значення потенціалів:
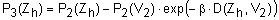 .
Ітераційна процедура перерахунку потенціалів і виділення центрів кластерів продовжується до тих пір, поки максимальне значення потенціалу перевищує деякий поріг.
Синтез нечіткої бази знань на основі гірської кластеризації
Позначимо
через
 – центри кластерів, що знайдені в
результаті гірської кластеризації. Для
спрощення викладень приймемо, що центри
кластерів задані двома координатами:
 ,
.
Завдання полягає в синтезі нечітких
правил, що пов'язують вхід (x) з виходом
(y).
Центру
кластера
 (
)
ставиться у відповідність одне нечітке
правило: