Материал: КонспектНМ14_2018
Рис. 8.16. Графіки функцій приналежності для термів лінгвістичної змінної "Температура води" (а) і лінгвістичної змінної "Кут повороту вентиля крану" (б)
Використовуючи в якості алгоритму виведення алгоритм Мамдані, розглянемо приклад його виконання для випадку, коли поточна температура води на виході змішувача дорівнює 55°С. В цьому випадку фазифікація вхідної лінгвістичної змінної приводить до значень ступенів істинності 0.5 для правил нечітких продукцій з номерами 2 і 3. Ці правила вважаються активними і використовуються в поточному процесі нечіткого виведення.
Оскільки всі умови в правилах 1 – 5 задані у формі нечітких лінгвістичних висловів першого виду, етап їх агрегації тривіальний і залишає ступені істинності 0.5 без зміни.
Наступним етапом нечіткого виведення є активізація висновків в нечітких правилах продукцій. Оскільки всі висновки правил 1 – 5 задані у формі нечітких лінгвістичних висловів першого виду, а вагові коефіцієнти правил за умовчанням дорівнюють 1, то активізація правил 2 і 3 приводить до нечітких множин, функції приналежності яких зображені на рис. 8.17, а.
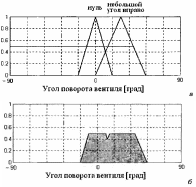
Рис. 8.18. Графіки функції приналежності для двох термів вихідної лінгвістичної змінної "Кут повороту вентиля крану" (а) і функції приналежності після акумуляції (б)
Акумуляція висновків нечітких правил продукцій з використанням операції max-диз’юнкції для правил 2 і 3 призводить в результаті до нечіткої множини, функція приналежності якої зображена на рис. 8.17, б.
Дефазифікація вихідної лінгвістичної змінної "Кут повороту вентиля крану" методом центру тяжіння для значень функції приналежності, зображена на рис. 8.17, приводить до значення керуючої змінної, що дорівнює повороту вентиля крану вправо на 16° (наближене значення). Це значення і є результатом розв’язання задачі нечіткого виведення для поточного значення вхідної лінгвістичної змінної "Температура води".
Для реалізації цього алгоритму нечіткого управління необхідно організувати періодичне вимірювання температури води на виході змішувача в деякі дискретні моменти часу. При цьому, чим менше інтервал вимірювання цієї температури, тим вище виявляється точність регулювання температури води.
Що стосується реалізації власне процедури нечіткого управління, то для цієї мети необхідно використовувати відповідні програмні або апаратні засоби, спеціально призначені для виконання всіх етапів нечіткого виведення. Зокрема, для цієї мети можуть бути застосовані спеціальні програмовані нечіткі контролери, які можуть реалізовувати програму нечіткого виведення, записану, наприклад, на мові нечіткого управління або мови FCL.
Контрольні питання
Алгоритм нечіткого логічного виведення Мамдані.
Алгоритм нечіткого логічного виведення Сугено-Такагі.
Алгоритм нечіткого логічного виведення Ларсена.
Алгоритм нечіткого логічного виведення Цукамото.
Спрощений алгоритм нечіткого логічного виведення (за сінглтонною базою знань).
Тема 8. Методи нечіткої кластеризації.
Кластеризація – це об'єднання об'єктів в групи (кластери) на основі схожості ознак для об'єктів однієї групи і відмінностей між групами. Більшість алгоритмів кластеризації не спираються на традиційні для статистичних методів допущення; вони можуть використовуватися в умовах майже повної відсутності інформації про закони розподілу даних. Кластеризацію проводять для об'єктів з кількісними (числовими), якісними або змішаними ознаками. У цьому розділі розглядається кластеризація тільки для об'єктів з кількісними ознаками. Початковою інформацією для кластеризації є матриця спостережень:
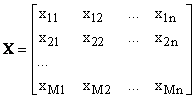 ,
кожна строчка якої є значеннями n ознак одного з M об'єктів кластеризації.
Завдання кластеризації полягає в розбитті об'єктів з Х на декілька підмножин (кластерів), в яких об'єкти більш схожі між собою, чим з об'єктами з інших кластерів. У метричному просторі "схожість" зазвичай визначають через відстань. Відстань може розраховуватися як між початковими об'єктами (строчками матриці Х), так і від цих об'єктів до прототипу кластерів. Зазвичай координати прототипів заздалегідь невідомі – вони знаходяться одночасно з розбиттям даних на кластери.
Існує багато методів кластеризації, які можна класифікувати на чіткі і нечіткі. Чіткі методи кластеризації розбивають початкову множину Х об'єктів на декілька непересічних підмножин. При цьому будь-який об'єкт з Х належить тільки одному кластеру. Нечіткі методи кластеризації дозволяють одному і тому ж об'єкту належати одночасно декільком (або навіть всім) кластерам, але з різним ступенем приналежності. Нечітка кластеризація в багатьох ситуаціях "природніша", ніж чітка, наприклад, для об'єктів, розташованих на межі кластерів.
Методи кластеризації також класифікуються по тому, чи визначена кількість кластерів заздалегідь чи ні. У останньому випадку кількість кластерів визначається в ході виконання алгоритму на основі розподілу початкових даних. На початку розглянемо алгоритм с-середніх, що розбиває дані на наперед задане число кластерів, а потім алгоритм гірської кластеризації, який не вимагає завдання кількості кластерів.
Кластеризація при заданому числі кластерів
На початку розглянемо ключові ідеї чіткої кластеризації алгоритмом с-середніх, потім базовий нечіткий алгоритм с-середніх і на закінчення основні шляхи поліпшення нечіткої кластеризації.
Чітка кластеризація алгоритмом с-середніх
При
кластеризації алгоритмом с-середніх
множина Х
розбивається
на підмножини
 ,
 ,
з наступними властивостями:
 (9.1)
 ,
 ,
(9.2)
 ,
.
(9.3)
Умова
(9.1) вказує, що всі об'єкти повинні бути
розподілені по кластерах. При цьому,
кожен об'єкт повинен належати тільки
одному кластеру (умова (9.2)) і жоден з
кластерів не може бути порожнім або
містити всі об'єкти (умова (9.3)). Кількість
кластерів
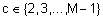 задається до початку роботи алгоритму.
Завдання кластеризації зручно формулювати використовуючи характеристичну функцію. Характеристична функція може приймати два значення: 0 – якщо елемент не належить кластеру, і 1 – якщо елемент належить кластеру. Використовуючи характеристичну функцію, опишемо кластери наступною матрицею розбиття:
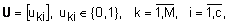 ,
де k-ий
рядок матриці
 вказує на приналежність об'єкту
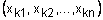 до кластерів
 .
Матриця повинна володіти такими властивостями:
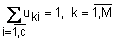 (9.4)
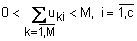 (9.5)
Для оцінки якості розбиття використовується критерій розкиду, що показує суму відстаней від об'єктів до центру свого кластера. Для евклідового простору цей критерій записується так:
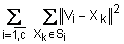 (9.6)
де
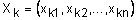 – k-ий
об'єкт кластеризації;
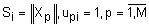 – i-ий
кластер;
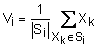 – центр
i-го кластера.
Кластеризацію об'єктів Х можна сформулювати як наступне завдання оптимізації: знайти матрицю , що мінімізує значення критерію (9.6). Дискретний характер чіткого розбиття призводить до труднощів знаходження оптимальної кластеризації із-за негладкості цільової функції.
Базовий алгоритм нечітких с-середніх
Нечіткі кластера опишемо наступною матрицею нечіткого розбиття:
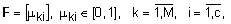
у якій
k-ий
рядок містить ступені приналежності
об'єкту
до кластерів
.
Єдиною відмінністю матриць
 і
є те, що при нечіткому розбитті ступінь
приналежності об'єкту до кластера
приймає значення з інтервалу [0, 1], а
при чіткому – з двоелементної множини
{0, 1}. Аналогічні (9.4) - (9.5), умови для
матриці нечіткого розбиття записуються
так:
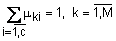 (9.7)
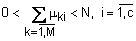 (9.8)
Нечітке
розбиття дозволяє просто вирішити
проблему об'єктів, розташованих на межі
двох кластерів, – їм призначають ступені
приналежності, що дорівнюють 0.5. Недолік
нечіткого розбиття виявляється при
роботі з об'єктами, віддаленими від
центрів всіх кластерів. Віддалені
об'єкти мають мало загального з будь-яким
з кластерів, тому інтуїтивно хочеться
призначити для них малі ступені
приналежності. Проте, за умовою (9.7) сума
їх ступенів приналежності така ж, як і
для об'єктів, близьких до центрів
кластерів, тобто дорівнює одиниці. Для
усунення цього недоліку можна
використовувати можливістне розбиття,
яке вимагає, тільки щоб довільний об'єкт
з Х
належав
хоч би одному кластеру. Можливістне
розбиття можна отримати наступним
ослабленням умови (9.7):
 .
Для оцінки якості нечіткого розбиття використовується такий критерій розкиду:
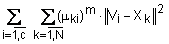 (9.9)
де
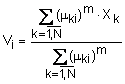 – центри нечітких кластерів;
 – експоненціальна вага, що визначає
нечіткість, розмазаність кластерів.
Запропоновано безліч алгоритмів нечіткої кластеризації, що засновані на мінімізації критерію (9.9). Знаходження матриці нечіткого розбиття з мінімальним значення критерію (9.9) є завданням нелінійної оптимізації, яка може бути вирішена різними методами. Найбільш відомий і часто вживаний метод рішення цієї задачі алгоритм нечітких с-середніх, в основу якого покладений метод невизначених множників Лагранжа. Він дозволяє знайти локальний оптимум, тому виконання алгоритму з різних початкових точок може привести до різних результатів.
Алгоритм нечітких с-середніх.
Крок
1. Встановити
параметри алгоритму: c
– кількість кластерів; m – експоненціальна
вага;
 – параметр останову алгоритму.
Крок 2. Випадковим чином згенерувати матрицю нечіткого розбиття , що задовольняє умовам (9.7), (9.8).
Крок 3. Розрахувати центри кластерів:
, .
Крок
4. Розрахувати
відстані між об'єктами з і центрами
кластерів: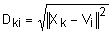 ,
 ,
.
Крок 5. Перерахувати елементи матриці нечіткого розбиття ( , ):
якщо
 :
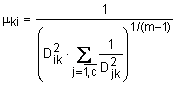 ;
якщо
 :
 ,
 .
Крок
6. Перевірити
умову
 ,
де
 – матриця нечіткого розбиття на
попередній ітерації алгоритму. Якщо
"так", то перейти до кроку 7, інакше
– до кроку 3.
Крок 7. Кінець.
У приведеному алгоритмі найважливішим параметром є кількість кластерів (c). Правильно вибрати кількість кластерів для реальних завдань без якої-небудь апріорної інформації про структуру даних досить складно. Існує два формальні підходи до вибору числа кластерів.
Перший підхід заснований на критерії компактності і роздільності отриманих кластерів. Логічно припустити, що при правильному виборі кількості кластерів дані будуть розбиті на компактні і добре розділені одна від одної групи. Інакше, кластери, ймовірно, не будуть компактними і добре розділеними. Існує декілька критеріїв оцінки компактності кластерів, проте питання про те, як формально і достовірно визначити правильність вибору кількості кластерів для довільного набору даних все ще залишається відкритим. Для алгоритму нечітких с-середніх рекомендується використовувати індекс Хіє-Бені:
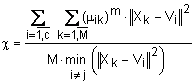 .
Другий підхід пропонує починати кластеризацію при достатньо великому числі кластерів, а потім послідовно об'єднувати схожі суміжні кластери. При цьому використовуються різні формальні критерії схожості кластерів.
Другим
параметром алгоритму кластеризації є
експоненціальна вага (m). Чим більше
 ,
тим кінцева матриця нечіткого розбиття
стає
більш "розмазаною", і при
 вона
прийме вигляд
 ,
що є дуже поганим розв’язком, тому що
всі об'єкти будуть належати до всіх
кластерів з одним і тим же ступенем.
Крім того, експоненціальна вага дозволяє
при формуванні координат центрів
кластерів підсилити вплив об'єктів з
великими значеннями ступенів приналежності
і зменшити вплив об'єктів з малими
значеннями ступенів приналежності. На
сьогодні не існує теоретично обґрунтованого
правила вибору значення експоненціальної
ваги. Зазвичай встановлюють
 .