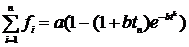Материал: Методы проверки надежности протоколов судовой СЭУ
Нормирование надёжности (безотказности) и времени безвахтенного периода определяется экономической эффективностью. Оптимизация этих параметров будет зависеть от выбранного критерия. Анализ различных подходов к выбору критерия оценки функционирования различных технических средств с позиции надёжность (безотказности) показывает, что целесообразно качественно определять надёжность СЭУ в зависимости от условий заданной эффективности операций, т.е., например, транспортным процессом. В этом случае критериями оценки функционирования СЭУ с позиций надёжности (безотказности) могут быть обеспечение безопасности плавания и обитаемости судна.
Анализ эксплуатационной надёжности показывает, что реальный процесс эксплуатации
СЭУ (чередование работоспособного состояния и восстановления работоспособного состояния (ремонт, техобслуживание) возможно аппроксимировать однородным Марковским случайным процессом.
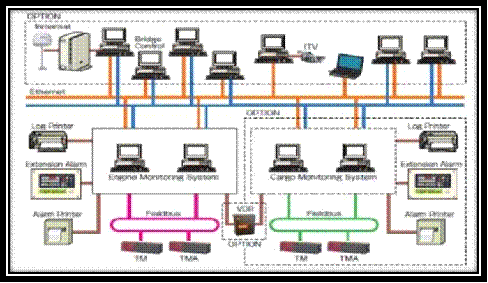
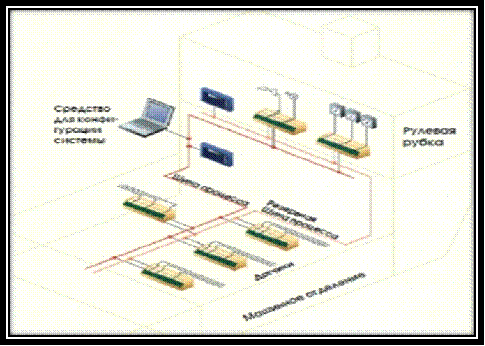
Но на практике всё это реализовано с помощью систем мониторинга. Судовые системы мониторинга предназначены для определения рабочих параметров систем оповещения и защиты при возникновении неисправностей во время эксплуатации. Анализ рабочих параметров позволяет производить оценку работы оборудования и вовремя предотвращать неисправности.
На нашем примере Система может иметь конфигурацию от 16 до
00 каналов. Подключение и обработка сигналов распределена между несколькими блоками обработки DPU (DistRibuted PRocessing Unit), которые обмениваются информацией по резервной шине CAN (ContRolleR ARea NetwoRk). Аварийные сигналы и события формируются в DPU и доступны как для локальной, так и для удаленной операторских станций. Изменение установок (пределов, выдержек времени, пуск / остановка, открытие / закрытие клапанов) и параметров возможно через локальную или удаленную операторскую станцию. Удаленные операторские станции обмениваются информацией по одиночной или дублированной локальной сети LAN (Local ARea NetwoRk), подключенной к сети CAN через одно или несколько сопряженных устройств.
Блоки распределенной обработки (DPU), удаленные операторские станции(ROS) и концентраторы (HUBs) включены в систему диагностики реального времени, которая отслеживает работу каждого модуля и связь между модулями. Система диагностики сообщает оператору обо всех неисправностях.
Ниже будут показаны примеры структурных схем мониторинговых
систем:
3. Алгоритм выбора модели оценки надежности
Перечислим основные факторы, из-за которых SRGM могут работать неточно:
● Малое количество данных. Причиной может быть, например, то, что данные тестирования группируются по неделям или месяцам. Из-за малого количества данных точность оценки параметров снижается.
● Неравномерность тестирования, особенно в сочетании с малым количеством данных
Ни одна модель не подходит идеально, поэтому нужно как-то оценивать
точность, сходимость и так далее. Следует отметить, что на практике при
применении SRGM возникает необходимость привязывать результаты ко времени, так
как, в отличие от теории, время тестирования не бесконечно и некоторым образом
связано с внешними факторами (длина рабочей недели, близость срока сдачи
проекта и прочее). Идеальный вариант - учитывать только процессорное время, то
есть время, в течение которого непосредственно проходило тестирование.
Изначально, когда использовались для прогнозирования отказов оборудования,
такой подход был вполне реалистичен, однако, когда речь идет о программном
обеспечении, собрать информацию о процессорном времени малореально. Поэтому,
как правило, используется календарное время, и данные группируются по неделям (или
месяцам).
4. Проверка надёжности. Определения, методы,
модели
Под надежностью программного обеспечения понимают вероятность того, что, начиная с момента времени Т, программная система будет работать по спецификации в течение заданного времени.
Часто рассматривают предел этой величины при бесконечно больших Т. В дальнейшем мы будем рассматривать процесс разработки программы, и, соответственно, обнаружение ошибок в коде при тестировании. Под «ошибкой» будем понимать работу программы не по спецификации, вызванную неверно написанным или отсутствующим кодом. Так как измерить надежность непосредственно можно не во всех ситуациях, используются различные оценки, основанные, как правило, на данных о периодах между обнаружением ошибок.
Для оценки числа ошибок в системе, можно использовать две методики: первая основана на изучении исходного кода программы, вторая - использование моделей оценки надежности на данных, полученных при тестировании.
Статистическая оценка параметров:
После выбора модели, исходя из каких бы то ни было рассуждений, необходимо вычислить параметры, так как модель задает лишь вид функции, зависящей от нескольких произвольных постоянных, подлежащих определению. Чтобы найти эти постоянные, используются стандартные статистические методы:
а) Метод максимального правдоподобия
На основе выборки имеющихся наблюдений можно построить функцию правдоподобия, являющуюся произведением плотностей отдельных случайных величин из выборки (предполагается, что тип распределения известен). По сути функция правдоподобия представляет из себя вероятность получить заданную выборку при заданном значении параметра. Соответственно, если найти максимум этой функции, то это значение параметра можно взять в качестве точечной оценки, так как при таком значении параметра вероятность получить имеющуюся выборку максимальна. На практике, при расчете параметров в пуассоновских моделях, задача сводится не к поиску максимума функции, а к уравнению, которое можно решить численно. Это связано с дискретностью наблюдений.
б) Линейная регрессия
Суть: найти такие значение параметров, при которых полученная кривая будет наиболее близка к наблюдениям. За меру близости принимается сумма квадратов расстояний.
Основываясь на полученных точечных оценках, далее можно построить доверительные интервалы для искомых параметров. При этом метод максимального правдоподобия имеет некоторое преимущество, так как в нем на оценки накладывается меньше ограничений, связанных с предположением о том, что ошибки нормально распределены (а на больших выборках это становится малосущественным в силу центральной предельной теоремы), кроме того, при расчетах вторым методом могут получатся результаты, противоречащие реальности, например, нижняя граница доверительного интервала может оказаться меньше текущего числа ошибок.
Помимо доверительных интервалов, при практическом применении SRGM часто используют факты из теории проверки статистических гипотез, так как таким образом проще проверять соответствие полученной кривой и реальных данных. Самый простой подход - расчет среднеквадратичного отклонения, при его применении возникает проблема выбора порога, начиная с которого гипотеза отвергается.
Более сложный способ - использование критериев согласия. Опишем кратко один из самых распространенных критериев - критерий Пирсона (хи-квадрат).
Обозначим через X исследуемую случайную величину. Пусть требуется проверить гипотезу о том, что эта случайная величина подчиняется закону распределения F(x).
Для проверки гипотезы произведём выборку, состоящую из n независимых наблюдений над случайной величиной X. По выборке можно построить эмпирическое распределение F(x) исследуемой случайной величины. Сравнение эмпирического F(x) и теоретического распределений производится с помощью специально подобранной случайной величины - критерия согласия.
Для проверки критерия вводится статистика:
Где 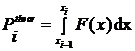 - предполагаемая вероятность попадания в i-й интервал,
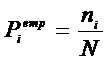 -соответствующее эмпирическое значение.
Эта величина в свою очередь является случайной (в силу случайности
X) и должна подчиняться распределению  . Если полученная статистика превосходит квантиль закона
распределения х2 заданного уровня значимости α с k - 1 или с k - p - 1 степенями
свободы2, где k - число наблюдений или число интервалов (для случая
интервального вариационного ряда), а p - число оцениваемых параметров закона
распределения то гипотеза отвергается. В противном случае гипотеза принимается
на заданном уровне значимости α.
При реализации моделей оценки надежности использовался метод максимального правдоподобия как наиболее универсальный и не сложный в реализации.
Пуассоновские модели
Пуассоновский процесс - семейство случайных величин, заданных на одном вероятностном пространстве, зависящих от неотрицательного параметра t, обладающее следующими свойствами:
) Независимые приращения: случайные величины ҙ0,ҙ1−ҙ0,ҙ2−ҙ1… независимы
) Однородность по времени;
) ҙ0=0
) P (ҙ > 1) стремится к нулю при h->0.
Теорема. Если X - пуассоновский процесс, то для любого t случайная величина ҙt имеет распределение Пуассона с параметром l*t.
Рассматривается неоднородный процесс, где интенсивность потока ошибок в заданный момент времени не является линейной функцией от t. По виду функции количества m(t) модели делят на:
а) Выпуклые. Предполагаются, что количество обнаруживаемых ошибок уменьшается равномерно с ростом объема тестирования (и количества исправленных ошибок)
б) S-изогнутые. Предполагается, что тестирование на ранних этапах разработки менее эффективно, например, потому что в начале разработки одни ошибки влекут за собой другие, и их исправление возможно только совместно, а также потому, что часть времени уходит на исправление параметров системы для корректной работы программы.
в) Неограниченные. Используется предположение, что количество ошибок в программе бесконечно (и соответствующее распределение). Несмотря на кажущуюся абсурдность такой модели, в реальности есть основания их использовать, если считать, что все ошибки исправить к одному релизу не удается.
Основные выпуклые модели:
1. Экспоненциальная
. Gompetz
. Вейбулла
. Парето
. Гиперэкспоненциальная
Основные S-изогнутые модели:
. Yamada
. Параметризованная
. Логарифмическая
Самая распространенная неограниченная модель - логарифмическая.
Экспоненциальная модель:
Формула 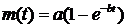 задает функцию ошибок. Параметр a есть
общее количество ошибок, параметр b задает скорость обнаружения ошибок.
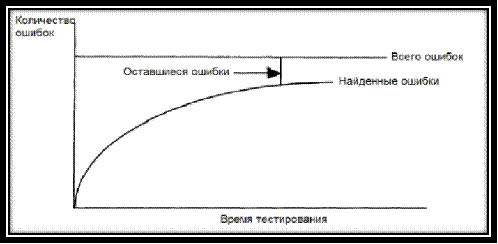
Рисунок 1: Экспоненциальная модель: график m(t)
Суть: полагаем, что число ошибок, обнаруженных в интервале dt,
пропорционально числу оставшихся ошибок, считая, что общее число ошибок конечно
и равно a. Получаем дифференциальное уравнение
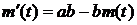 .
Решением этого уравнения является указанная выше функция m(t).
Вид выпуклой кривой показан на рис. 1.
Эта модель очень распространена. Оценка параметров методом
максимального правдоподобия в этом случае равносильна решению уравнения:
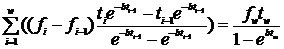
Где w - количество тестов (периодов тестирования), t - время тестирования к концу данного периода, f - количество ошибок, обнаруженных к концу данного периода.
Модель Gompertz:

В данной модели кривая также является выпуклой. Относительным преимуществом является большая гибкость модели, так как она зависит от трех параметров. Для этой модели также есть модификация, делающая кривую S-изогнутой.
Обобщенная экспоненциальная модель (модель Вейбулла):
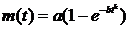
Параметр k показывает качество тестирования. При k=1 получаем экспоненциальную модель. По сути, это обобщение экспоненциальной модели с целью сделать кривую более «настраиваемой» на данные.
Модель Yamada:
Еще одно обобщение экспоненциальной модели, суть модификации заключается
в том, что кривая становится S-изогнутой, и происходящее можно рассматривать
как модель для тестирования, при котором умения тестировщика постепенно
увеличиваются. Вид кривой показан на рис. 2.
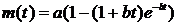
Параметры a и b находятся из системы уравнений: