Материал: Методы статистического и интеллектуального анализа данных. Минаева Ю.В

следующем шаге выбираются и объединяются два кластера и, таким образом, остается (n 1) кластеров. Процесс повторяется
до объединения всех элементов в один кластер.
Существует несколько алгоритмов, отличающихся условиями выбора кластеров для объединения. Наиболее простым является метод одиночной связи, согласно которому определяются два наиболее близких объекта и они образуют первый кластер. На следующем шаге выбирается объект, наиболее близкий к какому–либо из уже объединенных кластеров и т.д.
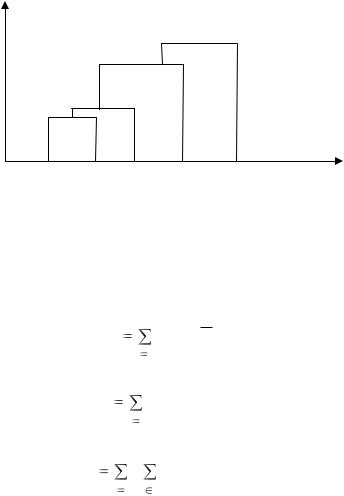
Последовательность объединения кластеров легко может быть проиллюстрирована в виде графа.
Дендрограмма – древовидная диаграмма, содержащая n уровней, каждый из которых соответствует одному из шагов процесса укрупнения кластеров. На дендрограмме указываются номера объединяемых объектов и расстояние, при котором произошло объединение. Обычно объекты на дендрограмме изображают таким образом, чтобы не было пересечений ребер.
Пример. Пусть задана матрица расстояний между объектами (табл. 8).
|
|
|
|
|
|
|
Таблица 8 |
|
|
|
|
|
|
|
|
|
|
|
Номера |
1 |
2 |
3 |
|
4 |
5 |
|
|
объектов |
|
|
|||||
|
|
|
|
|
|
|
|
|
|
1 |
0 |
2.5 |
3.1 |
|
4.2 |
2.8 |
|
|
|
|
|
|
|
|
|
|
|
2 |
|
0 |
2.6 |
|
4.3 |
5.7 |
|
|
|
|
|
|
|
|
|
|
|
3 |
|
|
0 |
|
4.5 |
3.9 |
|
|
|
|
|
|
|
|
|
|
|
4 |
|
|
|
|
0 |
3.5 |
|
|
|
|
|
|
|
|
|
|
|
5 |
|
|
|
|
|
0 |
|
|
|
|
|
|
|
|
|
|
|
На первом шаге определяется минимальное расстояние |
|||||||
( d12 ) и объединяются кластеры |
K1 и |
K2 . Далее выбирается |
||||||
наименьшее расстояние от этих кластеров до остальных ( d23 )
46
и прибавляется кластер K3 . На следующем шаге присоединяется кластер K5 , и последним – K4 .
Дендрограмма для данного примера представлена на
рис. 9.
dij
3.9
3.5
2.6
2.5
1 |
2 |
3 |
5 |
4 |
Объекты |
Рис. 9. Графическая иллюстрация метода наименьших квадратов
Для оценки качества кластерного анализа необходимо определить следующие показатели степени рассеяния:
– общее рассеяние:
n
S0 d2 (Xi , X) ;
i1
–межгрупповой разброс:
|
s |
|
|
|
|
|
|
S |
n |
d2 (X |
j |
, X) ; |
|||
1 |
j |
|
|
|
|
|
|
j1
–внутригрупповой разброс:
s |
d2 (Xi , |
|
|
S2 |
X |
j ) , |
|
j 1Xi |
K j |
||
47
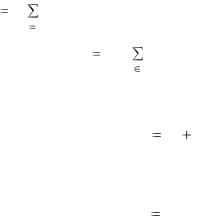
где |
|
|
|
1 |
|
n |
– среднее всего множества объектов (общий |
||||||||
|
|
|
|||||||||||||
X |
|
|
Xi |
||||||||||||
n i |
|||||||||||||||
|
|
|
|
1 |
|
|
|
|
|
|
|
|
|||
центр тяжести), |
|
|
|
1 |
|
|
Xi – центр тяжести j–го кластера, |
||||||||
|
X j |
|
|||||||||||||
|
|
|
|
||||||||||||
|
n j X |
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
i |
K |
j |
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
n j |
– число объектов в кластере K j . |
||||||||||||||
Приведенные показатели связаны соотношением
S0 S1 S2 .
Качество кластерного анализа можно оценить по доле межгруппового разброса в общем рассеянии, определяемой по формуле
T S1 / S0 .
Чем ближе Т к единице, тем качественнее проведена кластеризация выборки, т. к. такое значение говорит о том, что расстояния между кластерами достаточно большие, а внутригрупповой разброс небольшой.
3.2. Дискриминантный анализ
Дискриминантный анализ – это статистический метод, позволяющий изучить различия между двумя и более группами объектов по нескольким характеризующим их признакам.
Дискриминантный анализ используется для классификации наблюдений в тех случаях, когда есть набор объектов, для которых известно, к каким группам они принадлежат, т. е. есть обучающая выборка, классификация которой была проведена, например, с помощью кластерного анализа. В дальнейшем обучающая выборка используется для определения параметров процедуры анализа.
С помощью методов дискриминантного анализа можно выполнить, например, распознавание образов или диагностику состояния сложных технических объектов.
Данный метод анализа позволяет выяснить, действительно ли группы наблюдений различаются между
48
собой, и если да, то какие переменные вносят наибольший вклад в имеющиеся различия.
Необходимым условием для работы метода является нормальное распределение всех признаков исследуемых объектов.
Для классификации объектов на основе обучающей выборки строятся одна или более дискриминантных функций, позволяющих отнести каждый объект к одной из групп.
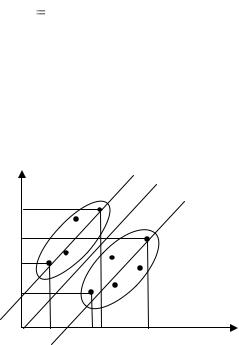
Пусть обучающая выборка включает множество объектов X (X1,X2,...,Xn ) , где каждый объект характеризуется двумя признаками x1 и x2 . Для данных объектов известна их принадлежность к классам K1 и K2 .
Геометрическая интерпретация данной ситуации приведена на рис. 10, где объекты обозначены точками, каждая из которых описывается двумя переменными x1 и x2 .
x2 |
|
f1(x) |
f (x) |
|
K1 |
|
|
||
|
|
f2 |
(x) |
|
|
|
|
||
|
|
|
K2 |
|
x1
Рис. 10. Графическая иллюстрация дискриминантной функции
Построим проекции точек на оси координат. В общем случае проекции классов на каждой оси могут пересекаться, т.е. по каждой переменной отдельно некоторые элементы разных классов имеют сходные характеристики. Чтобы
49
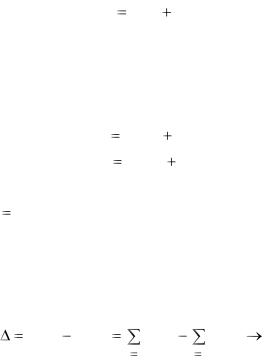
наилучшим образом разделить два рассматриваемых класса, необходимо рассматривать не отдельные переменные x1 и x2 , а их линейную комбинацию, записываемую в виде
|
f (x) |
a1x1 a2x2 . |
|
Функция |
f (x) |
называется |
канонической |
дискриминантной функцией, а переменные x1 и x2 –
дискриминантными переменными.
Запишем дискриминантные функции для каждого класса через средние значения переменных x:
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
f1(x) |
a1x11 |
a 2 x12 , |
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
f2 (x) |
a1x 21 |
a 2 x 22, |
|
|||||||
где xij – среднее значение j–го |
признака |
у объектов i–го |
||||||||||
класса, i, j 1,2 . |
|
|
|
|
|
|
||||||
|
|
|
|
|
|
|
||||||
Геометрически f1(x) и f2 (x) – это две параллельные |
||||||||||||
прямые, проходящие через центры классов. |
|
|||||||||||
Коэффициенты ai |
выбираются таким образом, чтобы |
|||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
разница между f1(x) и f2 (x) |
была максимальна, т.е. |
|||||||||||
|
|
|
|
|
|
|
|
2 |
|
|
2 |
|
f1(x) f2 (x) |
|
ai x1i |
ai x2i |
max . |
||||||||
|
|
|
|
|
|
|
i |
1 |
|
|
i 1 |
|
Если необходимо разделить данные на m групп, то необходимо построить m дискриминантных функций, т.к. классы будут отделяться друг от друга индивидуальными разделяющими поверхностями.
3.3. Факторный анализ
Факторный анализ – статистический метод, применяемый для изучения влияния различных факторных признаков и их комбинаций на исследуемый объект и определения наиболее значимых переменных.
Задачами факторного анализа являются:
50