Материал: Методы статистического и интеллектуального анализа данных. Минаева Ю.В
–редукция данных – сокращение числа первоначально взятых признаков путем выделения наиболее значимых переменных;
–выявление структуры взаимосвязей между переменными, в частности выявление групп взаимосвязанных переменных;
–классификация и систематизация факторных признаков путем построения новых обобщенных показателей.
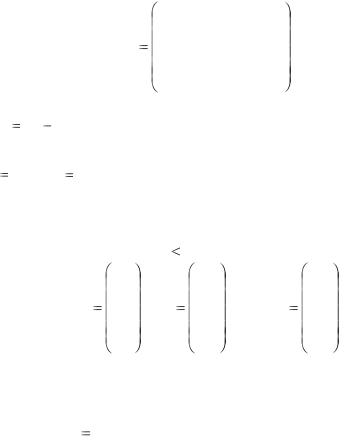
Пусть результаты наблюдений за n объектами, каждый из которых описывается m признаками, сведены в матрицу
|
x11 |
x12 |
... |
x1m |
|
|
X |
x 21 |
x 22 |
... |
x 2m |
, |
|
... ... ... ... |
||||||
|
|
|||||
|
x n1 |
x n2 |
... |
x nm |
|
|
в которой все наблюдения центрированы, т.е. приведены к виду
xij |
~ |
|
~ |
|
|
|
xij |
x j , где xij – исходные результаты наблюдений за j–м |
|||||
признаком i–го объекта, x j |
– среднее значение j–го признака, |
|||||
i |
1,..., n , j |
1,..., m . |
|
|
|
|
|
|
Допустим, есть основания полагать, что первоначально |
||||
выбранное |
количество |
признаков |
избыточно |
и |
||
рассматриваемый объект может быть охарактеризован меньшим набором из k ( k m ) основных факторов:
|
f11 |
|
f21 |
|
fk1 |
F |
f12 , F |
f22 , ..., |
F |
fk2 . |
|
1 |
... |
2 |
... |
k |
... |
|
|
|
|||
|
f1n |
|
f2n |
|
fkn |
Модель факторного анализа предполагает, что каждый |
|||||
из первоначальных признаков x1,...,xn |
представляется в виде |
||||
линейной комбинации факторов F1,...,Fk |
и специфического |
||||
фактора U |
(u1,u2,...,um ) , |
компенсирующего в случае |
|||
необходимости разницу, возникающую при замене m–мерного базиса признаков k–мерным:
51
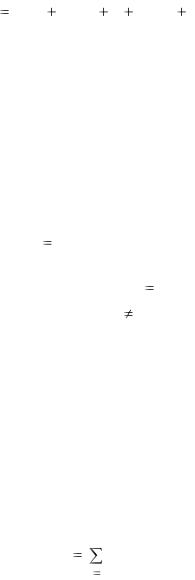
x j |
a j1F1 |
a j2F2 ... |
a jk Fk d ju j, |
где a j1,..., a jk |
– факторные нагрузки, характеризующие |
||
существенность |
влияния |
каждого |
фактора, d j – нагрузка |
специфического фактора.
Задачу факторного анализа можно сформулировать следующим образом: определить минимальное число k линейно независимых факторов, после учета которых все остаточные корреляции между исходными признаками должны стать незначимыми.
В результате решения полученной системы из m
уравнений находятся |
значения факторных |
нагрузок |
a jh и |
самих факторов Fh , h |
1,...,k . Если все полученные факторы |
||
линейно независимы, |
т. е. множество Fh |
образует |
полный |
базис, то специфические факторы u j 0 . В противном случае будут присутствовать значения u j 0 и можно сделать вывод,
что линейная модель неточная и первоначальные признаки не могут быть линейно выражены через рассматриваемые факторы.
Разработано несколько методов решения задачи факторного анализа, самым распространенным из которых является метод главных компонент.
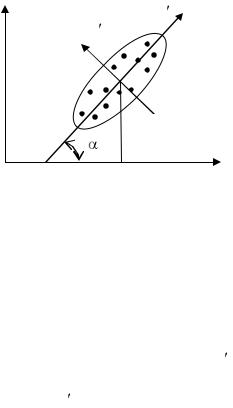
Согласно данному методу предполагается, что изначально число общих факторов равно числу исходных признаков исследуемого объекта. Такое предположение позволяет исключить из модели специфические факторы и сформулировать модель главных компонент в виде
k
x j |
a jh Fh . |
h |
1 |
Метод главных компонент состоит в построении факторов – главных компонент, каждая из которых представляет линейную комбинацию исходных признаков. Первая главная компонента F1 определяет такое направление в
52
пространстве исходных признаков, по которому совокупность объектов имеет наибольший разброс (дисперсию). Вторая главная компонента F2 строится так, чтобы ее направление
было ортогонально направлению F1 , и она объясняла как можно большую часть остаточной дисперсии и т.д. вплоть до компоненты Fm . Достаточное число факторов k определяется
обычно на основе заранее заданного уровня объясняемой фактором дисперсии исходных признаков.
Пусть исследуемый объект описывается двумя признаками x1 и x2 . Для такого двумерного случая можно
построить следующую геометрическую интерпретацию метода главных компонент (рис. 11).
x2 |
x |
|
1 |
x2
x2 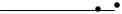

x1 |
x1 |
Рис. 11. Геометрическая интерпретация метода главных компонент
Центр координат системы переносится в точку (x1, x2 )
с помощью центрирования результатов наблюдений. Вокруг них строится эллипсоид рассеяния таким образом, чтобы исследуемые объекты, изображенные точками, находились приблизительно в его очертаниях. Затем оси координат поворачиваются на угол  так, чтобы ось x1 шла вдоль главной оси эллипсоида рассеяния. Чем теснее наблюдения группируются около оси x1, тем менее значащим является для
53
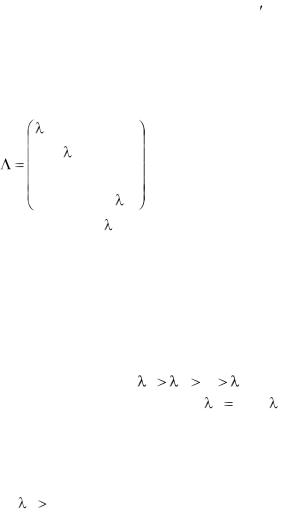
исследователя разброс точек в направлении оси
следовательно, и сама эта координата.
Аналитически процесс построения ортогональных компонент соответствует вычислению диагональной матрицы собственных значений корреляционной матрицы исходных переменных:
1 |
0 |
... |
|
0 |
|
|
|
|
|
|
|
||
0 |
2 |
... |
|
0 |
. |
|
... ... ... ... |
||||||
|
||||||
0 |
0 |
0 |
|
m |
|
|
|
|
|
|
|
||
В этой матрице значения |
|
j |
равны дисперсиям j–х |
|||
|
|
|
|
|
||
признаков рассматриваемого объекта. Те главные факторы, которым соответствуют большие значения дисперсии, объясняют большую часть разнообразия исследуемых объектов и они являются важными для описания системы, а факторами с малыми значениями дисперсии можно пренебречь с целью понижения размерности.
Для выбора факторов их собственные значения
располагаются в порядке убывания |
1 |
2 |
... |
m |
и |
к |
|||
|
|
|
|
|
|
|
|||
первому |
самому |
значимому |
фактору |
|
1 |
max( |
j ) |
||
добавляются остальные факторы, собственные значения которых соответствуют некоторому выбранному критерию.
В качестве такого критерия могут применяться:
– критерий Кайзера, согласно которому отбираются
факторы, для которых |
j |
1 |
; |
|
|
|
– критерий каменистой осыпи – число необходимых факторов определяется графически; для этого строится график с собственными значениями и на нем находится такое место, где убывание собственных значений максимально замедляется. Пример графика с собственными значениями приведен на рис.
12.
54
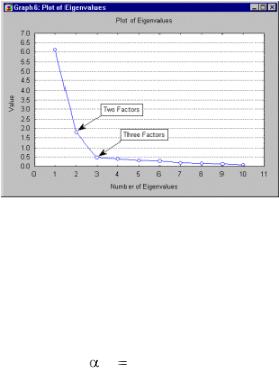
Рис. 12. Графический способ определения числа главных компонент
Согласно данному графику наибольшую значимость имеют первые три фактора с максимальными собственными значениями.
После определения главных компонент находятся значения факторных нагрузок из соотношения
jh r(x j, Fh ) ,
где r(x j, Fh ) – коэффициент корреляции между признаком x j и главной компонентой Fh .
Контрольные вопросы
1.Что такое кластерный анализ? Какие расстояния между объектами и меры близости между кластерами используются в кластерном анализе?
2.Какие методы используются для решения задач раздельного и иерархического кластерного анализа?
3.Что такое дискриминантный анализ? Что такое дискриминантная функция? Как определяются ее коэффициенты?
4.Что такое факторный анализ? Что такое главные компоненты? На чем основан метод главных компонент?
55