Материал: Методы статистического и интеллектуального анализа данных. Минаева Ю.В
Контрольные вопросы
1.Какие группы признаков исследуемых объектов можно выделить в зависимости от шкалы измерения?
2.Какие виды зависимости между признаками объектов существуют?
3.Что такое корреляционный анализ? Какими количественными показателями изменяется корреляция между признаками?
4.Что такое регрессионный анализ? Какой метод чаще всего используется для определения коэффициентов уравнения регрессии?
5.Что такое мультиколлинеарность? Какие причины влияют на ее возникновение?
6.Что такое дисперсионный анализ? Какие составляющие включает общая дисперсия выборки?
41
3.МЕТОДЫ КЛАССИФИКАЦИИ
ИРЕДУКЦИИ ДАННЫХ
3.1.Кластерный анализ
При анализе результатов наблюдений часто возникает задача объединения элементов выборки со схожими параметрами в отдельные группы, причем множество таких групп может быть известно (задача классификации данных) или неизвестно (задача кластеризации данных).
Кластерный анализ – метод анализа, позволяющий выявить наличие внутренних связей между элементами выборки и разделить на их основе данные на множество групп со схожими параметрами (кластеры).
Кластерный анализ чаще всего применяется в тех случаях, когда неизвестно число групп, на которые следует разделить элементы исходной выборки, т. е. в задачах поиска структуры для малоизученных явлений. Например, если нужно разделить на отдельные рыночные сегменты потребителей, обладающих определенной совокупностью характеристик (возраст, образование, доход, тип личности, место жительства и т.д.). Полученная классификация может использоваться для определения возможности и готовности каждой группы потребителей приобретать конкретные товары.
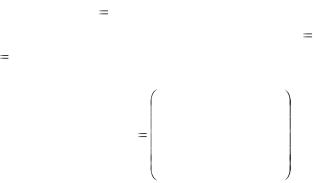
Пусть есть результаты наблюдений за множеством
объектов |
X (X1,X2,...,Xn ) , |
где |
каждый |
объект |
характеризуется m признаками, т. е. Xi (xi1, xi2,...,xim ) , i 1,...,n . Совокупность значений признаков сводится в матрицу
|
x11 |
x12 |
... |
x1m |
|
|
X |
x 21 |
x 22 |
... |
x 2m |
. |
|
... ... ... ... |
||||||
|
|
|||||
|
x n1 |
x n2 |
... |
x nm |
|
|
42
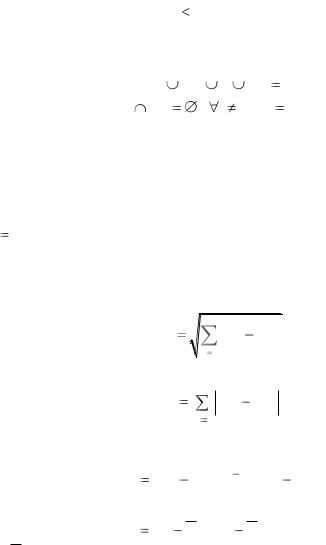
Задача кластерного анализа может быть сформулирована следующим образом: необходимо разбить множество объектов Х на s n кластеров K1, K2 ,...,Ks таким
образом, чтобы каждый объект Xi |
принадлежал только одному |
|||
кластеру K j , т.е. |
|
|
|
|
K1 |
K2 |
... |
Ks |
X , |
Ki K j |
, |
i |
j, i, j |
1,...,m . |
и чтобы объекты, принадлежащие одному и тому же кластеру, были схожими, а объекты, принадлежащие разным кластерам, несходными.
Различие и схожесть объектов определяется на основе
расстояния (метрики) d(Xi , X j ) между объектами Xi и X j ,
i, j 1,...,n .
В кластерном анализе используются следующие расстояния d(Xi , X j ) между объектами:
– евклидово расстояние:
|
m |
d ( Xi , X j ) |
xik x jk ; |
|
k 1 |
– сумма абсолютных отклонений (городская метрика):
|
m |
d(Xi , X j ) |
xik x jk ; |
k1
–обобщенное евклидово расстояние (расстояние
Махаланобиса):
d(Xi , X j ) (Xi X j )  S 1
 (Xi X j ) ,
где S –матрица рассеяния, вычисляемая следующим образом:
S (X X)T (X X) ,
где X – матрица, столбцы которой равны средним значениям соответствующих переменных.
Выбор той или иной метрики оказывает существенное влияние на результаты разбиения и должен производиться с
43
учетом целей исследования, природы объектов наблюдения, полноты априорных сведений о характере распределения наблюдений.
К числу наиболее общих рекомендаций по выбору метрики относятся:
–если известно, что наблюдения извлекаются из нормальных генеральных совокупностей с одной и той же матрицей ковариации, то лучше использовать расстояние Махаланобиса;
–если отдельные признаки объектов однородны по физическому смыслу и одинаково важны с точки зрения задач классификации, то используется евклидово расстояние.
В качестве меры близости между кластерами могут использоваться следующие расстояния:
–расстояние, изменяемое по принципу ближайшего
соседа:
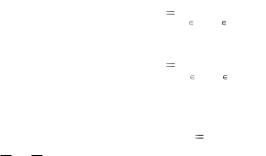
Dmin (Kg , Kh ) |
min |
X i , X j ; |
|
Xi Kg , X j |
Kh |
– расстояние, изменяемое по принципу дальнего соседа:
Dmax (Kg , Kh ) |
max |
|
|
Xi , X j ; |
||
Xi |
Kg , X j |
Kh |
||||
– расстояние, изменяемое по центрам тяжести |
||||||
кластеров: |
|
|
|
|
|
|
|
|
|
|
|
|
|
Dср (Kg , K h ) |
d(Xi , X j ) , |
|||||
где Xi , X j – арифметические средние наблюдений, входящих в кластеры Kg и Kh , соответственно.
Можно выделить два класса задач иерархического анализа:
–раздельный кластерный анализ – разбиение множества из n элементов на m кластеров;
–иерархический кластерный анализ – получение всей иерархии разбиений, более точно характеризующей структуру связей в наблюдениях.
44
Для решения задачи раздельного кластерного анализа чаще всего применяется алгоритм k–средних, основными этапами которого являются:
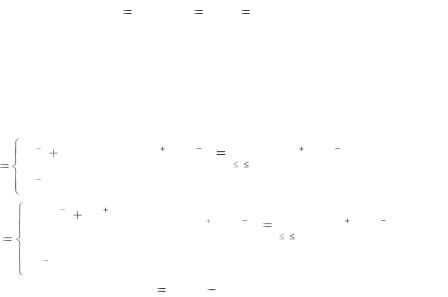
1. Определение центров кластеризации:
– выбор s объектов, которые принимаются в качестве нулевого приближения, т.е.
|
|
ˆ 0 |
Xi , |
0 |
1, i |
1,...,s , |
|
|
Xi |
pi |
|||
где |
ˆ |
– координаты |
центров |
кластеров, p – веса, |
||
Xi |
||||||
приписываемые центам;
– выбор первой из оставшихся вершин  определение ближайшего к ней по метрике d центра и пересчет координат и весов центров по формулам:
|
|
v 1 |
|
|
|
|
|
|
s v |
|
ˆ v 1 |
|
|
|
|
s v |
|
ˆ v 1 |
|
|
|
|||||
v |
pi |
|
|
|
1, |
если d X |
|
|
, Xi |
|
min |
d |
X |
|
|
, X j |
|
, |
|
|
||||||
pi |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1 j s |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
pv |
1 |
, |
|
в противном |
|
случае, |
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
i |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
v |
ˆ v 1 |
|
s v |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
pi |
Xi |
|
X |
|
|
|
|
|
|
s v |
ˆ v 1 |
|
|
|
|
|
|
s v |
ˆ v 1 |
|
||||
ˆ v |
|
|
|
|
|
v |
|
|
, если |
d |
X |
|
, X |
i |
min |
d |
X |
|
, X |
j |
, |
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1 |
j s |
|
|
|
|
|
|
|||||
Xi |
|
|
|
|
|
pi |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
ˆ v |
1 |
, |
в противном случае |
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||
|
|
Xi |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||
где v – номер итерации, v |
|
1,...,n |
s . |
|
|
|
|
|
|
|
|
|
|
|
||||||||||||
|
2. |
Распределение наблюдений по кластерам – |
каждую |
|||||||||||||||||||||||
точку Xi относят к кластеру, центр которого окажется к ней
ближайшим.
Для решения задач кластерного иерархического анализа используется два вида алгоритмов:
–дивизимные (нисходящие) – множество объектов Х постепенно делится на все более мелкие подмножества;
–агломеративные (восходящие) – элементы множества
Хпостепенно объединяются в более крупные подмножества. Наиболее распространенными являются агломеративные
алгоритмы, сущность которых заключаются в том, что на первом шаге выборка рассматривается как совокупность из n кластеров, каждый из которых состоит из одного элемента. На
45