Материал: Модели и алгоритмы проектирования и разработки систем поддержки принятия инвестиционных решений. Морозов В.П., Баркалов С.А
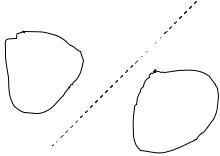
Граница
решений
Класс
С1
Класс
С2
Рис. 2.25. Пара линейно-разделимых образов
такой вектор весовых коэффициентов w, для котoрoгo истинно следующее утверждение:
wTх > 0 для любоro входного вектора х, принадлежащего классу С1,
wTх <= 0 для любоrо входногo вектора х, принадлежащего классу С2. (2.34)
Во второй строке утверждения (2.34) указано, что при paвeнстве wTх =0
входной вектор х принадлежит именно классу С2. При определенных таким образом подмножествах Х1 и Х2 задача обучения элементарноrо персептрона сводится к нахождению тaкoгo вектора весов w, для котopoгo выполняются оба неравенства (2.34).
Алгоритм адаптации вектора весовых коэффициентов элементарноrо персептрона можно сформулировать следующим образом.
Если n-й элемент х(n) обучающего множества корректно классифицирован с помощью весовых коэффициентов w(n), вычисленных на n-м шагe алгoритма, то вектор весов не корректируется. Т.е. действует следующее пра-
вило: |
|
|
w(n+1)= w(n) если wTх(n) > 0 и х(n) C1 , |
|
|
w(n+1)= w(n) если wTх(n) <= 0 и х(n) C2. |
(2.35) |
|
В противном случае вектор весов персептрона подвергается коррекции в |
||
соответствии со следующим правилом: |
|
|
w(n+1)= w(n)- (n)x(n) если wT(n)х(n) |
> 0 и х(n) C2, |
|
w(n+1)= w(n) + (n)x(n) если wT(n)х(n) |
<= 0 и х(n) C1, |
(2.36) |
где интенсивность настройки вектора весов на шаге n определяется параметром скорости обучения (n).
Если (n)= > 0, где – константа, не зависящая от номера итерации n,
вышеописанный алгоритм называется правилом адаптации с фиксированным приращением.
Докажем сходимость правила адаптации с фиксированным приращением для = 1. Само значение не играет особой роли, если оно положительно.
Значение параметра , отличное от единицы, обеспечивает масштабирование образов, не влияя на их разделимость. Случай с переменным коэффициентом
(n) рассмотрим позднее.
Вприведенном доказательстве считается, что в начале процесса обучения
101

вектор весовых коэффициентов равен нулю, w(0)=0. Предположим, что для n = 1, 2, . . . , wT(n) x(n) <0, а входной вектор х(n) принадлежит подмножеству X1. Это значит, что персептрон некорректно классифицировал векторы х(l), х(2), т.е. условие (2.34) не выполнено. Следовательно, для (n)= 1 можно использо-
вать вторую стpoку правила (2.36): |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||||||||||||
w(n+1)= w(n) +x(n) для х(n) C1. |
(2.37) |
|||||||||||||||||||||||||||||||||||||||||
Поскольку начальное состояние w(0) = 0, то уравнение (2.37) для w(n+1) |
||||||||||||||||||||||||||||||||||||||||||
можно решить итеративно и получить следующий результат: |
|
|||||||||||||||||||||||||||||||||||||||||
w(n +1) == х(l) + х(l) + … + х(n). |
(2.38) |
|||||||||||||||||||||||||||||||||||||||||
Так как по предположению классы С1 |
и С2 являются линейно разделимы- |
|||||||||||||||||||||||||||||||||||||||||
ми, то cyществует такое решение wo, при котором будет выполняться условие w |
||||||||||||||||||||||||||||||||||||||||||
T х(n) > 0 для векторов x(l), х(2),... , х(n), принадлежащих подмножеству X1. Для |
||||||||||||||||||||||||||||||||||||||||||
фиксированногo решения w0 можно определить такое положительное число , |
||||||||||||||||||||||||||||||||||||||||||
что |
|
|
|
min w0T x(n). |
|
|
|
|
|
|
|
|
||||||||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
(2.39) |
|||||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
x(n) X1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||
Умножая обе части уравнения (2.38) на вeктop - строку w0T, получим |
||||||||||||||||||||||||||||||||||||||||||
w0T w(n +1) = w0T х(l) + w0T х(l) + … + w0T х(n). |
|
|||||||||||||||||||||||||||||||||||||||||
Учитывая (2.39) имеем |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||
|
|
|
|
|
|
|
w0T w(n +1) >=n . |
|
|
|
|
|
|
|
(2.40) |
|||||||||||||||||||||||||||
Теперь можно использовать неравенство Гучи-Шварца. Для двух векто- |
||||||||||||||||||||||||||||||||||||||||||
ров, w0 и w(n + 1),eгo можно записать следующим образом: |
|
|||||||||||||||||||||||||||||||||||||||||
|
|
w0 |
|
|
|
2 |
|
|
|
w(n 1) |
|
|
|
|
2 w0T w(n 1) 2 , |
(2.41) |
||||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|||||||||||||||||||||||||||||||||||
где ||.|| - Евклидова норма векторноrо аргумента; w0T w(n 1) скалярное про- |
||||||||||||||||||||||||||||||||||||||||||
изведение векторов. Заметим, что согласно (2.40) |
|
w0T w(n 1) 2 n2 2 |
. Учитывая |
|||||||||||||||||||||||||||||||||||||||
это в (2.41), получим |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
w |
|
|
|
|
2 |
|
|
|
w(n 1) |
|
|
|
2 |
|
n2 2 |
|
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||||||||||||
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
или |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
n2 2 |
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
w(n 1) |
|
2 |
|
|
|
|||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
. |
(2.42) |
||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
w0 |
|
|
|
2 |
||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||
Перепишем ypaвнение (2.37) в следующем виде:
w(k+1)= w(k) +x(k) для k=1,…,n и х(k) X1. (2.43)
Вычисляя Евклидову норму векторов в обеих частях уравнения (2.43), получим
w(k 1) |
|
|
|
2 |
|
|
|
|
w(k) |
|
|
|
2 |
|
|
|
|
x(k) |
|
|
|
2 |
2wT (k)x(k). |
(2.44) |
|
|
|
|
|
|
|
|
|
|
Если персептрон некорректно классифицировал входной вектор x(k), принадлежащий подмножеству X1, то wT(k)x(k) < 0. Следовательно, из (2.44) получим выражение
102

 w(k 1)

 2

 w(k)

 2

 x(k)

 2
или |
|
|
w(k 1) 2 w(k) 2 |
x(k) 2 для k=1,…,n. |
(2.45) |
Применяя эти неравенства последовательно для k=1,…,n и учитывая изначальное допущение, что w(0)=0, приходим к неравенству
w(n 1) |
|
|
|
2 |
n |
|
|
|
x(k) |
|
|
2 |
n , |
(2.46) |
|
|
|
|
|
|
|||||||||
|
|
|
|
|
k 1 |
|
|
|
|
|
|
|
|
|
где – положительное число, определяемое следующим образом:
max |
|
|
|
x(k) |
|
|
|
2 . |
(2.47) |
|
|
|
|
||||||
x(k) X1 |
|
|
|
|
|
|
|
|
|
Уравнение (2.46) означает, что Евклидова норма вектора весов w(n + 1) линейно возрастает с увеличением номера итерации n.
Результат, описываемый неравенством (2.46), при больших n вступает в противоречие с полученным ранее результатом (2.42) [122]. Следовательно, номер итерации n не может превышать значения nmax, при котором неравенства (2.42) и (2.46) удовлетворяются со знаком равенства. Это значит, что число nmax должно быть решением уравнения
nmax |
2 |
|
|
2 |
nmax . |
|||
|
|
|
|
|
2 |
|
||
|
w |
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
|
Разрешая это уравнение для nmax относительно wo, получим
nmax |
|
|
|
|
w |
|
|
|
2 |
|
|
|
|
|
|
|
|||||||
|
|
|
|
0 |
|
|
|
|
. |
(2.48) |
|
|
|
|
|
||||||||
2 |
|
|
|||||||||
|
|
|
|
|
|||||||
Таким образом, доказано, что для (n) 1и w(0)=0, в предположении су-
ществования вектора решения w0, процесс адаптации синаптических весов персептрона должен прекращаться не позднее итерации nmax. Согласно (2.39), (2.40) и (2.41) решение для w0 и nmax не единственно.
Теорема сходимости для алгоритма обучения пeрсептрона с фиксированным приращением для персептрона формулируется следующим образом.
Пусть подмножества векторов обучения Х1 и Х2 линейно разделимы. Пусть входные сигналы поступают персептрону только их этих подмножеств. Тогда алгоритм обучения персептрона сходится после некоторого числа n0 итераций в том смысле, что w(n0)= w(n0+1) = w(n0+2) = … является вектором ре-
шения для n0<= nmax.
Теперь рассмотрим абсолютную процедуру адаптации однослойного персептрона на основе коррекции ошибок, в которой (n)– переменная величина.
В частности, пусть (n)– наименьшее целое число, для которого выполняется соотношение
(n)xT (n)x(n) wT (n)x(n) .
103
Согласно этой процедуре, если скалярное произведение wT(n)x(n) на шаге n имеет неверный знак, то wT(n + 1)х(n) на итерации n+1 будет иметь правильный знак. Таким образом, предполагается, что если знак произведения wT(n)x(n) некорректен, то можно изменить последовательность обучения для итерации n+1, приняв х(n+1)=х(n). Другими словами, каждый из образов представляется персептрону до тех пор, пока он не будет классифицирован корректно.
Использование отличного от нулевого исходного состояния w(0) приводит к увеличению или уменьшению количества итераций, необходимых для сходимости в зависимости от того, насколько близким окажется исходное состояние w(0) к решению w0. Однако независимо от исходного значения w(0) сходимость все равно будет обеспечена.
В табл. 2.10 представлен общий алгоритм обучения персептрона. Таблица 2.10
Общий алгоритм реализации обученияперсептрона
Исходные данные |
Последовательность |
|
Содержание |
|
||
|
шагов |
|
шагов |
|
||
x(n) 1,x1(n),..., xm (n) T - |
1.Инициализация |
Пусть w(0)=0. После- |
||||
вeктop-стpокa размерно- |
|
дующие вычисления вы- |
||||
сти m+l; |
|
полняются для шаrов n = |
||||
w(n) b(n),w1(n),..., wm (n) T - |
|
1, 2,… |
|
|
|
|
2. Активация |
На шаге n |
активируем |
||||
вeктop-стpокa размерно- |
||||||
сти m+l; |
|
персептрон, |
используя |
|||
|
вектор х(n) с веществен- |
|||||
b(n)-порог; |
|
|||||
|
ными |
компонентами |
и |
|||
y(n)- фактический отклик |
|
|||||
|
желаемый отклик d(n). |
|||||
(дискретизированный); |
|
|||||
3. Вычисление фактиче- |
y(n) sgn(wT (n)x(n)) , |
где |
||||
d(n)-желаемый отклик; |
||||||
0 1-параметр скоро- |
ского ответа |
sgn(.) |
функция вычисле- |
|||
сти обучения |
|
ния знака aргyментa |
|
|||
4. Адаптация вектора ве- |
Изменение вектора весов |
|||||
|
||||||
|
сов |
персептрона |
|
|
||
|
5. Возврат к п. 2 |
|
|
|
|
|
Таким образом, алгоритм адаптации вектора весовых коэффициентов |
|
|||||
w(n) соответствует правилу обучения на основе коррекции ошибок: |
|
|
||||
|
w(n 1) w(n) d(n) -y(n) x(n) , |
|
(2.49) |
|||
где – параметр скорости обучения, а разность d(n)-у(n) выступает в ро-
ли сигнала ошибки. Параметр скорости обучения является положительной константой, принадлежащей интервалу 0 1. Выбирая значение параметра ско-
рости обучения из этогo диапазона, следует учитывать два взаимоисключающих требования.
1. Усреднение предыдущих входных сигналов, обеспечивающее устойчивость оценки вектора весов, требует малых значений .
104
2. Быстрая адаптация к реальным изменениям распределения процесса, отвечающего за формирование векторов входноrо сиrнала х, требует больших значений .
Для решения сложных задач в ПК НПВР используются многослойные персептроны. Они имеют три отличительных признака.
1. Каждый нейрон сети имеет нелинейную функцию активации, которая является гладкой (т.е. всюду дифференцируемой), в отличие от жесткой пороговой функции, используемой в персептроне Розенблатта. Такому требованию, например, удовлетворяет сигмоидальная логистическая функция
yj |
|
|
1 |
, |
(2.50) |
|
1 |
exp( vj) |
|||||
|
|
|
||||
где vj – индуцированное локальное поле (т.е. взвешенная сумма всех синаптических входов плюс пороговое значение) нейрона j; yj – выход нейрона. Наличие нелинейности играет очень важную роль, так как в противном случае отображение "вход-выход" сети можно свести к обычному однослойному персептрону. Более того, использование логистической функции мотивировано биологически, так как в ней учитывается восстановительная фаза реального нейрона.
2.Сеть содержит один или несколько слоев скрытых нейронов, не являющихся частью входа или выхода сети. Эти нейроны позволяют сети обучаться решению сложных задач, последовательно извлекая наиболее важные признаки из входного образа (вектора).
3.Сеть обладает высокой степенью связности, реализуемой посредством синаптических соединений. Изменение уровня связности сети требует изменения множества синаптических соединений или их весовых коэффициентов.
Комбинация вышеизложенных свойств характеризует вычислительную мощность многослойного персептрона. Эти же свойства являются причиной непрозрачности функционирования персептронов (неполноты современных знаний о их поведении) [84]. Во-первых, распределенная форма нелинейности и высокая связность сети существенно усложняют теоретический анализ многослойного персептрона. Во-вторых, наличие скрытых нейронов затрудняет процесс визуализации обучения. В процессе обучения определяется набор признаков входного сигнала, которые следует представлять скрытыми нейронами. Это приводит к усложнению процесса обучения по причине необходимости выполнения поиска в широкой области возможных функций, поскольку выбор должен производиться среди альтернативных представлений входных образов
[223].
На рис. 2.26 показан структурный граф многослойного персептрона с двумя скрытыми слоями и одним выходным слоем. Показанная на рисунке сеть является полносвязной. Это значит, что каждый нейрон в любом слое сети связан со всеми нейронами (узлами) предыдущего слоя. Сигнал передается по сети
впрямом направлении, слева направо, от слоя к слою.
105