Материал: Модели и алгоритмы проектирования и разработки систем поддержки принятия инвестиционных решений. Морозов В.П., Баркалов С.А
|
|
|
Выходной |
Входной |
|
|
сигнал |
сигнал |
. |
. |
. |
|
. |
. |
. |
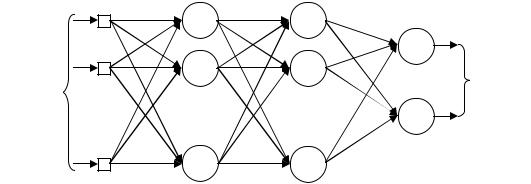
Рис. 2.26. Структурный граф многослойного персептрона
Функциональный сигнал это входной сигнал, поступающий в сеть и передаваемый вперед от нейрона к нейрону по всей сети. Такой сигнал достигает конца сети в виде выходного сигнала. Данный сигнал является функциональным по двум причинам. Во-первых, он предназначен для выполнения некоторой функции на выходе сети. Во-вторых, в каждом нейроне, через который передается этот сигнал, вычисляется некоторая функция с учетом весовых коэффициентов.
Выходные нейроны составляют выходной слой сети. Остальные нейроны относятся к скрытым слоям. Первый скрытый слой получает данные из входного слоя, составленного из сенсорных элементов (входных узлов). Результирующий сигнал первого скрытого слоя, в свою очередь, поступает на следующий скрытый слой, и т.д. до самого конца сети.
Любой скрытый или выходной нейрон многослойного персептрона может выполнять два типа вычислений.
1.Вычисление функционального сигнала на выходе нейрона, реализуемое
ввиде непрерывной нелинейной функции от входного сигнала и синаптических весов, связанных с данным нейроном.
2.Вычисление оценки вектора градиента (т.е. градиента поверхности ошибки по синаптическим весам, связанным со входами данного нейрона), необходимого для обратного прохода через сеть.
Один из важных теоретических вопросов применительно к многослойным персептронам заключается в определении минимального числа скрытых слоев, обеспечивающих аппроксимацию некоторого непрерывного отображения. Ответ содержится в формулировке и доказательстве теоремы об универсальной аппроксимации для нелинейного отображения. Данная теорема представляет собой расширение теоремы Вейерштрасса [223]. Эта теорема утверждает, что любая непрерывная функция на замкнутом интервале действительной оси может быть представлена абсолютно и равномерно сходящимся рядом полиномов. Впервые интерес к данной теме возник в работе Розенблатта [224]. Для доказательства теоремы об универсальной аппроксимации использовалась
106

усовершенствованная теорема Колмогорова о суперпозиции [223]. В дальнейшем было показано, что многослойный персептрон с одним скрытым слоем, косинусоидальной пороговой функцией и линейным выходным слоем представляет собой частый случай "сети Фурье", обеспечивающей на выходе аппроксимацию заданной функции рядом Фурье [222]. Данная теорема формулировалась следующим образом.
Пусть ( )ограниченная, не постоянная монотонно возрастающая непре-
рывная функция. Пусть Imo – mо-мерный единичный гиперкуб [0, 1]m0 . Пусть пространство непрерывных на Imo функций обозначается символом С(Imo). То-
гда для любой функции fC(Imo) и > 0 существует такое целое число m1 и множество действительных констант i , bi и wij, где i = 1, . . . , m1, j = 1, . . . , mо, что
|
m |
m |
|
|
F(x1,..., xm0 |
) 1 |
i ( 0 |
wij xj bi ), |
(2.51) |
|
i 1 |
j 1 |
|
|
является реализацией аппроксимации функции ( ), т.е.
F(x1,...,xm0 ) f (x1,...,xm0 ) |
|
(2.52) |
для всех x1,...,xm0 , принадлежащих входному пространству.
Теорема об универсальной аппроксимации непосредственно применима к многослойному персептрону, так как в модели многослойного персептрона в качестве функции активации используется ограниченная, монотонно возрастающая логистическая функция 1/[1+ехр(-v)], удовлетворяющая условиям, накладываемым теоремой на функцию ( ). ИНС (сеть Фурье) в символьном вы-
ражении данной теоремы описывается следующим образом.
1.Сеть содержит m0 входных узлов и один скрытый слой, состоящий из m1 нейронов. Входы обозначены x1, х2, . . . , хто.
2.Скрытый нейрон i имеет синаптические веса wi1 , . . . , wmo и порог bi.
3.Выход сети представляет собой линейную комбинацию выходных сигналов скрытых нейронов, взвешенных синаптическими весами выходного
нейрона - 1,..., m1 .
Выражения (2.51) и (2.52) устанавливают тот факт, что многослойного персептрона с одним скрытым слоем достаточно для построения равномерной аппроксимации с точностью для любого обучающего множества, представленного набором входов х1,х2,..., хто и желаемых откликов f(x1,x2,..., хто). Однако из теоремы не следует, что одного скрытого слоя ИНС достаточно для достижения ее качественногообобщения и минимального времени обучения.
В [222] приведены результаты исследований аппроксимирующих свойств персептрона с одним скрытым слоем, с сигмоидальной функцией активации и одним выходным нейроном. Эта сеть обучалась с помощью алгоритма обратного
107

распространения ошибок, после чего тестировалась на новых данных. Во время обучения сети предъявлялись выбранные точки аппроксимируемой функции f, в результате чего была получена аппроксимирующая функция F, определяемая выражением (2.51). Если сети предъявлялись не использованные ранее данные, то функцияF"оценивала"новые точкицелевойфункции,т.е.F=f.
Гладкость целевой функции f выражалась в терминах Фурье разложения. В частности, в качестве значения предельной амплитуды функции f использовалось среднее значение нормы вектора частоты, взвешенного значениями амплитуды распределения Фурье. Пусть fˆ(w) – многомерное преобразование Фу-
рье функции f(х), x m0 , где w – вектор частоты. Функция f(x), представленная в терминах преобразования Фурье fˆ(w) , определяется следующей инверсной формулой:
|
|
f (x) |
~f (w)exp( jwT x)dw , |
(2.53) |
|
|
|
m0 |
|
где j |
|
. Для комплекснозначной функции fˆ(w) |
с интегрируемой |
|
1 |
||||
функцией w fˆ(w) первый абсолютный момент распределения Фурье функции f можно определить следующим образом:
Cf |
| ~f (w)| || w||0,5dw, |
(2.54) |
|
m0 |
|
где ||w|| — Евклидова норма вектора w; |f(w)| — абсолютное значение функции f(w). Первый абсолютный момент Cf является мерой гладкости функции f. Первый абсолютный момент Cf является основой для вычисления пределов ошибки, которая возникает вследствие использования многослойного персептрона, представленного функцией отображения "вход-выход" F(х), аппроксимирующей функцию f(х). Ошибка аппроксимации измеряется интегральной квадратичной ошибкой по произвольной мере вероятности для шара
Br {x:
 x

 r}радиуса r > 0. На этом основании можно сформулировать сле-
дующее утверждение для предела ошибки аппроксимации [225].
Для любой непрерывной функции f(x) с конечным первым моментом Cf и любого m1> 1 существует некоторая линейная комбинация сигмоидальных функций F(x) вида (2.51), такая, что
(f (x) F(x))2 |
(dx) |
C'f |
, |
(2.55) |
|
||||
Br |
|
m1 |
|
|
где C'f (2rCf )2.
Если функция f(х) наблюдается на множестве значений {xi}iN1 входного
вектора х, принадлежащего шару Вr, этот результат определяет следующее ограничение для эмпирического риска:
108
R |
1 |
N |
( f (xi ) F(xi ))2 |
C'f |
. |
(2.56) |
N |
|
|||||
|
i 1 |
|
m1 |
|
||
В [222] результат (2.56) использовался для описания гpаниц риска R, возникающеrо при использовании многослойноrо персептрона с mо входными узлами и m1 скрытыми нейронами:
C2f |
|
|
m m |
|
|
||
|
|
|
O( |
0 |
1 |
logN). |
(2.57) |
R O m |
|
N |
|
||||
1 |
|
|
|
|
|
|
|
Два слагаемых в этом определении границ риска R отражают компромисс между двумя противоречивыми требованиями к размеру скрытого слоя (величина m1 входит в знаменатель первого слагаемого и в числитель второго).
Кроме того, ограничение (2.57) показывает, что для точной оценки целевой функции не требуется экспоненциально большого обучающего множества и большой размерности входного пространства m0, если первый абсолютный момент Cf остается конечным. Последнее подтверждает практическую ценность многослойного персептрона, используемого в качестве универсального аппроксиматора. При этом разность между эмпирическим и оптимальным значениями аппроксимации можно рассматривать как ошибку оценивания. Пусть 0 - сред-
неквадратическое значение ошибки оценивания. Тогда, игнорируя логарифмический множитель во втором слагаемом неравенства (2.57), можно сделать вывод, что размер N обучающего множества, необходимый для хорошего обобщения, должен иметь порядок m0m1/ 0 . Это значит, что для качественной аппрок-
симации размер обучающего множества должен превышать отношение общего количества свободных параметров сети к среднеквадратическому значению ошибки оценивания.
Из ограничения (2.57) вытекает еще один результат. Если размер скрытого слоя выбирается по формуле (т.е. риск R минимизируется по N)
m1 Cf ( |
N |
)1 2 , |
(2.58) |
|
m logN |
||||
|
|
|
||
|
0 |
|
|
то риск R ограничивается величиной O(Cf 
 m0(logN
 N)). То есть скорость
сходимости, представленная как функция от размера обучающего множества N, имеет порядок (1/N)1/2, умноженный на логарифмический член. Однако обычная гладкая функция (например, тригонометрическая или полиномиальная) демонстрирует другое поведение. Пусть s — мера гладкости, определяемая как степень дифференцируемости функции (количество существующих производ-
ных). Тогда для обычной гладкой функции минимаксная скорость сходимости общего риска R имеет порядок (l/N)2s/(2s+m°). Зависимость этой скорости от раз-
мерности входного пространства т0 называют "проклятием размерности". Это свойство ограничивает практическое использование таких функций. Следовательно, использование многослойного персептрона для решения задач аппрок-
109
симации обеспечивает определенные преимущества перед обычными гладкими функциями. Данное преимущество появляется при условии, что первый абсолютный момент Cf остается конечным. В этом состоит ограничение гладкости.
Термин "проклятие размерности" был введен Ричардом Белманом в 1961 году в работе, посвященной процессам адаптивного управления [203]. Рассмотрим пример, в котором х - m0-мерный входной вектор, а множество {(хi,di)},i = 1, 2,..., N, задает обучающую выборку. Плотность дискретизации пропорциональна значению N1/m0. Пусть f(х) — поверхность в m0-мерном входном про-
странстве, проходящая около точек данных {xi ,di}iN1 . Если функция f(х) дос-
таточно сложна и (по большей части) абсолютно неизвестна, необходимо уплотнить точки данных для более полного изучения поверхности. В многомерном пространстве из-за "проклятия размерности" очень сложно найти обучающую выборку с высокой плотностью дискретизации. В частности, в результате увеличения размерности наблюдается экспоненциальный рост сложности, что, в свою очередь, приводит к ухудшению пространственных свойств случайных точек с равномерным распределением.
Функция, определенная в пространстве большой размерности, является значительно более сложной, чем функция, определенная в пространстве меньшей размерности, и эту сложность трудно выявить. Единственной возможностью избежать "проклятия размерности" является получение корректных априорных знаний о функции, определяемой данными обучения. Следовательно, для практического получения хорошей оценки в пространствах высокой размерности необходимо обеспечить возрастание гладкости неизвестной функции наряду с увеличением размерности входных данных [225].
Теорема об универсальной аппроксимации имеет важное теоретическое значение. Она доказывает возможность применения сетей прямого распространения с одним скрытым слоем для решения задач аппроксимации. Воспользоваться на практике результатами данной теоремы затруднительно потому, что у многослойного персептрона с одним скрытым слоем нейроны могут взаимодействовать друг с другом на глобальном уровне. Последнее усложняет задачу повышения качества аппроксимации в одной точке без явного ухудшения в другой. Возникает необходимость использования нескольких скрытых слоев. Однакоданная теорема необосновывает их использование.
Технология применения двух скрытых слоев состоит в следующем. Локальные признаки извлекаются в первом скрытом слое, т.е. некоторые
скрытые нейроны первого слоя можно использовать для разделения входного пространства на отдельные области, а остальные нейроны слоя обучать локальным признакам, характеризующим эти области. Глобальные признаки извлекаются во втором скрытом слое. В частности, нейрон второго скрытого слоя "обобщает" выходные сигналы нейронов первого скрытого слоя, относящихся к конкретной области входного пространства. Таким образом, он обучается глобальным признакам этой области, а в остальных областях его выходной сигнал
110