Дипломная (вкр): Нейросетевой механизм
Нейросетевой механизм
МИНИСТЕРСТВО ОБРАЗОВАНИЯ И НАУКИ РОССИЙСКОЙ ФЕДЕРАЦИИ
Федеральное государственное бюджетное образовательное учреждение
высшего профессионального образования
“КУБАНСКИЙ ГОСУДАРСТВЕННЫЙ УНИВЕРСИТЕТ”
(ФГБОУ ВПО “КубГУ”)
Кафедра информационных технологий
ВЫПУСКНАЯ КВАЛИФИКАЦИОННАЯ РАБОТА БАКАЛАВРА
НЕЙРОСЕТЕВОЙ МЕХАНИЗМ
Работу выполнил Р.Б. Ревякин
Факультет Компьютерных Технологий и Прикладной Математики
Направление 010501 “ Прикладная математика и информатика ”
Научный руководитель преп. А.В. Уварова
Нормоконтролер ст. преп. А.В.Харченко
Краснодар 2014
СОДЕРЖАНИЕ
ВВЕДЕНИЕ
1 Теоретические сведения об аппроксимации и нейронных сетях
1.1 Многослойные сети прямого распространения
1.2 Обобщающая способность многослойного персептрона
1.2.1 Достаточный объём примеров обучения для корректного обобщения
1.3 Аппроксимация функций
1.3.1 Теорема об универсальной аппроксимации.
1.3.2 Пределы ошибок аппроксимации
1.3.3 Ограничение размерности
1.3.4 Практические соображения
1.4 Нормализация входных данных нейронной сети
1.5 Математический метод аппроксимации
2 Постановка задачи и проектное решение
2.1 Постановка задачи
2.2 Сервис OpenWeatherMap
2.2.1 OpenWeatherMap API
2.3 Получение, обработка и нормализация исходных данных
2.3.1 Получение и обработка данных
2.3.2 Проблемы возникшие на этапе получения и обработки данных
2.3.4 Обучающая и тестовая выборка
2.4 Нейронная сеть
2.4.1 Подбор конфигурации сети.
2.4.2 Оптимизация и дообучение нейронной сети
2.4.3 Обучение и тестирование нейронной сети
2.5 Аппроксимация
2.5.1 Результат работы нейронной сети
2.5.2 Сравнение с математическим методом
3 Реализация программной системы
3.2 JSON и возможности фреймворка JSON-Simple
3.4 Программная реализация
3.4.3 Описание проекта WebWeatherView
4 Графический интерфейс пользователя
ЗАКЛЮЧЕНИЕ
СПИСОК
ИСПОЛЬЗОВАННЫХ ИСТОЧНИКОВ
ВВЕДЕНИЕ
В настоящее время интернет стал неотъемлемой частью жизни большого числа людей, каждый человек ежедневно пользуется множеством различных приложений и сервисов. И погодные сервисы занимают не последнее место по популярности. Люди привыкли знать какая будет погода за окном и всегда могут с лёгкостью получить требуемое. Но, в основном, сайты и приложения дающие погодную сводку обладают информацией лишь о городах и крупных населённых пунктах. Также они не дают возможности получить погодные сведения, например, на каком-либо маршруте движения, что не позволяет человеку иметь полную картину об интересующих его погодных условиях.
В связи с этим возрастает значимость сервисов отображающих погодные сведения на карте и позволяющих узнать, что приблизительно будет происходить в любой интересующей точке. Поскольку точные сведения доступны лишь в городах и населённых пунктах обладающих метеорологическими станциями, а распространение полученных с этих станций данных по карте возможно лишь с помощью аппроксимации, эти данные носят приблизительный характер. И чем точнее аппроксимация, тем выше практическая применимость таких сервисов. А нужда в максимально точных данных имеется, например, для агропромышленной индустрии, тут потребность в точных локальных прогнозах очень высока.
На основании имеющейся информации, в данный момент для решения задачи аппроксимации используются стандартные математические методы. Перспективным, в смысле увеличения точности аппроксимации, может оказаться использование нейронной сети. В частности, для многослойного персептрона доказана теорема об универсальной аппроксимации, являющаяся математическим доказательством возможности аппроксимации любой непрерывной функции.
Целью дипломной работы является разработка нейросетевой технологии, решающей задачу аппроксимации погодных данных на примере температуры, и веб представления, отображающего результат аппроксимации и позволяющего получить погодные данные в любой интересующей пользователя точке.
Первая глава дипломной работы содержит теоретическое обоснование применения нейросетевого механизма к задаче аппроксимации.
Вторая глава посвящена постановке задачи и проектному решению.
Третья глава содержит реализацию программного продукта.
Четвёртая глава содержит интерфейс пользователя.
1 ТЕОРЕТИЧЕСКИЕ СВЕДЕНИЯ ОБ АППРОКСИМАЦИИ И НЕЙРОННЫХ СЕТЯХ
.1 Многослойные сети прямого распространения
Класс многослойных нейронных сетей прямого распространения
характеризуется наличием одного или нескольких скрытых слоёв, узлы которых
называются скрытыми нейронами, или скрытыми элементами. Функция последних
заключается в посредничестве между внешним входным сигналом и выходом нейронной
сети. Добавляя один или несколько скрытых слоёв, мы можем выделить статистики
высокого порядка. Такая сеть позволяет выделять глобальные свойства данных с
помощью локальных соединений за счёт наличия дополнительных синаптических
связей и повышения уровня взаимодействия нейронов. Способность скрытых нейронов
выделять статистические зависимости высокого порядка особенно существенна,
когда размер входного слоя достаточно велик [1].
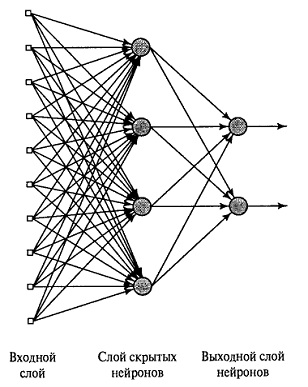
Рисунок 1.1 - Многослойная сеть прямого распространения
Узлы источника входного слоя сети формируют соответствующие элементы шаблона активации (входной вектор), которые составляют входной сигнал, поступающий на нейроны (вычислительные элементы) второго слоя. Выходные сигналы второго слоя используются в качестве входных для третьего слоя и т.д. Обычно нейроны каждого из слоёв сети используют в качестве входных сигналов выходные сигналы нейронов только предыдущего слоя. Набор выходных сигналов нейронов выходного слоя сети определяет общий отклик сети на данный входной образ, сформированный узлами источника входного слоя. Сеть, показанная на рисунке 1.1, называется сеть 10-4-2, так как она имеет 10 входных, 4 скрытых, и 2 выходных нейрона. Нейронная сеть, показанная на рисунке 1.1, считается полносвязной в том смысле, что все узлы каждого конкретного слоя соединены со всеми узлами смежных слоёв. Если некоторые из синаптических связей отсутствуют, такая сеть называется неполносвязной [2].
.2 Обобщающая способность многослойного персептрона
При обучении методом обратного распространения ошибки в сеть подают обучающую выборку и вычисляют синаптические веса многослойного персептрона, загружая в сеть максимально возможное количество примеров. При этом разработчик надеется, что обученная таким образом сеть будет способна к обобщению. Считается, что сеть обладает хорошей обобщающей способностью, если отображение входа на выход, осуществляемое ею, является корректным (или близким к этому) для данных, никогда ранее не «виденных» сетью в процессе обучения [1].
Процесс обучения нейронной сети можно рассматривать как задачу аппроксимации кривой. Сама сеть при этом выступает как один нелинейный оператор. Такая точка зрения позволяет считать обобщение результатом хорошей нелинейной интерполяции входных данных.
Сеть осуществляет корректную интерполяцию в основном за счёт того, что непрерывность отдельных функций активации многослойного персептрона обеспечивает непрерывность общей выходной функции [1].
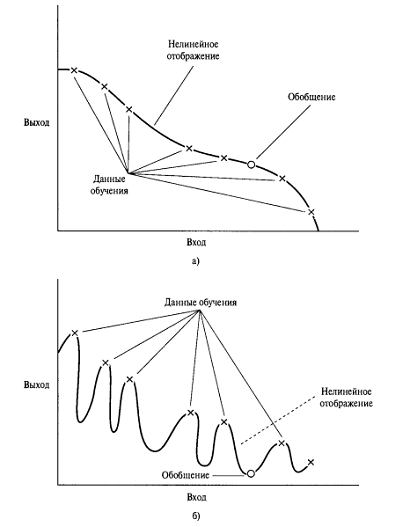
На рисунке 1,a показано, как происходит обобщение в гипотетической сети. Нелинейное отображение входа на выход, показанное на этом рисунке, определяется сетью в результате обучения по дискретным точкам (обучающим данным). Точку, полученную в процессе обобщения и обозначенную незаштрихованным кружочком, можно рассматривать как результат выполняемой сетью интерполяции.
Нейронная сеть, спроектированная с учётом хорошего обобщения, будет осуществлять корректное отображение входа на выход даже тогда, когда входной сигнал слегка отличается от примеров, использованных для обучения сети (что и показано на рисунке). Однако, если сеть обучается на слишком большом количестве примеров, всё может закончиться только запоминанием данных обучения. Это может произойти за счёт нахождения таких признаков (например, благодаря шуму), которые присутствуют в примерах обучения, но не свойственны самой моделируемой функции отображения. Такое явление называют избыточным обучения, или переобучением. Если сеть «переучена», она теряет свою способность к обобщению на аналогичных входных сигналах.
Обычно загрузка данных в многослойный персептрон таким способом требует
использования большого количества скрытых нейронов, чем действительно
необходимо. Это выливается в нежелательное изменение входного пространства
из-за шума, который содержится в синаптических весах сети. Пример плохого
обобщения вследствие простого запоминания обучающих образов показан на рисунке
1.2,б для тех же данных, которые показаны на рисунке 1.2,а. Результат
запоминания, в сущности, представляет собой справочную таблицу - список пар
«вход-выход», вычисленных нейронной сетью. При этом отображение теряет свою
гладкость. Гладкость отображения входа на выход непосредственно связана с
критерием моделирования, который получил название бритвы Оккама. Сущность этого
критерия состоит в выборе простейшей функции при отсутствии каких-либо
дополнительных априорных знаний. В контексте предыдущего обсуждения
«простейшей» является самая гладкая из функций, аппроксимирующих отображение
для данного критерия ошибки, так как такой подход требует минимальных
вычислительных ресурсов. Гладкость свойственна многим приложениям и зависит от
масштаба изучаемого явления. Таким образом, для плохо обусловленных отношений
важно искать гладкое нелинейное отображение. При этом сеть будет способна
корректно классифицировать новые сигналы относительно примеров обучения [1].
1.2.1 Достаточный объём примеров обучения для корректного обобщения
Способность к обобщению определяется тремя факторами: размером обучающего множества и его представительностью, архитектурой нейронной сети и физической сложностью рассматриваемой задачи. Естественно, последний фактор выходит за пределы нашего влияния. В контексте остальных факторов вопрос обобщения можно рассматривать с двух различных точек зрения.
Архитектура сети фиксирована и вопрос сводится к определению размера обучающего множества, необходимого для хорошего обобщения.
Размер обучающего множества фиксирован, и вопрос сводится к определению наилучшей архитектуры сети, позволяющей достичь хорошего обобщения.
Обе точки зрения по-своему правильны. До сих пор мы фокусировали внимание на первом аспекте проблемы [1].- измерение обеспечивает теоретический базис для принципиального решения задачи определения адекватности размера обучающей выборки. В частности, получены независимые от распределения пессимистические формулы оценки размера обучающего множества, достаточного для хорошего обобщения. К сожалению, часто оказывается, что между действительно достаточным размером обучения и этими оценками может существовать большой разрыв. Из-за этого расхождения возникает задача сложности выборки, открывающая новую область исследований.
На практике оказывается, что для хорошего обобщения достаточно, чтобы
размер обучающего множества N удовлетворял следующему соотношению:
 (1)
где
W - общее количество свободных параметров (т.е. синаптических весов и порогов)
сети;  -
допустимая точность ошибки классификации; O(ю) - порядок заключенной в скобки
величины. Например, для ошибки в 10% количество примеров обучения должно в 10
раз превосходить количество свободных параметров сети.
Выражение
(1) получено из эмпирического правила Видроу для алгоритма LMS, утверждающего,
что время стабилизации процесса линейной адаптивной временной фильтрации
примерно равно объёму памяти линейного адаптивного фильтра в задаче фильтра на
линии задержки с отводами, делённому на величину рассогласования.
Рассогласование в алгоритме LMS выступает в роли ошибки из
выражения (1).
.3 Аппроксимация функций
Многослойный персептрон, обучаемый согласно алгоритму обратного распространения ошибки, можно рассматривать как практический механизм реализации нелинейного отображения «вход-выход» общего вида. Например, путь m0 - количество входных узлов многослойного персептрона, M = mL - количество нейронов выходного слоя сети. Отношение «вход-выход» для такой сети определяет отображение m0-мерного Евклидова пространства входных данных в M-мерное Евклидово пространство выходных сигналов, непрерывно дифференцируемое бесконечное число раз (если этому условию удовлетворяют и функции активации). При рассмотрении свойств многослойного персептрона с точки зрения отображения «вход-выход» возникает следующий фундаментальный вопрос: «Какое минимальное количество скрытых слоёв многослойного персептрона, обеспечивающего аппроксимацию некоторого непрерывного отображения?» [1].
1.3.1 Теорема об универсальной аппроксимации.
Ответ на этот вопрос обеспечивает теорема об универсальной аппроксимации для нелинейного отображения «вход-выход», которая формулируется следующим образом:
Пусть φ(.) - ограниченная, не постоянная монотонно возрастающая
непрерывная функция. Пусть Im0 - m0-мерный единичный гиперкуб [0, 1]m0. Пусть пространство непрерывных на Im0 функций обозначается символом C(Im0). Тогда для любой функции f ⊂ (Im0) и ε > 0 существует такое целое число
m1 и множество действительных констант αi, bi и ωij, где I =
1,…,m1, j = 1,…,m0,
что
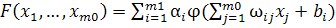 (2)
является
реализацией аппроксимации функции f(.), то есть
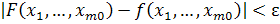 (3)
для
всех  ,
принадлежащих входному пространству [1].
Универсальную теорему аппроксимации можно рассматривать как естественное расширение теоремы Вейерштрасса. Эта теорема утверждает, что любая непрерывная функция на замкнутом интервале действительной оси может быть представлена абсолютно и равномерно сходящимся рядом полиномов.
Теорема
об универсальной аппроксимации непосредственно применима к многослойному
персептрону. Во-первых, в модели многослойного персептрона в качестве функции
активации используется ограниченная, монотонно возрастающая логистическая
функция  ,
удовлетворяющая условиям, накладываемым теоремой на функцию φ(.).Во-вторых, выражение (2) описывает выходной сигнал
персептрона следующего вида:
Сеть
содержит m0 входных узлов и один скрытый слой, состоящий из m1
нейронов. Входы обозначены .
Скрытый
нейрон i имеет синаптические веса  и порог
bi.
Выход
сети представляет собой линейную комбинацию выходных сигналов скрытых нейронов,
взвешенных синаптическими весами выходного нейрона -  .
Теорема
об универсальной аппроксимации является теоремой существования, т.е.
математическим доказательством возможности аппроксимации любой непрерывной
функции. Выражение, составляющее стержень теоремы, просто обобщает описание
аппроксимации функции конечным рядом Фурье. Таким образом, теорема утверждает,
что многослойного персептрона с одним скрытым слоем достаточно для построения
равномерной аппроксимации с точностью ε для любого обучающего множества, представленного
набором входов и
желаемых откликов f(). Тем не
менее из теоремы не следует, что один скрытый слой является оптимальным в
смысле времени обучения, простоты реализации и, что более важно, качества
обобщения [1].