Дипломная (вкр): Нейросетевой механизм

где
вектор-функция  является
инверсной к функции f(.). Обратим внимание, что функция не
является обратной к функции . Здесь
верхний индекс -1 используется только как индикатор инверсии. Во многих
ситуациях на практике функция f(.) может быть достаточно сложной, что делает
практически невозможным формальный вывод обратной функции . Однако
на основе множества маркированных примеров (13) можно построить нейронную сеть,
аппроксимирующую обратную функцию С
помощью схемы, изображённой на рисунке 1.3. В данной ситуации роли векторов xi и di
меняются: вектор di используется как входной сигнал, а вектор xi -
как желаемый отклик. Пусть вектор сигнала ошибки определяется как разность
между вектором xi и выходом нейронной сети yi, полученным в
ответ на возмущение di. Как и в задаче идентификации системы, вектор сигнала
ошибки используется для корректировки свободных параметров нейронной сети с
целью минимизации суммы квадратов разностей между выходами неизвестной
инверсной системы и нейронной сети в статистическом смысле (т.е. вычисляемой на
всём множестве примеров обучения).
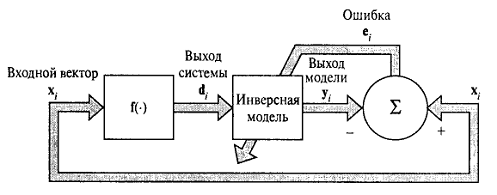
Рисунок 1.4 - Блочная диаграмма моделирования инверсной системы
1.4 Нормализация входных данных нейронной сети
Нормализация входных данных - это процесс, при котором все входные данные проходят процесс "выравнивания", т.е. приведения к определённому интервалу, например [0,1] или [-1,1]. Нормализация позволяет значительно повысить скорость сходимости алгоритма обучения нейронной сети. Если не провести нормализацию, то входные данные будут оказывать дополнительное влияние на нейрон, что может привести к неверным решениям. Другими словами, нельзя сравнивать величины разных порядков [2].
Простейшие методы нормализации входных данных:
. Нормализация с использованием математического ожидания и дисперсии.
Выполним
предобработку данных - нормировку исходных данных 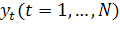 , для
этого воспользуемся стандартной формулой:
 (14)
где
 - новая
переменная;
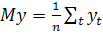 -
выборочная оценка математического ожидания;
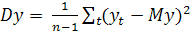 -
выборочная оценка дисперсии.
Чтобы
полученный выход сети соответствовал реальному используется формула 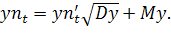
2. Нормализация с использованием минимаксной функции.
Минимаксная функция, выполняет линейное преобразование после определения минимального и максимального значений функции так, чтобы получаемые значения находились в нужном диапазоне.
В общем виде формула нормализации выглядит так [3]:
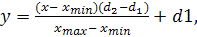 (15)
где:- значение, подлежащее нормализации;
[xmin, xmax] - интервал значений x;
[d1, d2] - интервал, к которому будет приведено значение x.
Есть и более основательные и трудоёмкие подходы к нормализации, вот например:
Все входные переменные должны быть предварительно обработаны так, чтобы среднее значение по всему обучающему множеству было близко к нулю, иначе их будет сложно сравнивать со стандартным отклонением. Для оценки практической значимости этого правила рассмотрим экстремальный случай, когда все входные переменные положительны. В этом случае синаптические веса нейрона первого скрытого слоя могут либо одновременно увеличиваться, либо одновременно уменьшаться. Следовательно, вектор весов этого нейрона будет менять направление, что приведёт к зигзагообразному движению по поверхности ошибки. Такая ситуация обычно замедляет процесс обучения и, таким образом, неприемлема [1].
Чтобы ускорить процесс обучения методом обратного распространения, входные векторы необходимо нормализовать в двух следующих аспектах:
а) Входные переменные, содержащиеся в обучающем множестве, должные быть некоррелированны. Этого можно добиться с помощью анализа главных компонентов.
б) Некоррелированные входные переменные должны быть масштабированы так, чтобы их ковариация была приблизительно равной. Тогда различные синаптические веса сети будут обучаться приблизительно с одной скоростью.
На рисунке 1.5 показан результат трёх шагов нормализации: смещения среднего, декорреляции и выравнивания ковариации, применённых в указанном порядке.
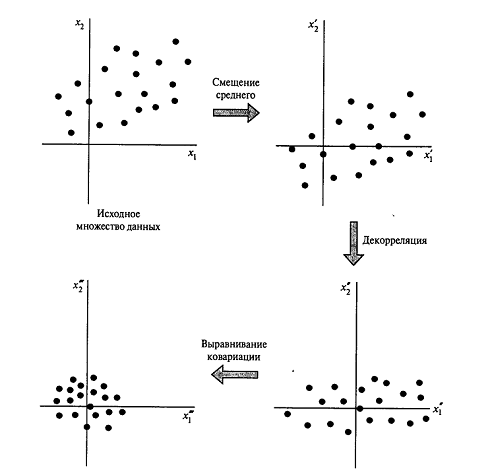
Рисунок 1.5 - Результаты трёх шагов нормализации: смещения среднего, декорреляции и выравнивания ковариации
.5 Математический метод аппроксимации
Рассмотрим стандартные методы аппроксимации на примере Эрмитовой интерполяции.
Эрмитова интерполяция строит многочлен, значения которого в выбранных точках совпадают со значениями исходной функции в этих точках, и производные многочлена в данных точках совпадают со значениями производных функции (до некоторого порядка m). Это означает, что n(m+1) величин [4]:
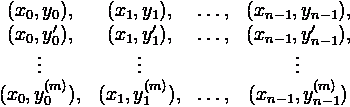
должны быть известны, тогда как для ньютоновской интерполяции необходимы только первые n значений. Полученный многочлен может иметь степень не более, чем n(m+1)−1, максимальная степень многочлена Ньютона же равна n−1. (В общем случае m не обязательно должно быть фиксировано, то есть в одних точках может быть известно значение большего количества производных, чем в других. В этом случае многочлен будет иметь степень N−1, где N - число известных значений) [4].
Простой случай:
При
использовании разделенных разностей для вычисления многочлена Эрмита, первым
шагом является копирование каждой точки m раз. (Здесь рассматривается простой
случай, когда для всех точек m=1.) Поэтому, дана n+1 точка x0,…,xn, и значения f(x0),…,f(xn)
и f(x0),…,f(xn) 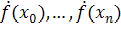 функции
f, которую необходимо интерполировать. Определяется новый набор данных: z0, …,
z2n+1, такой, что z2i = z2i+1 = xi. Теперь определяется таблица разделенных разностей
для точек z0, …, z2n+1. Однако, для некоторых разделенных разностей
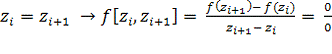
что
является неопределенностью. В этом случае происходит замена этой разделенной
разности значением  , а
другие вычисляются обычным способом.
Общий случай:
В
общем случае полагаем, что в данных точках  известны
производные функции f до порядка k включительно. Тогда набор данных z0, …, zN содержит
k копий xi. При создании таблицы, разделенных разностей при j = 2, 3, …, k
одинаковые значения будут вычислены как
 [4].
Например,
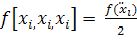 ,
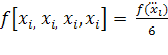 и так
далее.
2 ПОСТАНОВКА ЗАДАЧИ И ПРОЕКТНОЕ РЕШЕНИЕ
.1 Постановка задачи
В рамках выполнения дипломной работы передо мной стояла задача разработки нейросетевой технологии, решающей задачу аппроксимации погодных данных на примере температуры, и веб представления, отображающего результат аппроксимации и позволяющего получить погодные данные в любой интересующей пользователя точке.
Важнейшим элементом в рамках выполнения дипломной работы стал сервис OpenWeatherMap, который выступал как поставщик данных и, вообще, стал причиной, по которой я взялся за нейросетевую аппроксимацию погодных данных.
2.2 Сервис OpenWeatherMap
OpenWeatherMap это онлайн сервис, который предоставляет бесплатное API к погодным данным, включающим текущие погодные сведения, прогнозы и историю наблюдений для разработчиков веб сервисов и мобильных приложений. В качестве источников данных он использует официальные метеорологические сервисы, данные с метеорологических станций аэропортов и официальных метеорологических станций. Также сервис предлагает различные погодные карты, такие как карта облачности или карта давления.
Сервис OpenWeatherMap получает данные от профессиональных и частных погодных станций. На сегодня таких станций более 40 тысяч. Большая часть из них это профессиональные станции, которые установлены в аэропортах и крупных городах мира. Но также не менее важным для сервиса являются данные от непрофессиональных станций, которые собирают и устанавливают любители везде, где это возможно [7].исповедует идею OpenStreetMap и Wikipedia о свободном, бесплатном предоставлении данных любому желающему, на любые нужды. OpenWeatherMap использует карты OpenStreetMap для отображения собственных погодных карт.
Основателями сервиса является команда разработчиков из России.
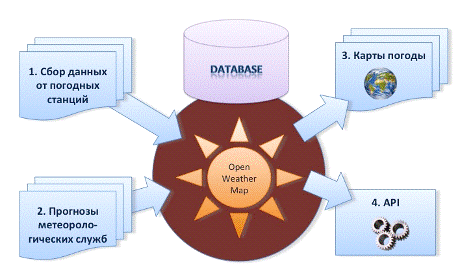
Рисунок
2.1 - Схема сервиса
Основным критерием выбора темы дипломной работы стали следующие слова разработчиков сервиса, написанные ими в обзорной статье:
«Если вам интересна математика - очень много задач вокруг этого. К примеру - одна из наиболее важных задач в системе это определение текущей погоды. Как уже говорилось выше, мы получаем оперативные данные от метеостанций, которые нужно интерполировать в сетку важных для географических точек - городов или отдельных районов. Данные от станций разнородны и поступают не регулярно. Более того, поступает много мусора из ошибочных и неверных измерений, их надо отсеивать. Причем ошибки могут появляться и в данных от вполне надежных метеостанций.
Сейчас мы используем достаточно жёсткий и не адаптивный алгоритм. Очень хотелось бы попробовать в этой задаче какой-либо обучающийся алгоритм.
Очень интересно попробовать в схожей задаче нейросеть.» [7]
2.2.1 OpenWeatherMap API
Сервис OpenWeatherMap предоставляет бесплатный API ко всем данным о погоде, к их истории, прогнозам и всему многообразию погодных карт.есть двух видов - JSON для получения данных и Tile / WMS для картографии.
Используя JSON можно получать [7]:
Данные о погоде в более чем 120 тысячах городов. При этом города не нужно выбирать из жестко ограниченного списка, их можно найти на карте и увидеть оценочные прогнозы погоды как в самом городе, так и в ближайших регионах.
Данные о текущей погоде в выбранной точке по координатам lat/lon
Прогноз на 7 дней в компактной или в полной форме
«Сырые» данные, полученные от метеостанций
Данные о погоде за прошедшие периоды
.3 Получение, обработка и нормализация исходных данных
.3.1 Получение и обработка данных
Для аппроксимации мною был выбран участок на карте с координатами 45 - 49
градусов широты, 0 - 4 градуса восточной долготы. Этот участок в центре Франции
выбран не случайно, в обзорной статье об OpenWeatherMap сказано, что «группа
французских энтузиастов развернула систему обработки данных на своих домашних
серверах и предоставляет детальные и точные прогнозы по всей территории
Франции» [7]. В то же время как по поводу России сказано следующее «давайте
посмотрим, что происходит с погодными станциями и погодным энтузиазмом в России.
На иллюстрации ниже можно увидеть текущую картину распределения погодных
станций. По сравнению с плотным покрытием всей европейской части, Россия
выглядит более чем скромно. И это одна из причин неточности прогнозов погоды на
нашей бескрайней территории.» [7]
Рисунок 2.2 - Распределение погодных станций
Так как мне были необходимы наиболее точные данные для обучения сети я остановился именно на территории государства Франция.
Было принято решение использовать историю наблюдений как источник погодных данных для обучения сети. Основная часть работы происходила с историей наблюдения за промежуток: 1 мая 2013 - 1 сентября 2013. Позднее для получения полной картины погодных явлений использовался временной промежуток: 1 мая 2013 - 1 марта 2014.
В начале выбираются 25 городов обладающих метеорологическими станциями, данные из которых будут аппроксимироваться на всю поверхность квадрата. По ним получается история наблюдения за заданный промежуток времени.
Затем получается история наблюдения по всем оставшимся городам и селениям предоставляющим такие данные. Это делается для получения наибольшего числа примеров для обучения сети.
Далее отсекается неиспользуемая информация, остаются лишь температурные данные, координаты и время наблюдения.
Температура представлена в шкале Кельвина, переводим её к шкале Цельсия.
Далее из разрозненных данных формируем примеры вида:
lat, lon, lat0, lon0, T0, lat1, lon1, T1,…, lat24,
lon24, T24  T,
где lat, lon - координаты точки, на которой будет обучаться сеть., loni, i=0,…,24 - координаты точек, относительно которых происходит аппроксимация.i, i=0,…,24 - температура в конкретный рассматриваемый момент времени в точках с координатами lati, loni.
Такому примеру соответствует значение T - температура в точке с координатами lat, lon в этот же момент времени.
В итоге получилось около 200 тысяч примеров для обучения сети, что достаточно много. К сожалению, данную выборку нельзя назвать до конца репрезентативной поскольку по некоторым городам в ней представлено информации гораздо больше чем по другим, из-за того, что сервис даёт именно такую неполную информацию. Этот недостаток ещё предстоит преодолеть.
«Можно получать данные о текущей погоде в выбранной точке по координатам lat/lon»
Но, к сожалению, эта возможность реализована довольно странно. Вместо данных в конкретной точке результат http запроса выдаёт информацию о городе находящемся наиболее близко к указанным координатам. Притом сервис обладает информацией не обо всех городах и населённых пунктах, а лишь в части из них.
Описанные выше недостатки сильно ограничивали и замедляли разработку. К примеру, если бы была информация о большем числе городов, то обучающая выборка была бы более полной, что, вполне вероятно, позволило бы лучше обучить сеть и получить лучшие результаты аппроксимации.
Также сильно помешал тот факт, что при использовании истории наблюдений я столкнулся с тем, что о каких-то городах хранится гораздо более насыщенная история наблюдений за определённый период чем о других (во много раз). Эта проблема непосредственно влияет на репрезентативность выборки. Причём если исключить города с более объёмной историей наблюдений, чтобы выровнять количество информации обо всех городах, то обучающая выборка оказывается слишком малой и, из-за этого, сеть обучается только хуже.
Пока пришлось оставить выборку с разным объёмом наблюдений о разных
городах. Такая выборка получается довольно большой, что даёт возможность сети
обучиться и показывать достаточно неплохие результаты даже на не совсем
репрезентативной выборке.
.3.3 Нормализация данных