Дипломная (вкр): Нейросетевой механизм
.3.2 Пределы ошибок аппроксимации
Были исследованы аппроксимирующие свойства многослойного персептрона для случая одного скрытого слоя с сигмоидальной функцией активации и одного выходного нейрона. Эта сеть обучалась с помощью алгоритма обратного распространения ошибки, после чего тестировалась на новых данных. Во время обучения сети предъявлялись выбранные точки аппроксимируемой функции f, в результате чего была получена аппроксимирующая функция F, определяемая выражением (2). Если сети предъявлялись не использованные ранее данные, то функция F «оценивала» новые точки целевой функции.
Гладкость
целевой функции f выражалась в терминах её разложения Фурье. В частности, в
качестве предельной амплитуды функции f использовалось среднее значение нормы
вектора частоты, взвешенного значениями амплитуды распределения Фурье. Пусть g(ω) - многомерное преобразование Фурье функции 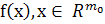 , где ω - вектор частоты. Функция f(x), представленная в
терминах преобразования Фурье g(ω),
определяется следующей инверсной формулой:
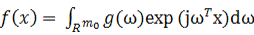 (4)
где
j =  . Для
комплекснозначной функции g(ω) с интегрируемой
функцией ωg(ω) первый
абсолютный момент распределения Фурье функции f можно
определить следующим образом:
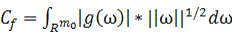 (5)
где
 -
Евклидова норма вектора ω; |g(ω )| -
абсолютное значение функции g(ω).
Первый абсолютный момент Cf является мерой гладкости функции f
[1].
Первый абсолютный момент Cf является основой для вычисления пределов ошибки, которая возникает вследствие использования многослойного персептрона, представленного функцией отображения «вход-выход» F(x), аппроксимирующей функцию f(x). Ошибка аппроксимации измеряется интегральной квадратичной ошибкой по произвольной мере вероятности µ для шара Br = {x: ||x|| ≤ r} радиуса r > 0. На этом основании можно сформулировать следующее утверждение для предела ошибки аппроксимации:
Для
любой непрерывной функции f(x) с конечным первым моментом Cf и
любого m1 ≥ 1 существует некоторая линейная комбинация
сигмоидальных функций F(x) вида (2), такая, что
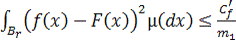 (6)
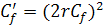 .
Если
функция f(x) наблюдается на множестве значений  входного
вектора x, принадлежащего шару Br, этот результат определяет следующее ограничение для
эмпирического риска:
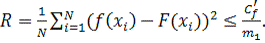 (7)
Этот
результат использовался для описания границ риска R, возникающего при
использовании многослойного персептрона с m0 входными
узлами и m1 скрытыми нейронами:
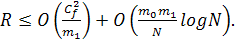 (8)
Два слагаемых в этом определении границ риска R отражают компромисс между двумя противоречивыми требованиями к размеру скрытого слоя.
Точность наилучшей аппроксимации. В соответствии с теоремой об универсальной аппроксимации для удовлетворения этого требования размер скрытого слоя m1 должен быть большим.
Точность
эмпирического соответствия аппроксимации. Для того чтобы удовлетворить этому
требованию, отношение  должно
иметь малое значение. Для фиксированного объёма N обучающего множества размер
скрытого слоя
 должен
оставаться малым, что противоречит первому требованию [1].
Ограничение для риска R, описанное формулой (8), имеет ещё одно применение. Дело в том, что для точной оценки целевой функции не требуется экспоненциально большого обучающего множества и большой размерности входного пространства m0, если первый абсолютный момент Cf остаётся конечным. Это ещё больше повышает практическую ценность многослойного персептрона, используемого в качестве универсального аппроксиматора.
Ошибку между эмпирическим соответствием и наилучшей аппроксимацией можно рассматривать как ошибку оценивания. Пусть ε - среднеквадратическое значение ошибки оценивания. Тогда, игнорируя логарифмический множитель во втором слагаемом неравенства (8), можно вделать вывод, что размер N обучающего множества, необходимый для хорошего результата аналогична эмпирическому правилу (1), если произведение m0m1 соответствует общему количеству свободных параметров W сети. Другими словами, можно утверждать, что для хорошего качества аппроксимации размер обучающего множества должен превышать отношение общего количества свободных параметров сети к среднеквадратическому значению ошибки оценивания [1].
.3.3 Ограничение размерности
Из ограничения (8) вытекает ещё один результат. Если размер скрытого слоя
выбирается по следующей формуле (т.е. риск R минимизируется по N):
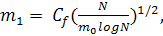 (9)
то
риск R ограничивается величиной 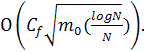 Неожиданный
аспект этого результата состоит в том, что в терминах поведения риска R
скорость сходимости, представленная как функция от размера обучающего множества
N, имеет порядок (1/N)1/2 (умноженный на логарифмический член). В то же
время обычная гладкая функция (например, тригонометрическая и полиномиальная)
демонстрирует несколько другое поведение. Пусть s - мера
гладкости, определяемая как степень дифференцируемости функции (количество
существующих производных). Тогда для обычной гладкой функции минимаксная
скорость сходимости общего риска R имеет порядок
 (10)
Зависимость этой скорости от размерности входного пространства m0 называют «проклятием размерности», поскольку это свойство ограничивает практическое использование таких функций. Таким образом, использование многослойного персептрона для решения задач аппроксимации обеспечивает определённые преимущества перед обычными гладкими функциями. Однако это преимущество появляется при условии, что первый абсолютный момент Cf остаётся конечным. В этом состоит ограничение гладкости.
Термин
«проклятие размерности» был введён Ричардом Белманом в 1961 году в работе,
посвящённой процессам адаптивного управления. Для геометрической интерпретации
этого понятия рассмотрим пример, в котором x - m0-мерный входной вектор, а
множество {(xi,di)}, i = 1,2,…,N, задаёт обучающую выборку.
Плотность дискретизации пропорциональна значению  Пусть
f(x) - поверхность в m0 - мерном входном пространстве, проходящая около точек
данных {(xi,di)}, i = 1,2,…,N. Если функция f(x)
достаточно сложна и (по большей части) абсолютно неизвестна, необходимо
уплотнить точки данных для более полного изучения поверхности. К сожалению, в
многомерном пространстве из-за «проклятия размерности» очень сложно найти
обучающую выборку с высокой плотность дискретизации. В частности, в результате
увеличения размерности наблюдается экспоненциальный рост сложности, что, в свою
очередь, приводит к ухудшению пространственных свойств случайных точек с
равномерным распределением [1].
Функция, определённая в пространстве большой размерности, скорее всего, является значительно более сложной, чем функция, определённая в пространстве меньше размерности, и эту сложность трудно разглядеть.
Единственной возможностью избежать «проклятия-размерности» является получение корректных априорных знаний о функции, определяемой данными обучения.
Можно утверждать, что для практического получения хорошей оценки в пространствах высокой размерности необходимо обеспечить возрастание гладкости неизвестной функции наряду с увеличением размерности входных данных.
.3.4 Практические соображения
Теорема об универсальной аппроксимации является очень важной с теоретической точки зрения, так как она обеспечивает необходимый математический базис для доказательства применимости сетей прямого распространения с одним скрытым слоем для решения задач аппроксимации. Без такой теоремы можно было бы безрезультатно заниматься поисками решения, которого на самом деле не существует. Однако эта теорема не конструктивна, поскольку она не обеспечивает способ нахождения многослойного персептрона, обладающего заданными свойствами аппроксимации.
Теорема об универсальной аппроксимации предполагает, что аппроксимируемая непрерывная функция известна, и для её приближения можно использовать скрытый слой неограниченного размера. В большинстве практических применений многослойного персептрона оба эти предположения нарушаются.
Проблема многослойного персептрона с одним скрытым слоем состоит в том, что нейроны могут взаимодействовать друг с другом на глобальном уровне. В сложных задачах такое взаимодействие усложняет задачу повышения качества аппроксимации в одной точке без явного ухудшения в другой. С другой стороны, при наличии двух скрытых слоёв процесс аппроксимации становится более управляемым [1]. В частности, можно утверждать следующее:
а) Локальные признаки извлекаются в первом скрытом слое, т.е. некоторые скрытые нейроны первого слоя можно использовать для разделения входного пространства на отдельные области, а остальные нейроны слоя обучать локальным признакам, характеризующим эти области.
б) Глобальные признаки извлекаются во втором скрытом слое. В частности, нейрон второго скрытого слоя «обобщает» выходные сигналы нейронов первого скрытого слоя, относящихся к конкретной области входного пространства. Таким образом он обучается глобальным признакам этой области, а в остальных областях его выходной сигнал равен нулю.
Этот двухэтапный процесс аппроксимации по своей философии аналогичен сплайновому подходу к аппроксимации кривых, поскольку нейроны работаю в изолированных областях. Сплайн является примером такой кусочной полиномиальной аппроксимации.
В трудах Эдуардо Сонтага предложено дальнейшее обоснование использования двух скрытых слоёв в контексте обратных задач. В частности, рассматривается следующая обратная задача [1]:
Для
данной непрерывной вектор-функции  ,
компактного подмножества
 , которое
содержится в пространстве образов функции f, и некоторого
положительного ε > 0 требуется найти вектор-функцию
 ,
удовлетворяющую условию ||φ(f)(u) - u|| < ε для любого u

Эта
задача относится к области обратной кинематики или динамики, где наблюдаемое
состояние x(n) системы является функцией текущих действий u(n) b
предыдущего состояния x(n-1) системы
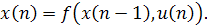 (11)
Здесь предполагается, что функция f является обратимой, т.е. u(n) можно представить как функцию от x(n) для любого x(n - 1). Функция f описывает прямую кинематику, а функция φ - обратную. В контексте излагаемого материала необходимо простроить такую функцию φ, которая может быть реализована многослойным персептроном. В общем случае для решения обратной задачи кинематики функция φ должна быть разрывной. Для решения таких обратных задач одного скрытого слоя недостаточно, даже при использовании нейронной модели с разрывными активационными функциями, а персептрона с двумя скрытыми слоями вполне достаточно для любых возможных C, f и ε.
Рассмотрим
нелинейное отображение типа «вход-выход», заданное следующим соотношением:
 (12)
где
вектор x - вход, а вектор d - выход. Векторная функция f(ю) считается
неизвестной. Чтобы восполнить пробел в знаниях о функции f(.), нам
предоставляется множество маркированных примеров:
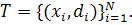 (13)
К
структуре нейронной сети, аппроксимирующей неизвестную функцию f(.),
предъявляется следующее требование: функция F(.),
описывающая отображение входного сигнала в выходной, должна быть достаточно
близка к функции f(.) в смысле Евклидовой нормы на множестве всех входных
векторов x, т.е.
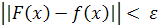 для всех
векторов x,
где
 -
некоторое малое положительное число. Если количество N элементов обучающего
множества достаточно велико и в сети имеется достаточное число свободных
параметров, то ошибку аппроксимации можно
сделать достаточно малой.
Описанная задача аппроксимации является отличным примером задачи для обучения с учителем. Здесь xi играет роль входного вектора, а di - роль желаемого отклика. Исходя из этого, задачу обучения с учителем можно свести к задаче аппроксимации [1].
Способность нейронной сети аппроксимировать неизвестное отображение входного пространства в выходное можно использовать для решения следующих задач.
а) Идентификация систем. Пусть формула (12) описывает соотношение между входом и выходом в неизвестной системе с несколькими входами и выходами без памяти. Термин «без памяти» подразумевает инвариантность системы во времени. Тогда множество маркированных примеров (13) можно использовать для обучения нейронной сети, представляющей модель этой системы. Пусть yi - выход нейронной сети, соответствующий входному вектору xi. Разность между желаемым откликом di и выходом сети yi составляет вектор сигнала ошибки ei, используемый для корректировки свободных параметров сети с целью минимизации среднеквадратической ошибки - суммы квадратов разностей между выходами неизвестной системы и нейронной сети в статистическом смысле (т.е. вычисляемой на множестве всех примеров).
Рисунок 1.3 - Блочная диаграмма решения задачи идентификации системы
б) Инверсные системы. Предположим, что существует некая система без
памяти, для которой преобразование входного пространства в выходное описывается
соотношением (12). Требуется построить инверсную систему, которая в ответ на
вектор d генерирует отклик в виде вектора x.
Инверсную систему можно описать следующим образом: