Материал: Панков Пособие по ТВиМС часть 2

При заданной по этой формуле, |
меняя приближенное равенство на |
|||||||||||
обычное, вычисляют конкретное значение C : |
|
|
||||||||||
C N2 |
1;1 , |
|
|
|
|
|
|
|
|
|
|
|
т. е. C - квантиль хи-квадрат распределения с N 1 степенями свободы уровня |
||||||||||||
1 , |
|
|
|
|
|
|
|
|
|
|
|
|
Отметим, что так как |
|
- сложная гипотеза, то вычислить ошибку второго |
||||||||||
H0 |
||||||||||||
рода |
P H0 |
| |
|
очень трудно. |
|
|
|
|
|
|||
H0 |
|
|
|
|
|
|||||||
2). |
Пусть |
x1,...,xn – выборка |
из |
дискретной случайной величины, |
||||||||
принимающей счетное число значений: |
|
|
|
|
||||||||
|
|
|
|
|
|
|
|
...yN 1 yN |
|
|||
|
|
|
|
|
|
|
y1 |
... |
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
p |
|
. |
|
|
|
|
|
|
|
p ...p |
N 1 |
N |
... |
||
|
|
|
|
|
|
|
1 |
|
|
|
||
Основная гипотеза имеет вид:
H0 : p1,...,pN 1,pN ,... p10 ,...,pN0 1,pN0 ,... .
Данный случай сводят к предыдущему с помощью следующего приема. Будем считать, что x1,...,xn – выборка из полиномиальной случайной
величины следующего вида:
|
|
|
|
|
|
|
|
|
|
|
' |
...y |
' |
y |
' |
|
|
|
|
|
|
|
|
|
|
|
y |
1 |
N 1 |
N |
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
' |
|
' |
|
' |
, |
|
|
|
|
|
|
|
|
|
|
|
...p |
p |
|
|||
|
|
|
|
|
|
|
|
|
|
p |
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
1 |
|
N 1 |
|
N |
|
где для всех j |
|
выполняется yj' |
yj и pj' |
pj , и |
||||||||||||
1,N 1 |
||||||||||||||||
|
|
|
|
|
|
|
|
yN' yN ,yN 1,yN 2,... , |
|
|
|
|||||
|
|
|
|
|
|
|
|
pN' pN k . |
||||||||
Тогда H0 имеет вид |
|
|
|
|
|
|
|
|
k 0 |
|||||||
|
|
|
|
|
|
|
|
|
||||||||
|
|
|
|
|
|
(p1(0)',...,pN(0)'1,pN(0)'), |
|
|||||||||
H0 : |
p ' p1' ,...,pN' |
1,pN' |
p0' |
|
||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
где для всех j 1,N 1 выполняется p(0)'j |
p(0)j |
, а pN(0)' pN(0) k . |
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
k 0 |
3). Пусть – |
абсолютно непрерывная |
случайная величина с функцией |
||||||||||||||
распределения F x . |
|
|
|
|
|
|
|
|
|
|
|
|||||
К примеру, N |
|
0,1 . |
|
|
|
|
|
|
|
|
||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
Основная гипотеза имеет в этом случае вид: |
|
|||||||||||||||
|
|
|
|
|
|
|
|
|
|
H0 : F (x) F0(x), |
||||||
где F0 x - некоторая фиксированная функция распределения.
Разобьем область значений случайной величины на N непересекающихся подмножеств S1,...,SN . Если xi Sk , то говорят, что произошло событие Ek , для всех k 1,N .
36
n |
xi |
Sk |
|
|
|
|
||||
Обозначим через hk Ind |
количество |
событий EK в выборке, |
||||||||
i 1 |
|
|
|
|
|
|
|
|
||
N |
|
|
|
|
|
|
|
|
||
hk n . |
|
|
|
|
|
|
|
|
||
k 1 |
|
|
|
|
|
|
|
|
||
Обозначим pk(0) P SK | H0 , |
и будем считать, |
что производится выборка |
||||||||
из дискретной случайной величины: |
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
E1 |
...EN |
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
... p |
. |
|
|||
|
|
|
|
|
|
p |
|
|
||
|
|
|
|
|
|
1 |
|
|
N |
|
Основная гипотеза имеет вид: |
|
|
|
|
|
|
p1(0),...,pN(0) . |
|||
H0 : |
|
p1,...,pN |
|
|||||||
p |
p0 |
|||||||||
И мы сводим ситуацию опять к первому случаю.
Метод, который мы применили во втором и в третьем случае, можно назвать
методом группировки данных.
Пример. При n 4040 бросаниях монеты Бюффон получил h1 2048
выпадений герба и h2 n h1 1992 выпадений решетки. Проверим, используя критерий 2 , совместимы ли эти данные с гипотезой H0 о том, что монета была симметрична, т. е. что вероятность выпадения герба p 1/ 2. Здесь
N 2 ,
p1(0) 1/ 2 p , p2(0) 1 p 1/ 2 ,
|
2 |
|
h1 пр 2 |
h2 |
п 1 р 2 |
|
|
|||
|
|
|
|
п 1 |
р |
|
|
|
||
|
|
|
пр |
|
|
|
|
|
||
|
|
|
|
|
|
2048 2020 2 |
1992 2020 2 |
0,776 . |
||
|
|
|
|
|
|
|
|
2020 |
2020 |
|
Пусть уровень значимости критерия 0,05. |
|
|||||||||
Тогда C 2 |
|
2 |
3,841. |
|
|
|||||
|
|
|
N 1;1 |
|
1;0,95 |
|
|
|
|
|
Сравним значение статистики 2 |
и величину C . Так как X2 C , то данные |
|||||||||
не противоречат гипотезе.
Критерий однородности хи-квадрат
Одной из важных прикладных задач математической статистики является задача проверки однородности статистического материала. Пусть имеются две независимые выборки, описывающие один и тот же процесс, явление и так далее, но полученные в разное время или, вообще говоря, в разных условиях. Требуется установить, являются ли они выборками из одного и того же распределения, или же закон распределения от выборки к выборке меняется. Такая задача может возникнуть, к примеру, при контроле качества некоторой продукции, когда по контрольным выборкам из различных партий требуется
37
установить, не менялось ли ее качество от смены к смене или в результате изменения технологического процесса и так далее.
В таком виде задачу можно сформулировать следующим образом:
Пусть x1,...,xn - выборка из случайной величины с некоторой функцией распределения F x , y1,...,yn - выборка из случайной величины с некоторой функцией распределения F (x).
Требуется проверить гипотезу однородности:
H0 :F (x) F (x).
Часто применяемым в такой ситуации критерием является критерий однородности хи-квадрат 2 . Его используют для проверки однородности
данных, имеющих конечную дискретную структуру. Но к этому виду можно свести любую другую модель, как мы показали выше, применяя предварительно метод группировки данных. Поэтому метод 2 применим, на самом деле, к анализу любых данных, т. е. является в этом смысле универсальным. Кроме того, с помощью этого метода можно анализировать
любое конечное число выборок. |
|
|
Предположим, что существует S последовательных |
серий |
независимых |
наблюдений x1,1,...,xn1,1 , …, x1,S ,...,xnS ,S , состоящих из |
n1, ,nS |
наблюдений |
соответственно. При этом в каждом из них наблюдалась величина, принимающая одно из N значений: E1, ,EN .
|
Т. е. выборка |
x1,1,...,xn1,1 |
производилась из случайной величины |
|||||||||||
|
|
... EN |
|
|
|
|
|
|
|
|||||
|
E1 |
|
|
|
E1 ... |
EN |
||||||||
1 |
|
|
|
|
|
|
|
|
|
|||||
|
...p |
,…, x1,S ,...,xnS ,S |
– из S |
...p |
. |
|||||||||
|
p |
|
|
|
p |
|
||||||||
|
1,1 |
N,1 |
|
|
|
1,s |
|
|
N,S |
|||||
|
Основная гипотеза имеет в этом случае вид: |
|||||||||||||
|
|
|
|
H0 : pj,1 ... pj,S для всех j |
|
, |
|
|
||||||
|
|
|
|
1,N |
||||||||||
Или, как можно переформулировать, |
|
|
|
|
|
|
|
|||||||
|
|
|
H0 : pj,i pj |
для всех j |
|
|
и для всех i |
|
. |
|||||
|
|
|
1,N |
|
1,S |
|||||||||
|
|
|
n |
Ind xk,i |
Ej |
|
|
|
|
|
|
|
|
|
|
Обозначим hj,i i |
– количество исходов Ej в i-й выборке. |
||||||||||||
|
|
|
k 1 |
|
|
|
|
|
|
|
|
|
|
|
|
Если бы мы использовали ту же статистику, что и в предыдущей подтеме, то |
|||||||||||||
мы получили бы для каждой выборки статистику |
||||||||||||||
|
2 |
N hj,i nipj,i 2 |
N hj,i nipj 2 |
|
|
|
|
|
|
|
||||
|
i |
|
nipj,i |
|
nipj |
|
|
|
|
|
|
|
|
|
|
|
j 1 |
j 1 |
|
|
|
|
|
|
|
|
|
||
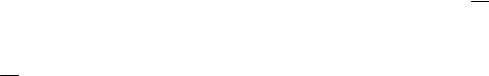
Но здесь возникает проблема: мы не знаем pj,i pj - они нам не даны
изначально. Значит, вместо них следует использовать какие-то оценки. Используем в статистике вместо pj оценку
38
|
|
|
|
|
|
|
|
|
S |
S |
1 |
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
* |
|
|
|
|
|
|
|
|
|
|
|
|
pj hj,i |
ni |
|
|
|||
|
|
|
|
|
|
. |
|
|||||
|
|
|
|
|
|
|
|
|
i 1 |
|
|
|
|
|
|
|
|
|
|
|
|
i 1 |
|
|
|
Обозначим |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
2* |
S |
|
2 |
S |
N hj,i nipj* 2 |
. |
|
|
|
|
|
|
i |
|
* |
|||||
|
|
|
|
|
|
i 1 |
|
i 1 |
j 1 |
nipj |
|
|
Теорема (без доказательства). Если верна гипотеза |
H0 , то |
|||||||||||
2* D 2 |
|
2 |
|
|
, |
|
|
|
|
|
||
n |
|
|
NS N S 1 |
|
|
|
|
|
|
|||
|
N 1 S 1 |
|
|
|
|
|
|
|||||
т. е. статистика 2* |
|
сходится по распределению к хи-квадрат распределению, |
||||||||||
число степеней свободы которого равно NS N S 1. Сформулируем критерий однородности выборок хи-квадрат:
-если статистика 2* C , то принимаем гипотезу H0 ;
-если статистика 2* C , то отвергаем гипотезу H0 (принимаем H0 ).
Уровень значимости , также как и в случае критерия согласия хи-квадрат, задает конкретное значение C :
P H0 | H0 P 2* C | H0
|
|
|
|
|
|
|
|
|
|
|
1 P |
|
2* |
C | H |
0 |
1 F 2 |
C |
. |
|
|
|
|
|
|
|
|
|
|
||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
N 1 S 1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
Отсюда принимаем C 2 |
|
|
|
. |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
N 1 S 1 ;1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
Критерий независимости хи-квадрат |
|
|
|
|
|
|
|
|
|
|
||||||||||||||||
|
Пусть в эксперименте наблюдается двумерная случайная величина |
|
1, 2 |
|||||||||||||||||||||||||||||||||
|
|
|||||||||||||||||||||||||||||||||||
с |
неизвестной |
|
функцией |
распределения |
F 1, 2 (x,y), и |
|
имеется основание |
|||||||||||||||||||||||||||||
предполагать, что компоненты 1 |
|
и 2 независимы. В |
этом |
случае |
|
надо |
||||||||||||||||||||||||||||||
проверить гипотезу независимости |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||
|
H0 : F , |
|
x,y F x F |
y , |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||
|
|
|
1 |
2 |
|
|
|
|
1 |
|
2 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
где F x |
и |
F |
y |
- некоторые одномерные функции распределения. |
|
|
|
|
|
|
||||||||||||||||||||||||||
|
|
1 |
|
|
|
|
2 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Простой критерий согласия для гипотезы H0 |
можно построить, основываясь |
||||||||||||||||||||||||||||||||||
на методике хи-квадрат. |
|
|
|
|
|
|
|
x1,y1 , x2,y2 ,..., xn,yn |
|
|
|
|
|
|
|
|
|
|
||||||||||||||||||
|
Будем считать, что выборка |
|
производится |
|
из |
|||||||||||||||||||||||||||||||
двумерной |
|
|
случайной |
величины |
|
|
1, 2 , |
где |
случайная |
величина |
|
|
1 |
|||||||||||||||||||||||
|
|
|
|
|
||||||||||||||||||||||||||||||||
принимает конечное число - |
S - некоторых значений a1,...,aS , а 2 |
- N значений |
||||||||||||||||||||||||||||||||||
b1,...,bN . |
Эти |
значения |
обычно |
называют |
признаками. |
Обозначим |
|
через |
||||||||||||||||||||||||||||
|
|
n |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
h |
|
|
Ind |
x |
,y |
|
a |
,b |
число появлений в выборке пары признаков |
|
,b |
|
. |
|||||||||||||||||||||||
|
|
|
k |
|
a |
j |
|
|||||||||||||||||||||||||||||
i,j |
|
|
|
|
|
|
k |
|
i |
j |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
i |
|
|
|
|||
k 1
39
S |
N |
|
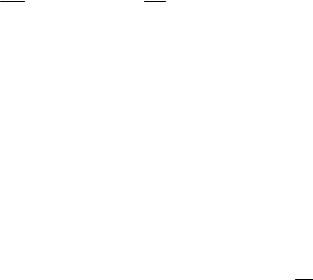
Очевидно, что hi,j |
n , где n - объем выборки. Результаты наблюдений |
|
i 1 |
j 1 |
|
удобно располагать в виде таблицы сопряженности двух признаков:
|
|
|
|
|
|
|
Сумма |
|
|
b1 |
… |
bj |
… |
bN |
по |
|
|
|
|
|
|
|
строке: |
|
a1 |
h1,1 |
… |
h1,j |
… |
h1,N |
h1,0 |
|
… |
… |
… |
… |
… |
… |
… |
|
ai |
hi,1 |
… |
hi,j |
… |
hi,N |
hi,0 |
|
… |
… |
… |
… |
… |
… |
… |
|
aS |
hS,1 |
… |
hS,j |
… |
hS,N |
hS,0 |
|
Сумма |
|
|
|
|
|
|
|
по |
h0,1 |
… |
h0,j |
… |
h0,N |
n |
|
столбцу: |
|
|
|
|
|
|
Обозначим: |
|
|
|
|
|
|
|
pi,j - вероятность появления пары признаков ai,bj , pi,0 - вероятность появления признака ai ,
p0,j - вероятность появления признака bj .
Основная гипотеза имеет в этом случае вид:
H0 : pi,j pi,0p0,j для всех j 1,N и для всех i 1,S .
Как и в предыдущей подтеме, при построении статистики воспользуемся вместо неизвестных вероятностей их оценками.
Рассмотрим статистику:
2 |
S N |
hi,j npi*,opo*,j 2 |
|
* |
|
hi,0 |
* |
|
h0,j |
|
|||||
|
|
|
|
* |
* |
|
, |
где pi,o |
|
|
, po,j |
|
|
. |
|
|
|
|
n |
n |
|||||||||||
|
i 1 j 1 |
|
|
npi,opo,j |
|
|
|
|
|
|
|
||||
Теорема (без доказательства). Если верна гипотеза H0 , то |
|||||||||||||||
2 |
D |
|
2 |
|
|
|
2 |
|
. |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
n |
|
|
NS |
N S 1 |
|
|
|
|
|
|
|
|||
|
|
N 1 S |
1 |
|
|
|
|
|
|
|
|
||||
Сформулируем критерий независимости признаков хи-квадрат:
- если статистика 2 , то принимаем гипотезу ;
C H0
- если статистика 2 , то отвергаем гипотезу (принимаем ).
C H0 H0
Также, как и в случае предыдущих критериев, ошибка первого рода, или уровень значимости , задает конкретное значение C :
|
|
|
|
2 |
C | H0 |
|
|
|
|
|
|
|
P H |
0 | H |
|
|
|
|
|
|
|||||
0 P |
|
|
|
|
|
|
||||||
|
|
|
|
|
1 P |
2 |
C | H |
|
1 F 2 |
C |
. |
|
|
|
|
|
|
|
|
||||||
|
|
|
|
|
|
|
|
0 |
N 1 S 1 |
|
|
|
Поэтому принимаем:
40