Материал: Передача дискретных сообщений. Тихомиров Н.М
Поэтому расстояние Хемминга d=2. Иначе его определяют как вес суммы по модулю два ( - условное обозначение суммы) этих кодовых комбинаций. Весом W кодовой комбинации называется число входящих в нее ненулевых элементов.
Перебрав все возможные пары кодовых комбинаций, можно найти минимальное значение d, которое буем обозначать в дальнейшем d0 и называть кодовым расстоянием. Для примера 2.1 кодовое расстояние d0=1. Рассмотренный в примере код является простым. Любая ошибка (даже одиночная!) при использовании такого кода приведет к тому, что переданная разрешенная кодовая комбинация перейдет в другую разрешенную кодовую комбинацию. Таким образом, простой код не способен обнаруживать и тем более исправлять ошибки и имеет d0=1.
Для того чтобы код мог обнаруживать ошибки, необходимо соблюдение неравенства Na<N0. При этом неиспользуемые n-элементные кодовые комбинации, число которых (N0-Na), будем называть запрещенными. Они определяют избыточность кода. Очевидно, что появление ошибки в кодовой комбинации будет обнаружено, если переданная разрешенная комбинация перейдет в одну из запрещенных. В качестве Nр=Na разрешенных кодовых комбинаций надо выбирать такие, которые максимально отличаются друг от друга.
Пример 2.2. Алфавит передаваемых сообщений Na=2. Выберем из числа комбинаций, представленных в табл. 2.1, две. Очевидно, что ими должны быть комбинации 000, 111 или 001,110 и т.д. Кодовое расстояние d0=3. Ошибки кратности один или два превращают любую разрешенную кодовую комбинацию в запрещенную. Следовательно, максимальная кратность обнаруживаемых таким образом ошибок равна двум (tо.ош=2).
Нетрудно догадаться, что минимальное кодовое расстояние d0 и гарантированно обнаруживаемая кратность ошибок связаны соотношением tо.ош= d0 - 1.
Исправление ошибок возможно также только в том случае, если переданная разрешенная кодовая комбинация переходит в запрещенную. Вывод о том, какая кодовая комбинация передавалась, делается на основании сравнения принятой запрещенной комбинации со всеми разрешенными. Принятая комбинация отождествляется с той из разрешенных, на которую она больше всего похожа, т.е. с той, от которой она отличается меньшим числом элементов. Такое декодирование называется декодированием по методу максимального правдоподобия. Так, если в примере 2.2 при передаче кодовой комбинации 000 получаем 001, то вынесем решение, что передавалась кодовая комбинация 000.
Связь между d0 и кратностью исправляемых ошибок определяется выражением tи.ош= (d0/2 - 1) для четного d0 и tи.ош= (d0 - 1)/2 для нечетного d0.
Итак, задача получения кода с заданной корректирующей способностью сводится к задаче выбора (путем перебора) из N0=2n кодовых комбинаций Na комбинаций с требуемым кодовым расстоянием d0. Если n достаточно мало, то такой перебор не представляет особого труда. При больших n перебор может оказаться непосильным даже для современной ЭВМ, поэтому на практике используют методы построения кодов, не требующие перебора с целью получения кода с заданным d0 и отличающиеся невысокой сложностью реализации.
2.3. Классификация корректирующих кодов
Помехоустойчивые или корректирующие коды делятся на блочные и непрерывные. К блочным относятся коды, в которых каждому символу алфавита сообщений соответствует блок (кодовая комбинация) из n(i) элементов, где i - номер сообщения. Если n(i)=n, т.е. длина блока постоянна и не зависит от номера сообщения, то код называется равномерным. Такие коды чаще применяются на практике. Если длина блока зависит от номера сообщения, то блочный код называется неравномерным. В непрерывных кодах передаваемая информационная последовательность не разделяется на блоки, а проверочные элементы размещаются в определенном порядке между информационными. Проверочные элементы в отличие от информационных, относящихся к исходной последовательности, служат для обнаружения и исправления ошибок и формируются по определенным правилам.
Равномерные блочные коды делятся на разделимые и неразделимые. В разделимых кодах элементы разделяются на информационные и проверочные, занимающие определенные места в кодовой комбинации. В неразделимых кодах отсутствует деление элементов кодовых комбинаций на информационные и проверочные. Примером такого кода является семиэлементный телеграфный код №3 с весом каждой кодовой комбинации, равным трем. Этот код может служить только для обнаружения ошибок на основании изменения веса.
Разделимые коды делятся на систематические или линейные и несистематические или нелинейные. Линейные коды получили свое название потому, что их проверочные элементы представляют линейные комбинации информационных элементов. Большую и важную подгруппу линейных кодов образуют циклические коды. Линейные коды реализуются наиболее просто, что привело к их широкому использованию в УЗО. Для линейного кода применяется обозначение (n, k) - код, где n - число элементов в комбинации; k - число информационных элементов. Нелинейные коды характеризуются наличием двух или более систем проверок внутри каждой кодовой комбинации. Наиболее часто используются проверки на чётность числа единиц и нулей в разрешенных кодовых комбинациях.
2.4. Линейные коды
Пусть имеется разрешенная кодовая комбинация a1 a2 ... ak b1 b2 ... br линейного (n, k) - кода, где a1 ... ak - множество информационных элементов; b1 ... br - множество проверочных элементов. Как уже указывалось выше, в линейных кодах проверочные элементы являются линейной комбинацией информационных. Значение любого проверочного разряда
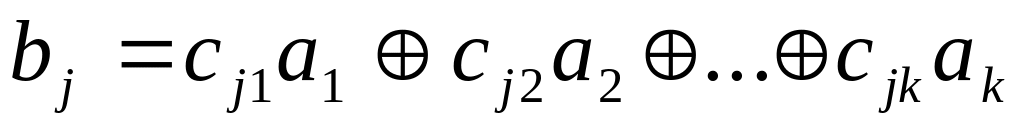 .
Коэффициенты cji принимают значения 0 или 1. Таким образом линейный код полностью определяется r k коэффициентами cji ( j=1,2,...,r, i=1,2,...,k).
При
построении линейных кодов все разрешенные
кодовые комбинации могут быть найдены
по нескольким исходным комбинациям,
которые записываются в виде производящей
матрицы Gn,k
, левая
часть которой представляет единичную
матрицу Ik
исходного простого кода, а правая Br,k
- матрицу проверочных элементов.
Размерность такой матрицы n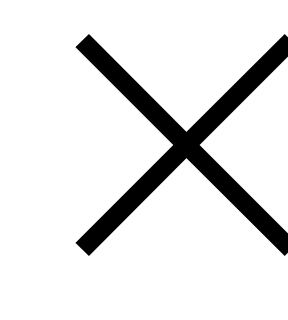 k,
т.е.
G
n,k
=
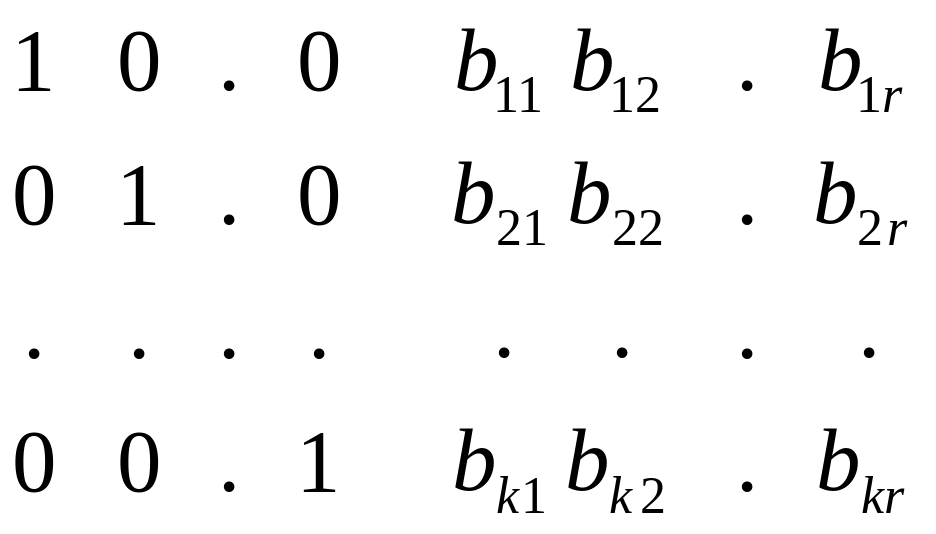 .
Сокращенно производящую матрицу записывают в виде
Gn,k=| Ik Br,k |.
Минимальный вес разрешенных кодовых комбинаций должен быть не меньше d0. Так как вес каждой строки единичной матрицы W=1, вес каждой строки матрицы проверочных элементов должен быть не меньше d0 - 1, а вес суммы по модулю два двух любых ее строк - не меньше d0 - 2.
Пример 2.3. Построить производящую матрицу линейного кода с d0=3 и k=4.
Пользуясь
условием, что при d0=3
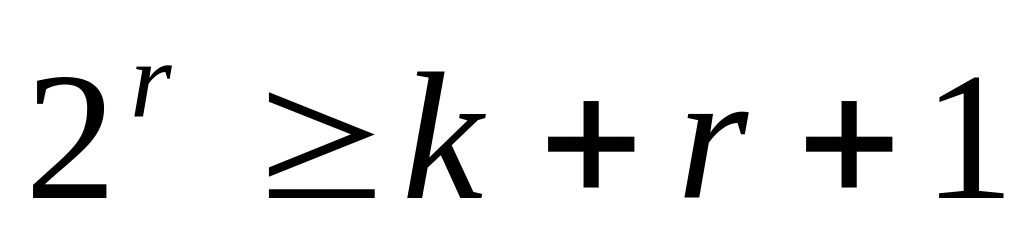 ,
находим r=3
и n=k+r=7.
Запишем все возможные строки матрицы
Br,k
в порядке возрастания соответствующих
двоичных чисел: 000; 001; 010; 011; 100; 101; 110; 111.
Из этих восьми чисел отберем только те,
которые удовлетворяют перечисленным
выше условиям для матрицы Br,k
.
В каждой строке не менее d0 - 1 единиц: d0 – 1 = 2. Этому условию удовлетворяют комбинации: 011, 101, 110, 111.
Сумма двух любых строк по модулю два должна иметь не меньше d0 - 2 единиц: d0 – 2 = 1. Легко убедиться, что выбранные комбинации удовлетворяют этому требованию, например,
|
0 |
1 |
1 |
|
|
1 |
0 |
1 |
|
|
0 |
1 |
1 |
|
|
|
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||
|
1 |
1 |
0 |
|
|
1 |
1 |
1 |
|
|
1 |
0 |
1 |
|
и т.д. |
|
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||
|
1 |
0 |
1 |
, |
|
0 |
1 |
0 |
, |
|
1 |
1 |
0 |
|
|
|
||||||||||||||
Э
.
.
.
-
B3,4=
0
1
1
.
1
0
1
1
1
0
1
1
1
b1
b2
b3
Объединяя I4 и B3,4 , получим производящую матрицу линейного кода (7,4):
|
1 |
0 |
0 |
0 |
0 |
1 |
1 |
.
G7,4=
. |
0 |
1 |
0 |
0 |
1 |
0 |
1 |
|
0 |
0 |
1 |
0 |
1 |
1 |
0 |
|
0 |
0 |
0 |
1 |
1 |
1 |
1 |
|
a1 |
a2 |
a3 |
a4 |
b1 |
b2 |
b3 |
Общее число кодовых комбинаций N0=2n=27=128, из них разрешенных Na=2k=24=16. Четыре из них являются строками производящей матрицы, пятая - нулевая, а остальные одиннадцать находятся суммированием по модулю два различных строк производящей матрицы G7,4.
В свою очередь, по матрице Br,k можно определить правила формирования проверочных элементов. Единица в первой строке каждого столбца указывает на то, что в образовании соответствующего столбцу проверочного элемента участвовал первый информационный элемент. Единица в следующей строке любого столбца говорит об участии в образовании проверочного элемента второго информационного элемента и т.д.
Найдем проверочные элементы, пользуясь матрицей проверочных элементов B3,4. Согласно приведенным выше правилам
b1=a2 a3 a4 ,
b2=a1 a3 a4 , (2.1)
b3=a1 a2 a4 .
Процедура обнаружения ошибок основана на использовании проверок (2.1). Очевидно, что проверочные элементы, сформированные из принятых информационных, при отсутствии ошибок должны совпадать с принятыми проверочными.
Пример 2.4. Переданная кодовая комбинация имеет вид 1000011 (первая строка матрицы G7,4). В результате действия помех на приемном конце имеем a1’, a2’, a3’, a4’, b1’, b2’, b3’=1100011. Произведем проверки (2.1):
a2’ a3’ a4’=1 0 0=1=b1* ,
a1’ a3’ a4’=1 0 0=1=b2* ,
a1’ a2’ a4’=1 1 0=0=b3* .
В
то же время b1’=0,
b2’=1,
b3’=1,
т.е. b1*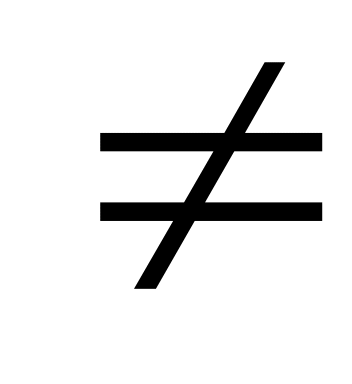 b1’
, b3*
b3’
, что говорит о наличии ошибок в принятой
кодовой комбинации. При отсутствии в
принятой кодовой комбинации ошибок
b1*
b1’=c1=0,
b2*
b2’=c2=0,
b3*
b3’=c3=0.
Комбинация с1 с2 с3 называется синдромом (проверочным вектором). Равенство нулю всех элементов синдрома указывает на отсутствие ошибок, или на то, что кодовая комбинация принята с ошибками, которые превратили ее в другую разрешенную. Последнее событие имеет существенно меньшую вероятность, чем первое.
Вид ненулевого синдрома определяется характером ошибок в кодовой комбинации. По конкретному виду синдрома можно в пределах корректирующей способности кода указать на ошибочные элементы и их исправить.
Рассмотренный код (7,4) гарантированно обнаруживает двухкратные ошибки, а исправляет только однократные. Матрица проверочных элементов B3,4 представляет собой набор синдромов - опознавателей одиночных ошибок. Первый синдром соответствует искажению элемента a1, второй - a2, третий - a3, четвертый - a4.