Материал: Портянкин И. Swing
500 |
ГЛАВА 16 |
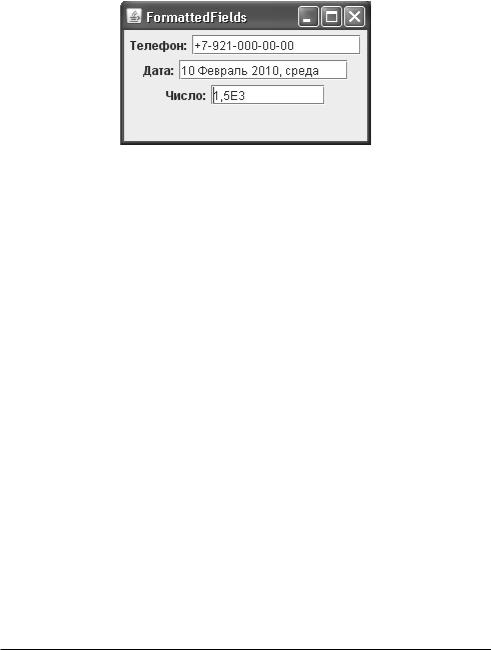
После настройки всех трех текстовых полей JFormattedTextField они добавляются в окно с последовательным расположением FlowLayout. Каждое поле снабжается небольшой поясняющей надписью. Запустив программу с примером, вы увидите поле JFormattedTextField в действии и сможете оценить достоинства и недостатки ввода ограниченных данных. Поле, действующее на основе маски, наиболее удобно и интуитивно понятно для пользователя, поле для ввода чисел также довольно удобно, хотя неожиданная смена записи числа, введенного в обычной форме, на запись экспоненциальную, иногда может быть некстати, и об этом пользователя стоит предупреждать. А вот поле для ввода дат действует не лучшим образом: если ввести новую дату или год еще возможно, то название месяца или дня недели поменять одним символом нельзя. К тому же при изменении дат или года любое случайно введенное значение может привести к скачкам на десятки месяцев, а то и лет. Так что для ввода дат гораздо лучше применять уже изученные нами в главе 12 счетчики JSpinner. Как мы помним, для вывода дат они применяют именно поля JFormattedTextField, так что вместо самостоятельной настройки поля JFormattedTextField для вывода даты вы сможете настроить поле счетчика, а для выбора собственно даты применить сам счетчик. Еще лучше для выбора дат использовать отдельные всплывающие окна. Ну а самым удобным и полезным (и к тому же простым) форматирующим объектом без сомнения является MaskFormatter.
Модель документа Document
Как и у всех достаточно сложных компонентов библиотеки Swing, у текстовых компонентов есть модель. Именно в модели хранятся данные, отображаемые текстовыми компонентами; нетрудно догадаться, что в качестве данных выступает текст, набранный пользователем или вставленный программно. Модель всех текстовых компонентов описывается не слишком сложным интерфейсом Document из пакета javax.swing.text. Поддержка интерфейса Document встроена в базовый класс всех текстовых компонентов JTextComponent библиотеки Swing, так что во всех текстовых компонентах вы сможете манипулировать данными посредством модели или менять саму модель (модель хранится в свойстве document). Для манипуляции текстом применяются несколько методов интерфейса Document, перечисленных в табл. 16.4.
Таблица 16.4. Методы модели Document, служащие для манипуляции текстом
Метод |
Описание |
getText(позиция, длина) |
Позволяет получить фрагмент текста, заданный начальной позицией |
|
и длиной. Позиция должна быть не меньше нуля и не больше длины тек- |
|
ста, иначе возникнет исключение. Длина получаемого фрагмента также не |
|
должна выходить за пределы документа |
Текстовые компоненты |
501 |
Таблица 16.4 (продолжение)
Метод |
Описание |
insertString(позиция, |
Вставляет на произвольную позицию документа текст, который к тому же |
текст, атрибуты) |
может быть снабжен набором некоторых атрибутов (о них чуть позже). По- |
|
зиция должна укладываться в пределы имеющегося текста. Именно этот |
|
метод вызывается при любых дополнениях в текстовом документе, так что |
|
его можно использовать для анализа и модификации текста перед тем как |
|
он попадет в текстовый компонент |
remove(позиция, |
Удаляет из документа фрагмент текста, заданный позицией и длиной. По- |
длина) |
зиция и длина фрагмента должны укладываться в пределы текста |
getLength() |
Позволяет получить длину текста, хранимого в данный момент в модели |
|
документа |
Модель документа Document не только хранит простой текст, но и позволяет сопоставлять ему наборы атрибутов AttributeSet (к атрибутам текста относится, например, шрифт и размер шрифта, цвет текста и т. п.). Каким образом атрибуты текста хранятся и задействуются в модели документа, зависит исключительно от ее реализации. Например, модель, используемая в текстовых полях, не сохраняет эти атрибуты, так что весь текст прорисовывается в едином виде. Модель, применяемая в редакторе JTextPane, напротив, тщательно сохраняет атрибуты текста и позволяет выводить текст в различном начертании.
Помимо текста и назначенных ему атрибутов модель Document позволяет определять, как текст распределен по элементам. Элемент документа, который может содержать произвольный фрагмент текста, размеченный различными атрибутами, описывает какуюто единую логическую единицу текста, например, абзац, маркированный список или таблицу. Таким образом, элементы документа, представленные интерфейсом Element, позволяют описывать структуру текста. Элементы могут находиться в иерархии. В простых текстовых полях элементами являются строки текста, в сложных редакторах — абзацы, находящиеся в отношениях «родитель-потомок». Методы, предназначенные для получения корневых элементов модели, перечислены в табл. 16.5.
Таблица 16.5. Методы модели Document для получения элементов документа
Метод Описание
getDefaultRootEleВозвращает основной корневой элемент документа. С его помощью можment() но получить элементы, являющеюся потомками данного элемента, и та-
ким образом полностью раскрыть структуру документа. Основной корне-
вой элемент обычно вмещает в себя весь текст документа
getRootElements() Позволяет получить массив корневых элементов документа. Как правило,
корневой элемент в документе один (именно он возвращается предыду-
щим методом), так что массив будет состоять из одного элемента. Впро-
чем, иногда документ предполагает наличие нескольких корневых элементов для специализированных целей, для таких случаев и предназначен
данный метод
Для того чтобы вид (текстовый компонент) смог вовремя узнавать об изменениях в тексте или структуре модели документа Document и перерисовать себя для отображения этих изменений, необходим механизм оповещения об изменениях. Данный механизм реализуется событием DocumentEvent и его слушателем DocumentListener, которого вы сможете присоединить к модели Document. Событие DocumentEvent запускается каж-
502 |
ГЛАВА 16 |
дый раз при изменении текста документа, именно его следует обрабатывать, если вы заинтересованы в отслеживании каждого изменения текста. В интерфейсе слушателя DocumentListener определены три метода; каждый из них вызывается при конкретном типе события в документе: удалении, обновлении или вставке текста.
Все модели документов, применяемые различными текстовыми компонентами Swing, унаследованы от базового класса AbstractDocument, реализующего механизм обновления текста, безопасный с точки зрения работы нескольких потоков. Достигается это использованием в классе внутренней синхронизации при изменении и чтении текста. Проще говоря, это означает, что вы можете получать текст документа или изменять его из любого потока выполнения, даже если это не поток рассылки событий EventDispatchThread. Тем самым и отличается работа с текстовыми компонентами от работы с остальными компонентами Swing: если для основной массы компонентов Swing действует правило «одного потока» (все действия с компонентом должны выполняться из потока рассылки событий, мы обсудили данное правило в главе 3), то текстовые компоненты (точнее, операции с хранимым в них текстом) освобождены от него. Сделано это не случайно: работа с текстом почти всегда подразумевает, во-первых, загрузку текста из различных источников данных. Загрузка может занимать много времени, особенно если текст велик, а пользователю зачастую хочется сразу видеть, что же он загружает. Благодаря механизму синхронизации класса AbstractDocument загрузку можно проводить из отдельного потока, и пользователь будет видеть текст уже в процессе загрузки. Вовторых, текст довольно часто приходится анализировать непосредственно во время его набора пользователем, например чтобы вывести подсказки для пользователя или провести автоматическое форматирование. Без поддержки синхронизации в текстовых компонентах проводить такой анализ было бы практически невозможно.
Модели для разнообразных компонентов Swing очень часто приходится создавать и программистам-клиентам (с точки зрения таких программистов мы и рассматриваем библиотеку), реализуя соответствующие интерфейсы и описывая данные в нескольких методах этих интерфейсов. Поставляемые со Swing стандартные модели применяются реже, хотя и требуют меньше усилий. Текстовые компоненты и здесь отличаются от своих собратьев. Модель документа Document не так сложна, чтобы ее нельзя было реализовать самому, однако поддержка этой модели, создание подходящей структуры элементов и ее отображение могут потребовать многих нетривиальных действий. Поэтому обработка текста обычно сводится к работе со стандартными моделями и фабриками классов — они достаточно гибкие, чтобы обеспечить программиста нужной информацией о документе и тексте, и поддерживают большую часть необходимых операций.
Текстовое поле с автоматическим заполнением
Используем полученные только что знания о модели документа Document для реализации эффектного участника пользовательских интерфейсов — текстового поля с автоматическим заполнением. Такое текстовое поле следит за изменениями в своем тексте и постоянно анализирует их, определяя, когда пользователь набирает некоторую ключевую комбинацию. Когда такая комбинация обнаруживается, поле предлагает завершить ее автоматически, подставляя в документ соответствующий текст и выделяя его. Пользователь решает, подходит ли ему предлагаемый вариант.
В текстовых полях по умолчанию применяется стандартная упрощенная модель документа под названием PlainDocument. Логично унаследовать от нее и переопределить метод, в который приходит любой новый текст, и в нем, прежде чем действительно добавлять текст в модель, анализировать и дополнять его. Для того чтобы было удобно использовать новую модель документа в других программах, мы снабдим его полезным программным интерфейсом и разместим в библиотечном пакете com.porty.swing. Вот что у нас получится:
Текстовые компоненты |
503 |
//com/porty/swing/AutoCompleteTextDocument.java
//Модель документа с поддержкой автозаполнения package com.porty.swing;
import javax.swing.text.*; import javax.swing.*; import java.util.*;
public class AutoCompleteTextDocument extends PlainDocument {
//текстовый компонент в котором работает документ private JTextComponent comp;
//список слов для автозаполнения
private List<String> words = new ArrayList<String>(); // конструктор требует текстовый компонент
public AutoCompleteTextDocument(JTextComponent comp) { this.comp = comp;
comp.setDocument(this);
}
//добавляет слово в список public void addWord(String word) {
words.add(word);
}
//свойство, управляющее началом автозаполнения private int beforeCompletion = 3;
public void setBeforeCompletion(int value) { beforeCompletion = value;
}
//вызывается при вставке в документ нового текста
@Override
public void insertString(int offs, String str, AttributeSet a) throws BadLocationException {
//текущая позиция в тексте
int end = offs + str.length();
// определяем позиции текущего слова
final int wordStart = Utilities.getWordStart(comp, offs); // длина текущего слова
int wordLength = end — wordStart;
// проверим, можно ли завершать слово if ( wordLength >= beforeCompletion) {
// получаем текущее слово

504 ГЛАВА 16
String word = getText(wordStart, offs — wordStart) + str; // пытаемся найти его полный вариант в списке
String wholeWord = "";
for (String next : words) { if (next.startsWith(word)) {
// слово найдено wholeWord = next; break;
}
}
// если слово найдено
if ( wholeWord.length() > 0) {
//вырезаем часть для автозаполнения
final String toComplete = wholeWord.substring(wordLength);
//позиции для выделения этой части
final int startPos = offs + str.length(); final int endPos = end + toComplete.length();
//добавляем добавку к тексту str = str + toComplete;
//отложенная задача для выделения добавки
SwingUtilities.invokeLater(new Runnable() { public void run() {
try {
//выделим добавленную часть comp.setSelectionStart(startPos); comp.setSelectionEnd(endPos);
}catch (Exception ex) { ex.printStackTrace();
}
}
});
}
}
// родительский метод добавит текст super.insertString(offs, str, a);
}
}
Наша новая модель документа унаследована от стандартной модели текстовых полей и отличается парой вспомогательных методов, позволяющих быстро настроить режим работы механизма автоматического заполнения. Конструктор требует передать модели текстовый компонент, в котором будет работать модель — как мы увидим