Материал: rymsky12345
46
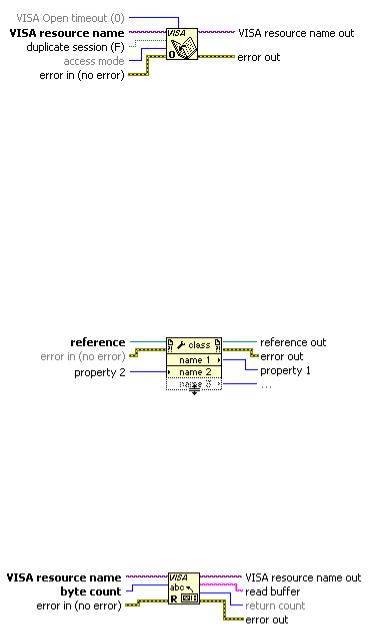
Наступним блок в коді йде функція VISA open рисунок 3.10. яка відповідно до назви відкриває сеанс пристрою і повертає ідентифікатор сеансу, який може використовуватися для виклику будь-яких інших операцій цього пристрою.
Рисунок 3.10. Блок функції VISA open
Блок Property Node рисунок 3.11. йде наступним, цей блок має багато налаштування для індикації та керування каналом. В нашому випадку налаштовуємо його на автоматичне виявлення присланих байт, так як ця інформація буде нам потрібна далі.
Рисунок 3.11. Блок Property Node
Функція VISA Read рисунок 3.11. йде наступною, вона читає зазначену кількість байтів з пристрою або інтерфейсу і відправляє дані в буфер читання.
Рисунок 3.11. Функція VISA Read
Останнім блоком цієї блок-схеми йде функція VISA Close вона по завершенню циклу закриває сеанс пристрою та виводить інформацію про можливі помилки в коді.
47
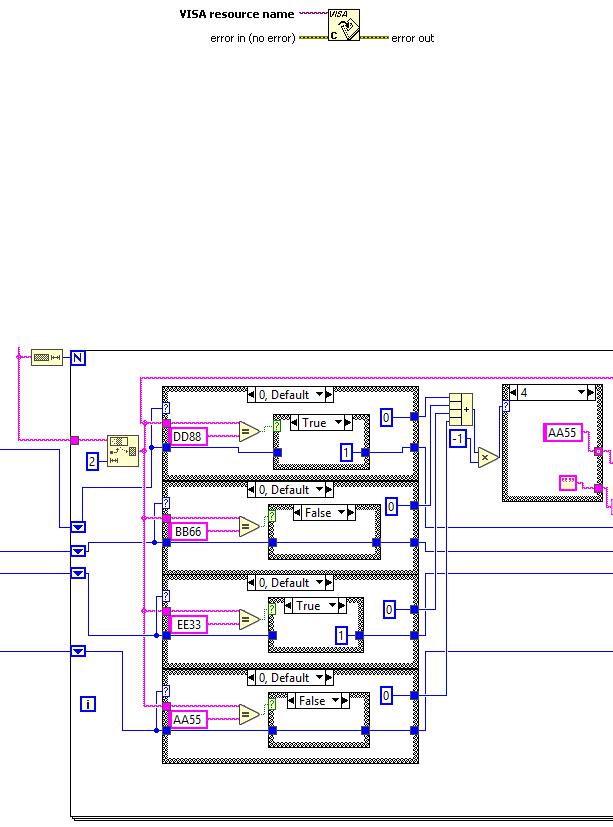
Рисунок 3.12. Функція VISA Close
Наступна частина програми (рисунок 3.12) відповідає за визначення маркера пакету даних. Використовуючи функцію String Subset Function (рисунок 3.13) ми послідовно беремо по 2 байти отриманих даних з буферу та порівнюємо їх з відомими нам маркерами. Коли одін із маркерів співпадає виконується умова true в середній сase структурі після чого зовнішній сase переходить на наступну ітерацію та передає інформацію до наступної частини коду. У випадку якщо маркер не знайдено на фронтальній панелі ПЗ виводиться повідомлення що прилад не знайдено.
Рисунок 3.12. Частина коду що відповідає за визначення маркеру пакетів
48
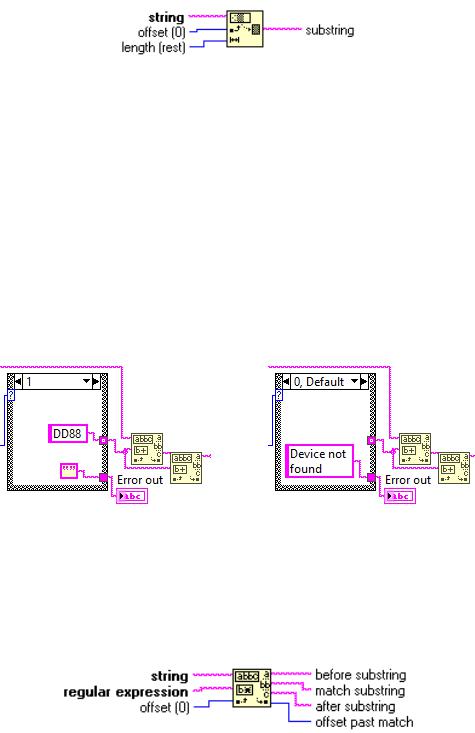
Рисунок 3.13. Функція String Subset
На рисунку 3.14 зображено частину блок-схеми яка відповідає за розподіл даних по пакетах. За допомогою функції Match Pattern (рисунок 3.15) відбувається виділення діапазону даних між двома маркерами, тобто відокремлення пакету дани від всього масиву. Для цього використовується дві такі функції, на виході першої ми залишаємо дані після маркеру а на виході другої вже беремо дані що перед ним. Ця функція дозволяє шукати регулярні вирази в рядку, починаючи з зміщення. Якщо функція знаходить відповідність, вона розбиває рядок на три підряди.
А) Б)
Рисунок 3.14. Частина коду в якій відбувається розділ отриманих даних по пакетах:
А) Випадок коли маркер пакету знайдено; Б) В базі даних не знайдено маркеру тому на дисплей виводиться повідомлення “Device not found”
Рисунок 3.15. Функція Match Pattern
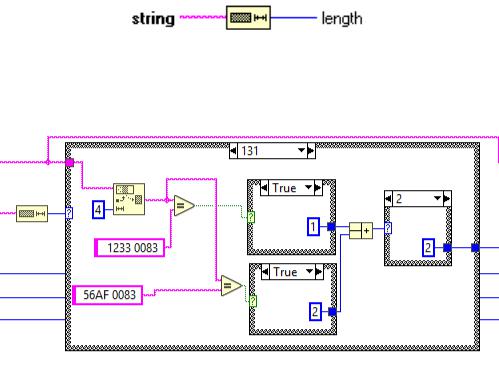
Таким чином, маючи відокремлений пакет даних на наступному етапі ми визначаємо його довжину. Довжина пакету визначається за допомогою функції String
Length (рисунок 3.16) яка повертає кількість символів (байт) в рядку. Знаючи маркер та довжину пакету даних ми можемо дізнатись з якого приладу отримано інформацію.
49
Але є можливість що в деяких приладів можуть співпадати формати видачі даних і довжина отриманих пакетів буде однакова. Тому відбувається перевірка службової інформації (рисунок 3.17).
Рисунок 3.16. Функції String Length
Рисунок 3.17. Перевірка службової інформації в пакеті
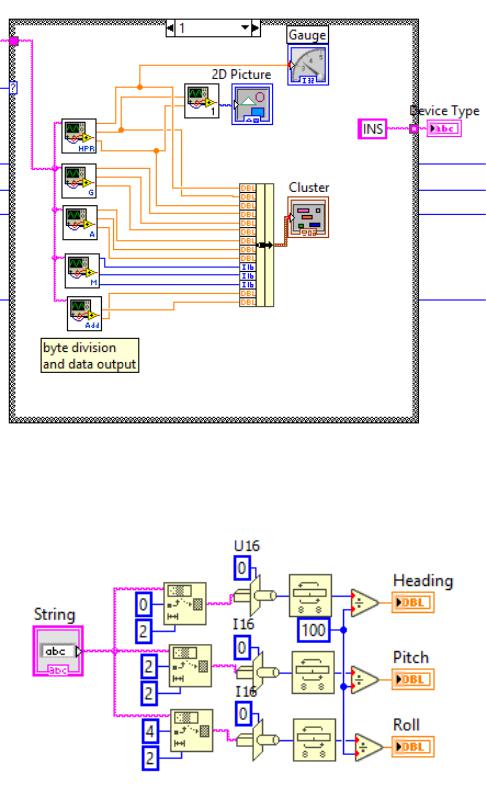
Після виконання останнього етапу перевірки ми точно знаємо якому приладу належить отриманий пакет даних. Тепер проводимо обробку даних та виводимо результати на дисплей (рисунок 3.18). Структура case перемикається на потрібну ітерацію, в ній проводиться обробка даних, для відповідного приладу. Обробка даних реалізована в блоках підпрограм (рисунок 3.19) і працю наступним чином. З
отриманого пакету за допомогою функції String Subset відокремлюємо необхідну кількість байт, потім вибрану кількість байт за допомогою функції Type Cast (рисунок
3.20.) конвертуємо з типу даних string в цілочисельний. Так як прилади видають бінарні дані то вихідні сигнали чутливих елементів домножають на певний коефіцієнт, для переведення в цілочисельний тип даних. Тому після конвертації
50
вихідні дані розділяємо на цей коефіцієнт, та виводимо результати обрахунків на
дисплей.
Рисунок 3.18. Частина блок-схеми що відповідає за визначення довжини пакету, обробку та виведення даних на дисплей.
Рисунок 3.19. Підпрограма обробки даних кутів орієнтації