Материал: 2047
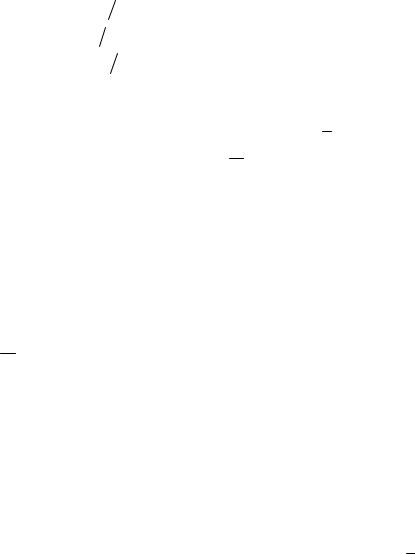
Например, в группе № 3 вернувших кредит вовремя, которую представляют мужчины (64 человека) со средне-специальным образованием, не имеющие детей, в возрасте от 35 до 45 лет заявленному слову-значению «быстро» указали вес 0 – 0 человек, 1 – 0 человек, 2
– 0 человек, 3 – 0 человек, 4 – 37 человек, 5 – 8 человек и 6 – 19 человек соответственно. Это означает, что наибольший уровень значимо-
сти – |
6 |
данного |
слова-значения |
встречается |
с |
частотой |
w03030606 |
19 64 0,297 |
, далее уровень |
значимости 5 с частотой |
|||
w03030605 |
8 |
64 0,125, |
уровень значимости 4 |
с |
частотой |
|
w03030604 |
37 64 0,578 |
. Уровни значимости 0,1,2,3 не были отмече- |
||||
ны ни одним из соискателей этой группы. Сумма полученных частот такой ГНС равна 1: w 0 0 0 0 0,578 0,125 0,297 1.
Далее, для перехода от вектора vi , характеризующего i-го заемщика, к вектору отличий wm, характеризующему m-ую группу в целом (в которую входит по условию заемщик), каждому событиюпризнаку Zj поставим в соответствие r относительных частот wmjr по
количеству событий-градаций для Zj.
Таким образом, для каждой m-й группы в соответствии с заданной структурой (4.2) получаем вектор отличий, характеризующий типовое СПП каждой m-й группы:
|
Z |
|
, Z |
|
, Z |
|
, Z ,Y,w |
|
,...,w |
|
,... |
w |
|
07 |
|
08 |
|
09 |
10 |
m010100 |
|
m010106 |
, |
m |
|
|
|
|
,...,wm061300, ,wm061306 |
|
|
||||
|
...,wm jr |
|
|
||||||||
m 1, ,64,r 0,...,6, который хранится и является основой формирования шаблона-маски для дальнейшей оценки соискателя.
Для каждого i-го заемщика m-й группы определяется оценка:
|
|
n 6 |
Zjr |
|
|
|
|
wmjr |
|
||
wi |
|
j 1r 0 |
|
, |
(4.5) |
|
|
||||
m |
|
n |
|
|
|
|
|
|
|
|
|
где Z jr 0,1 – компоненты вектора-строки vi конкретного i-го заемщика; n – количество событий-признаков; wmjr 0,1 – частоты,
взятые из матрицы шаблона-маски.
Таким образом, имеем МЗ, которая является описательной моделью – конечным множеством векторов отличий субъективного кредитного поведения. Координаты, отвечающие за субъективное поведение, отражают предпочтение того или иного СЗП, которые форми-
85
руют СПП, характерное для определенного типа КЗ в строгом соответствии с указанными социально-демографическими признаками и наиболее существенным признаком «хорошая»/ «плохая» кредитная история.
На основании имеющейся модели осуществим оценку рисков невозврата кредитных средств, связанных с субъективным кредитным поведением.
Зададимся условием, что ответы на анкетируемые социальнодемографические признаки соответствуют истине, то есть соответствуют выявленному и описанному шаблоном-матрицей весов СЗП – СПП для строго определенного типа КЗ, которые в срок вернули кредит – группы m и, соответственно для типа КЗ, не вернувших в срок кредит – группы m .
Для определения степени отличия возможно несколько вариантов. Можно использовать точечную оценку, сравнивая характерную
частоту группы w |
max w с характерной частотой соискателя |
m |
mjr |
|
j r |
wms , рассчитываемой по формуле (4.5).
Сравнивая полученные wm и wms находим коэффициент отли-
чия, выраженный, например, в процентах:
R |
w |
ws |
|
||
m |
|
m |
100 %. |
(4.6) |
|
|
|
|
|||
|
|
w |
|
|
|
|
|
m |
|
|
|
В данной работе предложены и далее реализованы следующие методы, лежащие в основе принятия решений:
метод на основе расчета рангового коэффициента корреляции Спирмена между типовым СПП m-й группы и индивидуальным СПП s-го соискателя;
метод интервальной оценки рисков невозврата кредитных средств, связанных с субъективным кредитным поведением (классификации соискателя/кредита).
Рассмотрим метод, который осуществляется на основе расчета рангового коэффициента корреляции Спирмена между типовым СПП m-й группы и индивидуальным СПП s-го соискателя.
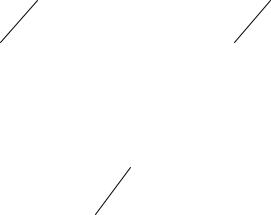
Сформулируем гипотезы:
86
|
корреляция между СПП s-го соискателя и типовым СПП |
||||||
H = |
|
|
|
|
|
; |
|
0 |
m-ной группы заемщиков не отличается от нуля |
|
|||||
|
корреляция между СПП s-го соискателя и типовым СПП |
||||||
H = |
|
|
|
|
|
. |
|
1 |
m-ной группы заемщиков отличается от нуля |
|
|
||||
Перед расчетом коэффициента ранговой корреляции rsm |
и rsm |
||||||
введем поправки на одинаковые ранги |
am3 am |
|
|
||||
|
Tm |
am3 |
am |
Tm |
|
(4.7) |
|
где am |
|
12 ; |
|
12 , |
|||
– объем каждой группы одинаковых рангов в ранговом ряду |
|||||||
типового профиля соответствующей группы m ; am – объем каждой группы одинаковых рангов в ранговом ряду типового профиля соответствующей группы m .
12 , (4.8)
где bs – объем каждой группы одинаковых рангов в ранговом ряду индивидуального профиля s-го соискателя.
Для расчета эмпирического значения используем формулы
r |
|
|
1 6 |
d 2 |
T |
m |
|
|
T |
s |
; |
(4.9) |
||||
|
|
|
m |
|
|
|
|
|||||||||
|
|
n n2 |
1 |
|
||||||||||||
sm |
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|||||||
r |
|
|
1 6 |
|
d 2 |
T |
m |
|
T |
s |
, |
(4.10) |
||||
|
|
|
m |
|
|
|
|
|
||||||||
|
|
|
n2 |
|
1 |
|
|
|||||||||
s m |
|
|
|
n |
|
|
|
|
|
|
||||||
|
|
|
|
|
|
|
|
|
|
|
||||||
где dm – разности рангов значений рангового ряда типового профи-
ля группы m и рангового ряда индивидуального профиля s-го соис-
кателя, dm – разности рангов значений рангового ряда типового
профиля группы m и рангового ряда индивидуального профиля s-го соискателя.
Полученные эмпирические значения rsm и |
rs m следует срав- |
нить с критическими значениями rs при p 0,05 |
и p 0,01, заданны- |
ми таблично [53]. Решение «выдать кредит» принимается при условии rsm rs при p 0,05. Если rsm rs при p 0,05 – принимается
87
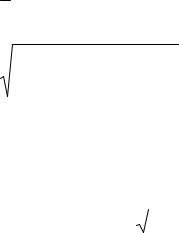
решение |
«отказать», далее решение переподтверждается, если |
|
rs m |
rs |
при p 0,05. |
|
Классификация соискателя (кредита) на основе рисков невозвра- |
|
та кредитных средств, связанных с субъективным кредитным поведе-
нием, осуществляется следующим образом. |
|
||||||
|
Вычислим выборочное среднее и стандартное отклонение выбо- |
||||||
рочного |
среднего |
для |
случайной величины w со |
значениями |
|||
w1 |
,w2 , ,wNm , где |
wi |
(конкретная частота для i-го заемщика m-й |
||||
m |
m |
m |
m |
|
|
|
|
группы обучающей выборки) для всех имеющихся групп: |
|
||||||
|
|
|
|
|
Nm |
|
|
|
|
|
w |
m wmi |
/Nm; |
(4.11) |
|
|
|
|
|
|
i 1 |
|
|
|
|
|
Nm |
wi |
|
|
2 |
|
|
|
|
|
|
|
|
|
w |
|
|
/N |
|
. |
(4.12) |
||
|
m |
|
i 1 |
m |
|
m |
|
|
m |
|
|
|
При этом вопрос репрезентативности выборки решается на основании коэффициента точности [81], который является показателем
точности оценки средней и определяется следующим образом: |
|
|||||||||||||||||||
введем ошибку средней S |
|
m |
m |
; |
|
|
|
|
||||||||||||
w |
|
|
|
|
|
|||||||||||||||
|
|
|
|
|
|
|
|
|
||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
Nm |
|
|||||||
введем коэффициент точности С |
S |
|
|
m |
100; |
|
||||||||||||||
w |
(4.13) |
|||||||||||||||||||
|
|
|
|
|
||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
wm |
|
|||||
примем условие c принятым коэффициентом точности [81]: |
||||||||||||||||||||
0 С 1; |
|
|
|
|
|
|
|
|
|
(4.14) |
||||||||||
предварительно определим величину границ доверительного |
||||||||||||||||||||
интервала в соответствии с принятым уровнем значимости: |
|
|||||||||||||||||||
tS |
|
|
|
m ; |
|
|
|
|
|
|
|
|
|
(4.15) |
||||||
w |
|
|
|
|
|
|
|
|
|
|||||||||||
рассчитаем, во сколько раз необходимо уменьшить величину |
||||||||||||||||||||
ошибки, чтобы достичь заданного уровня точности |
|
|||||||||||||||||||
|
С |
g; |
|
|
|
|
|
|
|
|
|
(4.16) |
||||||||
|
|
|
|
|
|
|
|
|
|
|
||||||||||
|
С |
|
|
|
|
|
|
|
|
|
|
|||||||||
определим |
|
|
|
|
|
|
|
|
|
|
||||||||||
|
tS |
|
m |
; |
|
|
|
|
|
|
|
|
|
|
||||||
w |
|
|
|
|
|
|
|
|
|
(4.17) |
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||
|
|
|
|
g |
|
|
|
|
|
|
|
|
|
|
||||||
88
|
|
|
|
|
K |
|
|
|
|
|
|
; |
|
|
|
|
|
(4.18) |
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
S |
|
m |
Nm |
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
w |
|
|
|
|
|
|
|||||||
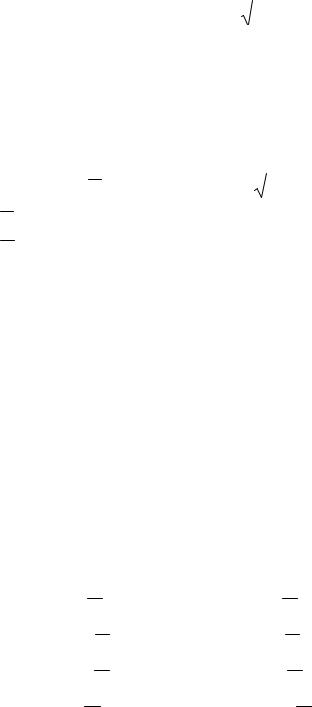
тогда объем выборки для заданной точности определяется |
||||||||||||||||||||
следующим образом: |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
' |
|
t 2 |
|
|
|
|
' |
|
|
C |
|
2 |
|
|||||||
|
|
|
Nm |
|
|
или Nm |
|
|
|
Nm. |
(4.19) |
|||||||||
|
|
|||||||||||||||||||
|
|
|
|
|
K |
|
|
|
|
|
|
|
|
C' |
|
|
|
|||
Далее находим интервалы для R=0,05 и R=0,10 соответственно, |
||||||||||||||||||||
учитывая, что |
w |
m k m, где k |
|
|
[133]: |
|
||||||||||||||
1/(1-R) |
|
|||||||||||||||||||
w |
m 1,026 m |
для R=0,05; |
|
|
|
|
|
|
|
|
|
|
||||||||
w |
m 1,054 m |
для R=0,10. |
|
|
|
|
|
|
|
|
|
|
||||||||
Определяем по (4.5) для соискателя оценку wmS , где m {1,...,32},
если вектор-строка соискателя «накладывается» на шаблон-маску с вектором отличия при Y=1, также по (4.5) определяем оценку wmS ,
где m {33,...,64} при Y=0.
Полученные величины – степени отличия вектора соискателя и вектора отличий для групп из шаблона-маски с совпадающими соци- ально-демографическими признаками при Y=1 и Y=0 соответственно, по сути, сумма частот, совпадающих по весу с шаблоном словзначений, разделенная на количество всех слов-значений, и будет вероятностью попадания соискателя в строго определенную социаль- но-демографическую группу вернувших или не вернувших кредит заемщиков:
w |
|
1,026 |
m |
|
ws |
|
|
w |
|
|
|
|
1,026 |
m |
; |
(4.20) |
|||||||||
|
m |
|
|
|
m |
|
|
|
|
|
|
m |
|
|
|
|
|
|
|||||||
w |
|
1,026 |
|
|
ws |
|
|
w |
|
|
1,026 |
|
|
|
(4.21) |
||||||||||
|
|
m |
|
|
|
m |
m |
|
|
|
|
|
|
|
m |
|
|
m |
|
|
|
||||
w |
|
1,054 |
|
|
ws |
|
|
|
w |
|
|
1,054 |
m |
; |
(4.22) |
||||||||||
|
|
m |
|
|
|
m |
m |
|
|
|
|
|
|
|
|
m |
|
|
|
|
|
||||
w |
m |
1,054 m |
wms |
|
|
w |
m 1,054 m . |
(4.23) |
|||||||||||||||||
Например, если выполняется неравенство (4.20) – рассматривае-
мый риск невозврата кредита RPh5 составляет 5 %; если выполняет-
ся условие (4.21), то риск невозврата RPh95 – 95 %.
В задачах выбора решений используются различные механизмы, которые определяются в зависимости от степени формализации фак-
89