Материал: КонспектНМ14_2018
Акумуляція (Accumulation)
Акумуляція або акумулювання в системах нечіткого виведення є процедурою або процесом знаходження функції приналежності для кожної з вихідних лінгвістичних змінних множини W = {w1, w2,…, ws}.
Мета акумуляції полягає в тому, щоб об'єднати або акумулювати всі ступені істинності висновків (підвисновків) для отримання функції приналежності для кожної з вихідних змінних. Причина необхідності виконання цього етапу полягає в тому, що підвисновки, що відносяться до однієї і тієї ж вихідної лінгвістичної змінної, належать різним правилам системи нечіткого виведення.
Формально процедура акумуляції виконується таким чином. До початку цього етапу передбачаються відомими значення істинності всіх підвисновків для кожного з правил Rk, що входять в дану базу правил Р системи нечіткого виведення, у формі сукупності нечітких множин: С1, С2,...,Сq, де q– загальна кількість підвисновків в базі правив. Далі послідовно розглядається кожна з вихідних лінгвістичних змінних wj∊W і нечіткі множини, що відносяться до неї: Cj1, C j2,...,C jq. Результат акумуляції для вихідної лінгвістичної змінної wj визначається як об'єднання нечіткої множини Cj1, C j2,...,C jq за однією з формул.
Етап акумуляції вважається закінченим, коли для кожної з вихідних лінгвістичних змінних будуть визначені підсумкові функції приналежності нечіткої множини їх значень, тобто сукупність нечітких множин: С1’, С2’,…, Сs’, де s– загальна кількість вихідних лінгвістичних змінних в базі правил системи нечіткого виведення.
Приклад 8.6. Для ілюстрації виконання цього етапу розглянемо приклад процесу акумуляції висновків для трьох нечітких множин С11, C12, C13, що отримані в результаті виконання процедури активізації для вихідної лінгвістичної змінної "швидкість руху автомобіля" в деякій системі нечіткого виведення. Припустимо, що функції приналежності цих нечітких множин зображені на рис. 8.7, а, б, в відповідно.
Акумуляція цих функцій приналежності методом max-об’єднання нечітких множин С11, C12, C13 за формулою (4.4) дозволяє отримати в результаті функцію приналежності вихідної лінгвістичної змінної "швидкість руху автомобіля", яка представлена на мал. 8.7, г. Ця функція приналежності відповідає нечіткій множині С1'', якщо прийнти, що дана вихідна лінгвістична змінна є w1.
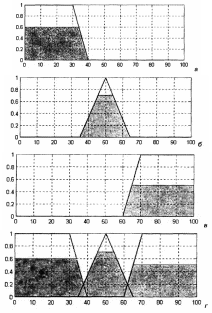
Рис. 8.7. Приклад акумуляції висновку для вихідної лінгвістичної змінної "швидкість руху автомобіля"
Дефазифікація (Defuzzification)
Дефазифікація в системах нечіткого виведення є процедурою або процесом знаходження звичайного (не нечіткого) значення для кожної з вихідних лінгвістичних змінних множини W = {w1, w2,…, ws}.
Мета дефазифікації полягає в тому, щоб, використовуючи результати акумуляції всіх вихідних лінгвістичних змінних, отримати звичайне кількісне значення (crisp value) для кожної з вихідних змінних, яке може бути використане спеціальними пристроями, зовнішніми по відношенню до системи нечіткого виведення.
Дійсно, пристрої і механізми, що використовуються в сучасних системах управління здатні сприймати традиційні команди у формі кількісних значень відповідних керуючих змінних. Саме з цієї причини необхідно перетворити нечіткі множини в деякі конкретні значення змінних. Тому дефазифікацію називають також приведенням до чіткості.
Формально процедура дефазифікації виконується таким чином. До початку цього етапу передбачаються відомими функції приналежності всіх вихідних лінгвістичних змінних у формі нечітких множин: C1’, C2’,...,Cs’, де s – загальна кількість вихідних лінгвістичних змінних в базі правил системи нечіткого виведення. Далі послідовно розглядається кожна з вихідних лінгвістичних змінних wj∊W і нечітка множина Сj’, що відноситься до неї. Результат дефазифікації для вихідної лінгвістичної змінної wj, визначається у вигляді кількісного значення yi∊R, що обчислюється за однією з формул, які розглядаються нижче.
Етап дефазифікації вважається завершеним, коли для кожної з вихідних лінгвістичних змінних будуть визначені підсумкові кількісні значення у формі деякого дійсного числа, тобто у вигляді у1, у2,..., ys, де s – загальна кількість вихідних лінгвістичних змінних в базі правил системи нечіткого виведення.
Для виконання чисельних розрахунків на етапі дефазифікації можуть бути використані наступні формули, що отримали назву методів дефазифікації.
Метод центру тяжіння
Центр тяжіння (COG, COG, Centre of Gravity) або центроїд площі розраховується за формулою:
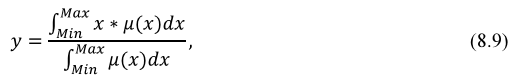
де
у
–
результат дефазифікації; х
– змінна,
що відповідає вихідній лінгвістичній
змінній w;
 –
функція приналежності нечіткої множини,
що відповідає вихідній змінній w
після
етапу акумуляції; Min
і
Мах
–
ліва і права точки інтервалу носія
нечіткої множини вихідної змінної w.
При дефазифікації методом центру тяжіння звичайне (не нечітке) значення вихідної змінної дорівнює абсцисі центру тяжіння площі, обмеженій графіком кривої функції приналежності, що відповідає вихідній змінній.
Приклад дефазифікації методом центру тяжіння функції приналежності вихідної лінгвістичної змінної "швидкість руху автомобіля" зображений на рис. 8.8. В цьому випадку y1=40 км/г (наближене значення).
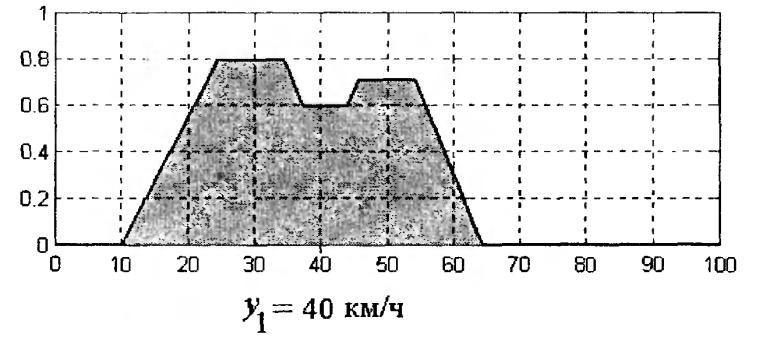
Рис. 8.8. Приклад дефазифікації вихідної лінгвістичної змінної "швидкість руху автомобіля" методом центру тяжіння
Метод центру тяжіння для одноточкових множин
Центр тяжіння (COGS, Centre of Gravity for Singletons) для одноточкових множин розраховується за формулою:
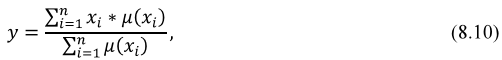
де n – число одноточкових (одноелементних) нечітких множин, кожна з яких характеризує єдине значення даної вихідної лінгвістичної змінної.
Приклад дефазифікації методом центру тяжіння для одноточкової множини функції приналежності вихідної лінгвістичної змінної "швидкість руху автомобіля" зображений на рис. 8.9. В цьому випадку y1=41 км/г (наближене значення).
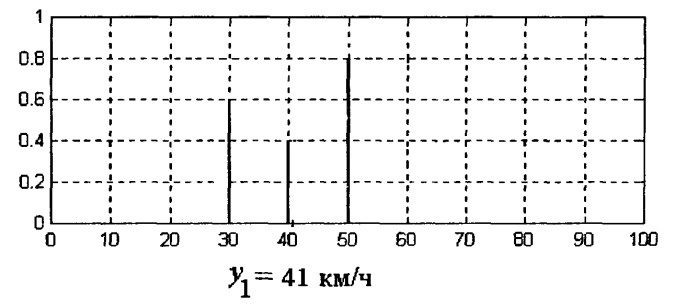
Рис. 8.9. Приклад дефазифікації вихідної лінгвістичної змінної "швидкість руху автомобіля" методом центру тяжіння для одноточкових множин
Метод центру площі
Центр площі (СОА, СОА, Centre of Area, Bisector of Area) дорівнює у = u, де значення u визначається з рівняння:
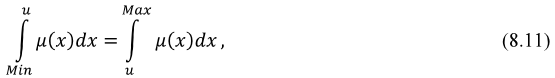
Іншими словами, центр площі дорівнює абсцисі, яка ділить площу, що обмежена графіком кривої функції приналежності відповідної вихідної змінної, на дві рівні частини. Іноді центр площі називають бісектрисою площі. Цей метод не може бути використаний у разі одноточкових множин.
Приклад дефазифікації методом центру площі функції приналежності вихідної лінгвістичної змінної "швидкість руху автомобіля" зображений на рис. 8.10. В цьому випадку y1=35 км/г (наближене значення).
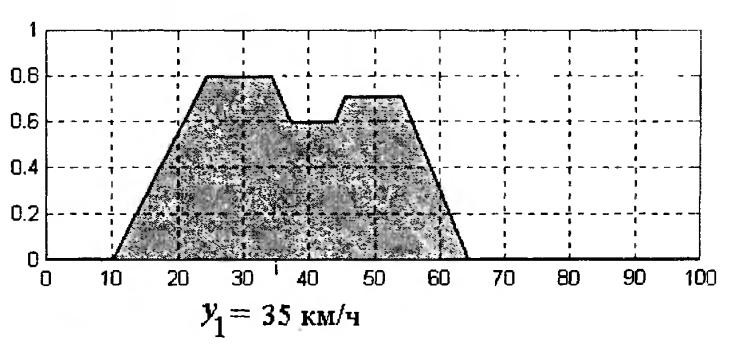
Рис. 8.10. Приклад дефазифікації вихідної лінгвістичної змінної "швидкість руху автомобіля" методом центру площі
Метод лівого модального значення
Ліве модальне значення (LM, Left Most Maximum) розраховується за формулою:
у = тin{хm} (8.12)
де хm – модальне значення (мода) нечіткої множини, що відповідає вихідній змінній w після акумуляції.
Іншими словами, значення вихідної змінної визначається як мода нечіткої множини для відповідної вихідної змінної або найменша з мод (найлівіша), якщо нечітка множина має декілька модальних значень.
Приклад дефазифікації методом лівого модального значення функції приналежності вихідної лінгвістичної змінної "швидкість руху автомобіля" зображений на рис. 8.11. В цьому випадку у1= 24 км/г (наближене значення).
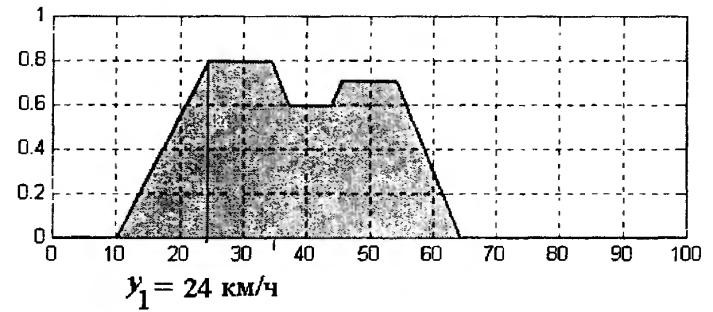
Мал. 8.11. Приклад дефазифікації вихідної лінгвістичної змінної "швидкість руху автомобіля" методом лівого модального значення
Метод правого модального значення
Праве модальне значення (RM, Right Most Maximum) розраховується за формулою:
у = тax{хm} (8.13)
де хm – модальне значення (мода) нечіткої множини для вихідний змінної після акумуляції.
В цьому випадку значення вихідний змінної також визначається як мода нечіткої множини для відповідної вихідної змінної або найбільша з мод (найправіша), якщо нечітка множина має декілька модальних значень.
Приклад дефазифікації методом правого модального значення функції приналежності вихідної лінгвістичної змінної "швидкість руху автомобіля" зображений на рис. 8.12. В цьому випадку у1=54 км/г (наближене значення).
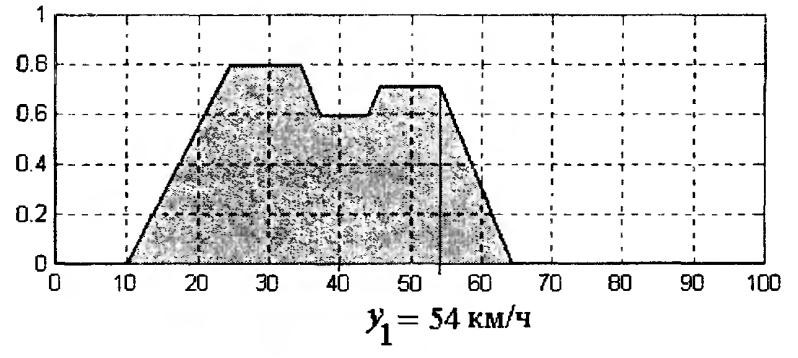
Рис. 8.12. Приклад дефазифікації вихідної лінгвістичної змінної "швидкість руху автомобіля" методом правого модального значення
Контрольні питання
Нечіткі лінгвістичні висловлювання.
Правила нечітких продукцій в системах нечіткого виведення.
Основні етапи нечіткого виведення.
Формування бази правил (знань) систем нечіткого виведення.
Процедура фазифікації в процесі нечіткого виведення.
Процедура агрегації в процесі нечіткого виведення.
Процедура активізації в процесі нечіткого виведення.
Процедура акумуляції в процесі нечіткого виведення.
Процедура дефазифікації в процесі нечіткого виведення. Основні методи дефазифікації.
Тема 7. Основні алгоритми нечіткого виведення
Розглянуті вище етапи нечіткого виведення можуть бути реалізовані неоднозначним чином, оскільки включають окремі параметри, які повинні бути фіксовані або специфіковані. Тим самим вибір конкретних варіантів параметрів кожного з етапів визначає деякий алгоритм, який в повному об'ємі реалізує нечітке виведення в системах правил нечітких продукцій. До теперішнього часу запропоновано декілька алгоритмів нечіткого виведення. Ті з них, які найбільш часто застосовуються в системах нечіткого виведення, розглядаються нижче.
Алгоритм Мамдані (Mamdani)
Алгоритм Мамдані є одним з перших, який знайшов застосування в системах нечіткого виведення. Він був запропонований в 1975 р. англійським математиком Е. Мамдані (Ebrahim Mamdani) як метод для управління паровим двигуном. За своєю суттю цей алгоритм породжує розглянуті вище етапи, оскільки найбільшою мірою відповідає їх параметрам.
Формально алгоритм Мамдані може бути визначений таким чином.
Формування бази правил систем нечіткого виведення. Особливості формування бази правил співпадають з розглянутими вище при описі даного етапу.
Фазифікація вхідних змінних. Особливості фазифікації співпадають з розглянутими вище при описі даного етапу.
Агрегація підумов в нечітких правилах продукцій. Для знаходження ступеню істинності умов кожного з правил нечітких продукцій використовуються бінарні нечіткі логічні операції. Ті правила, ступінь істинності умов яких відмінна від нуля, вважаються активними і використовуються для подальших розрахунків.
Активізація підвисновків в нечітких правилах продукцій. Здійснюється по формулі (8.6), при цьому для скорочення часу виведення враховуються тільки активні правила нечітких продукцій.
Акумуляція висновків нечітких правил продукцій. Здійснюється по формулі (4.4) для об'єднання нечітких множин, відповідних термам підвисновків, що відносяться до одних і тих же вихідних лінгвістичних змінних.
Дефазифікація вихідних змінних. Традиційно використовується метод центру тяжіння у формі (8.9) – (8.10) або метод центру площі (8.11).