Курсовая работа (т): Методы экспертных оценок
xi(k) - ранг i-го объекта по k - му признаку;
xi(j) - ранг j-го объекта по k - му признаку;
(xi(k) - xi(j))2 - квадрат разности рангов.
названный впоследствии ранговым коэффициентом корреляции Спирмэна. Прямым подсчетом нетрудно убедиться, что для совпадающих ранжировок (т.е. при xi(k) = xi(j) для всех i = l,2,...,n) τkj(s) = 1 а для противоположных (т. е. при xi(k) = n - xi(j)+ 1, i = 1 , 2, . . . , n) - τkj(s) = - 1.Можно показать, что во всех остальных случаях | τkj(s) | < 1./4/
Формула (1) пригодна лишь в случае
отсутствия объединенных рангов в обеих исследуемых ранжировках. Для ее
распространения на общий случай определим для каждой (k-й)
ранжировки X(k) (k = 0,1,... ,р)
величину/4/
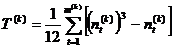 (2)
где m(k) - число групп неразличимых рангов у переменной x(k), а nt(k) - число элементов (рангов), входящих в t-ю группу неразличимых рангов (в частном случае отсутствия объединенных рангов имеем m(k) = n, n1(k) = n2(k) =…= nn(k)=1 и соответственно T(k) = 0; кроме того, группы неразличимых рангов, состоящие из единственного элемента, по существу, не участвуют в расчете величины T(k))
Тогда ранговый коэффициент
корреляции Спирмэна между ранжировками X(k) и X(j) следует
вычислять по формуле
(3)
Если Т(k)
и Т(j)
являются небольшими относительно (1/6)*(n3
- n) величинами, то
можно воспользоваться приближенным соотношением (а при Т(k)
= Т(j)
оно точное)
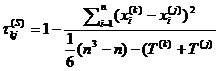 (4)
Правда, при этом же условии (относительная малость Т(k) + Т(j) по сравнению с (1/6)*(n3 - n) и приближенная формула (1) дает хорошую точность.
Другой широко используемой
характеристикой тесноты статистической связи между двумя упорядочениями
является ранговый коэффициент корреляции Кендалла, определяемый соотношением
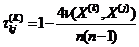 (5)
где ν(Х(k) ,X(j)) - минимальное число обменов соседних элементов последовательности X(j), необходимое для приведения ее к упорядочению Х(k). Очевидно, величина ν(Х(k) ,X(j)) симметрична относительно своих аргументов, так что с равным правом можно говорить о минимальном числе «соседских обменов» элементов последовательности Х(k), необходимом для приведения к виду X(j)./4/
Из формулы (5) следует, что при совпадающих ранжировках Х(k) и X(j) τ(K)kj = 1 (так как ν(Х(k) ,X(j)) = 0), а при противоположных (т.е. при xi(k) = n-xi(j)+l, i= 1,2,..., n, так что ν(Х(k) ,X(j)) = (1/2)n(n-1)) - τ(K)kj = 1. Нетрудно показать, что во всех остальных случаях |τ(K)kj| < 1.
Вычисление τ(K)kj связано с необходимостью подсчета величины ν(Х(k),X(j))и, следовательно, является более трудоемким, чем вычисление τ(S)kj. Однако, во-первых, коэффициент Кендалла обладает некоторыми преимуществами по сравнению с коэффициентом Спирмэна, главные из них: а)относительно большая продвинутость в исследовании его статистических свойств и, в частности, его выборочного распределения (см. ниже); б)возможность его использования и в частной («очищенной») корреляции рангов; в) большие удобства его пересчета при добавлении к n статистически обследованным объектам новых, т.е. при удлинении анализируемых ранжировок: для вычисления нового значения рангового коэффициента корреляции приходится переранжировать значительную часть объектов, что в случае τ(S)kj означает необходимость пересчета разностей xi(k) - xi(j); при вычислении же τ(K)kj значения рангов не играют никакой роли, важно лишь число необходимых «соседских обменов», которое при добавлении новых объектов подсчитывается рекуррентным способом (к старому значению ν(Х(k),X(j))) может быть лишь дополнен некоторый «добавок»).
Во-вторых, можно воспользоваться рекомендациями, упрощающими подсчет числа ν(Х(k),X(j)) как при ручном, так и при машинном счете.
Так, при ручном счете полезным
оказывается известный факт тождественного совпадения величин ν(Х(k),X(j)) и I(Х(k),X(j)), где число
инверсий I(Х(k),X(j)) - это
просто число расположенных в неодинаковом порядке пар элементов
последовательностей Х(k) и X(j), являющееся
естественной мерой нарушения порядка объектов в одной последовательности
относительно другой. Для удобства подсчета I(Х(k),X(j))
перенумеруем объекты в порядке, определяемом рангами последовательности Х(k). Тогда
анализируемые ранжировки Х(k), X(j)
соответствующим образом видоизменяются, т.е. преобразуются к виду соответственно
Х(k), X(j), где X(k) = (l,2,...,n)T; X(j) = (x1(j), x2(j),…, xn(j))Т,
а число инверсий I(Х(k),X(j)) = I(X(k),X(j)), а
следовательно, и величина ν(Х(k),X(j))
определяется по формуле
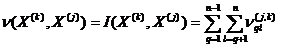 (6)
где
, если xq(j) > xi(j) (т.е. нарушен порядок последовательности X(k));
νql(j,k) =0- в противоположном случае.
Легко подсчитать, что число инверсий I(Х(k),X(j)) может меняться от 0 (что соответствует случаю совпадающих ранжировок) до (1/2)n(n - 1) (что соответствует случаю противоположных ранжировок).
Формулы (5)-(6) пригодны для
подсчета τ(K)kj лишь в
случае отсутствия объединенных рангов в обеих исследуемых ранжировках.
Соответствующее «подправленное» значение τkj*(K) - при
наличии объединенных рангов в анализируемых упорядочениях будет определяться
соотношением
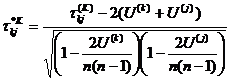 (5΄)
в котором коэффициент τ(K)kj вычисляется
по формуле (5)-(6), а «поправочные» величины U(l)
определяются соотношением
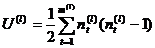 (7)
(смысл величин m(l) и nt(l), определен выше, см. (3)).
При решении основных задач А - С
статистического анализа ранговых связей (возникает необходимость уметь измерить
статистическую связь между несколькими (более чем двумя) переменными. С этой
целью Кендаллом был предложен показатель Ŵ(m), названный
коэффициентом конкордации (или согласованности), вычисляемый по формуле
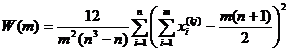 (8)
где m - число анализируемых порядковых переменных (сравниваемых упорядочений); n - число статистически обследованных объектов или длина ранжировки (объем выборки); k1, k2,…,km - номера отобранных для анализа порядковых переменных (из исходной совокупности x(0), x(1), x(2), …, x(p)) , так что, очевидно, m ≤ р + 1).
Свойства коэффициента конкордации:
a) 0≤ Ŵ ≤1;
б) Ŵ = 1 тогда и только тогда, когда все m анализируемых упорядочений совпадают;
в) если m ≥ 3 и анализируемые ранжировки генерируются подобно случайному независимому m-кратному извлечению из множества всех n возможных упорядочений n объектов, то связи между ними нет и W = 0;
г) пусть τ(S)(m) - среднее значение коэффициента Спирмэна, подсчитанное по значениям m(m- 1)/2 коэффициентов τ (S)kikj. (i,j = 1, 2,..., m; i≠j), характеризующих ранговую связь между всеми возможными парами переменных (x(ki), x(kj)) из анализируемого набора (x(k1), x(k2),…, x(km) ); тогда
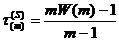 (9)
в частности, из (9) следует для
случая m = 2, что
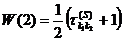 (9΄)
т.е. коэффициент конкордации, исчисленный для двух переменных, пропорционален парному ранговому коэффициенту корреляции Спирмэна.
То, что шкала измерения W(m) не включает в себя отрицательных значений, объясняется следующим обстоятельством. В отличие от случая парных связей при анализе m(m ≥ 3) порядковых переменных противоположные понятия согласованности и несогласованности утрачивают прежнюю симметричность (относительно нуля); упорядочения, произведенные в соответствии с переменными x(k1), x(k2),…, x(km), могут полностью совпадать, но не могут полностью не совпадать.
Формула (8) получена в предположении
отсутствия объединенных рангов в каждом из анализируемых упорядочений. Если же
таковые имеются, то формула должна быть модифицирована:
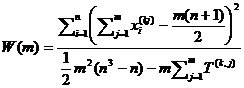 (8΄)
где поправочный формуле (2коэффициент Т(kj) (соответствующий переменной x(kj) подсчитывается по)).
Для того чтобы определить, как ведут себя выборочные значения Ŵ(m) коэффициента конкордации при повторении выборок заданного объема n (из одной и той же генеральной совокупности) при отсутствии какой-либо связи между анализируемыми m переменными.
Предположим, что каждому объекту конечной генеральной совокупности (состоящей из N элементов) приписан какой-то определенный ранг по каждой из m рассматриваемых переменных. Так, например, если m = 3 и объекту Оi приписана тройка (xi(1) = N, xi(2) = 1, xi(3) = 2), то это означает, что по переменной xi(1) он стоит на последнем (N-м) месте в упорядоченном ряду всех объектов генеральной совокупности, по переменной x(2) - на первом и по переменной x(3) - на втором.
Тогда по исходным данным {(xi(1), xi (2),…, xi(m))}1=1,N помощью формулы (8) может быть вычислен теоретический (генеральный) коэффициент конкордации W(m), характеризующий степень тесноты ранговой связи между переменными x(1), x (2),…, x(m). Однако исследователю известны значения (x(1), x(2),…, x(m)) лишь для части объектов генеральной совокупности, а именно для случайной выборки объектов объема n(n < N). После естественной перенумерации рангов, сохраняющей правило упорядочения объектов, но переводящей масштаб измерения рангов в шкалу (1,2,...,n) (для этого минимальный из оказавшихся в выборке рангов по каждой переменной объявляется рангом, равным 1, следующий по величине - рангом, равным 2, и т.д.), может быть вычислен (по той же формуле (8)) выборочный коэффициент конкордации W(m). Извлекая другую выборку объема n из той же самой генеральной совокупности, мы получим, вообще говоря, другое значение выборочного коэффициента W(m) и т.д.
Как сильно могут отклоняться от нуля выборочные значения коэффициента конкордации Ŵ(m) в ситуации, когда значение теоретического коэффициента конкордации W(m) свидетельствует о полном отсутствии ранговой связи между анализируемыми переменными х(1),х(2),...,х(m)? Для малых значений m и n(2 ≤ m ≤ 20, 3 ≤ n ≤ 7) ответ на этот вопрос может быть получен с помощью таблицы значений величины S. Обозначенная в ней величина S есть не что иное, как
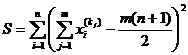 (10)
«Входами» в эту таблицу является тройка чисел (m, n, S), «выходом» - вероятность того, что величина S может быть такой, какой она является в нашей выборке, или большей в условиях отсутствия связи переменных в генеральной совокупности. Если окажется, что эта вероятность меньше принятой нами величины уровня значимости критерия а (например, α = 0,05), то гипотезу об отсутствии связи следует отвергнуть, т.е. признать статистическую значимость анализируемой связи. Таблица критических значений W(m) построена несколько иначе. В ней при уровне значимости α = 0,05 и в соответствии с «входами» (m, n) даны «критические» значения величины S, т. е. такие значения, при превышении которых следует отвергать гипотезу об отсутствии связей (признавать их статистическую значимость).
При n > 7 для
проверки статистической значимости анализируемой связи следует воспользоваться
фактом приближенной  (n-1)-распределенности
величины m(n - 1)*W(m),
справедливым в условиях отсутствия связи в генеральной совокупности. Поэтому,
если окажется, что /4/
 m(n-1)W(m)>
 (n-1)
то гипотеза об отсутствии ранговой
связи между переменными зг , i ,...,х должна быть отвергнута (с
уровнем значимости критерия, равным а); в (11.58) величина (n-1) - это
100а%-ная точка -распределения
с (n-1)-й
степенью свободы.
Строгих рекомендаций по построению доверительных интервалов для истинного значения W в условиях наличия ранговых связей в исследуемой генеральной совокупности к настоящему времени не имеется./4/
Преимущество коэффициента корреляции рангов состоит в том, что ранжировать можно и по таким признакам, которые нельзя выразить численно: можно проранжировать кандидатов на занятии определенной должности по профессиональному уровню. По умению руководить коллективом, по личному обаянию и т.п. при экспертных оценках можно ранжировать оценки разных экспертов и найти их корреляции друг с другом, чтобы затем исключить из рассмотрения оценки эксперта, слабо коррелированные с оценками других экспертов. Коэффициент корреляции рангов применяется для оценки устойчивости тенденции динамики. /5/
Недостатком коэффициент корреляции
рангов является то, что одинаковым разностям рангов могут соответствовать
совершенно отличные разности значений признаков (в случае количественных
признаков). /5/
2.2 Примеры использования данных экспертных оценок
В данной главе рассмотрим примеры для прояснения работоспособности ранговых коэффициентов корреляции Спирмена, Кендалла и конкордации.
Пример 1
По данным 10-ти предприятий
сельскохозяйственной отрасли эксперту необходимо определить зависимость между
балансовой прибылью и объемом реализованной продукции. В таблице 1 указаны
исходные данные по предприятию.