Материал: Основы инженерного эксперимента. Солженикин П.А., Стогней В.Г
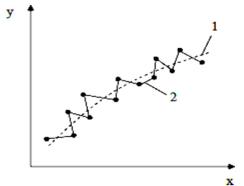
В данном случае число независимых уравнений системы равно числу опорных точек, в пределе – n поставленных опытов. С другой стороны, для определения k+1 коэффициентов необходимо не менее k+1 независимых уравнений. Но если число n поставленных опытов и число независимых уравнений равно числу искомых коэффициентов k+1, то решение системы может быть единственно, а следовательно, точно соответствует случайным значениям исходных данных. Таким образом, в предельном случае, когда число коэффициентов уравнения регрессии равно числу экспериментальных точек n=k+1, все экспериментальные точки будут совпадать с их расчетными значениями. Следует заметить, что добиваться такого точного совпадения путем значительного увеличения числа коэффициентов уравнения регрессии часто просто неразумно, поскольку экспериментальные результаты получены с большей или меньшей погрешностью, и такая функция может просто не отражать действительного характера изменения исследуемой величины в силу влияния помех (возмущений) (рис. 5.3).
Рис. 5.3. Аппроксимация функции
с большим (1) и небольшим (2) числом коэффициентов bj
105
Таким образом, задача в конечном счете сводится к решению системы k+1 уравнений с k+1 неизвестными. Основная сложность такого решения связана с нелинейностью системы, хотя в принципе при использовании компьютера она преодолима. При числе опытов n большем, чем k+1 искомых коэффициентов, число независимых уравнений системы избыточно. Избыточность информации можно использовать по-разному.
После определения численных значений k+1 параметров проверяется качество аппроксимации путем сопоставления значений функции и экспериментальных данных в оставшихся, неиспользованных точках. Если обнаруженные между ними расхождения превышают допустимые по условию точности, то процедуру определения коэффициентов bj можно повторить, приняв в качестве опорных (основных) другие точки.
Таким образом, из этих уравнений в разных комбинациях можно составить несколько систем уравнений, каждая из которых в отдельности даст свое решение. Но между собой они будут несовместимыми. Каждое решение будет соответствовать своим значениям коэффициентов bj. Если все их построить на графике, то получим целый пучок аппроксимирующих кривых.
Это открывает при n>k+1 совершенно новые возможности. Во-первых, этот пучок кривых показывает форму и ширину области неопределенности проведенного эксперимента. Вовторых, может быть произведено усреднение всех найденных кривых и полученная усредненная кривая будет гораздо точнее и достовернее описывать исследуемое явление, так как она в значительной степени освобождена от случайных погрешностей, приводивших к разбросу отдельных
106
экспериментальных точек. Поясним суть этого подхода на примере двух методов.
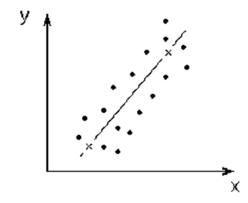
1. Метод избранных точек (рис. 5.4). На основании анализа данных выдвигают гипотезу о виде (форме) зависимости f(X). Предположим, что она линейная, т.е. статистическая связь – это линейная одномерная регрессия
ỹ=b0+b1x (4.5).
Выбирают две наиболее характерные, по мнению исследователя, точки, через которые и проходит линия регрессии (рис. 5.4). Задача вычисления коэффициентов b0 и b1 в этом случае тривиальна. Если предполагается, что уравнение регрессии более высокого порядка, то соответственно увеличивают число избранных точек. Недостатки такого подхода очевидны, так как избранные точки выбираются субъективно, а подавляющая часть экспериментального материала не используется для определения параметров (коэффициентов) уравнения регрессии, хотя ее можно использовать в дальнейшем для оценки надежности полученного уравнения.
Рис. 5.4. Метод избранных точек: × – избранные точки
107
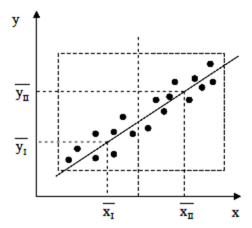
2. Метод медианных центров. Сущность этого метода поясняет рис. 5.5. Обведенное контуром поле точек делят на несколько частей, число которых равно числу определяемых коэффициентов уравнения регрессии. В каждой из этих частей находят медианный центр, т.е. пересечение вертикали и горизонтали слева и справа, выше и ниже которых оказывается равное число точек. Затем через эти медианные центры проводят плавную кривую и из решения системы уравнений определяют коэффициенты регрессии bj. Так, в случае линейной зависимости (рис. 5.5) поле делится на две группы.
Определяют средние значения |
, , |
, |
для каждой из |
||
групп, а неизвестные коэффициенты b0, b1 |
определяют из |
||||
решения системы уравнений: |
|
|
|
||
= |
+ |
; |
|
|
(5.5) |
= |
+ |
п. |
|
|
|
Рис. 5.5. Метод медианных точек
108
Если при выборе вида уравнения регрессии число его коэффициентов bj окажется больше числа уравнений (имеющихся результатов измерений) k+1>n, система (5.4) не будет иметь однозначного решения. В этом случае необходимо либо уменьшить число определяемых коэффициентов k+1, либо увеличить число опытов n.
Второй подход – метод наименьших квадратов. Усреднение несовместимых решений избыточной системы уравнений n>k+1 может быть преодолено методом наименьших квадратов, который был разработан еще Лежандром и Гауссом. Таким образом, метод наименьших квадратов – это «новинка» почти 200-летней давности. Сегодня, благодаря возможностям компьютеров, этот метод вступил, по существу, в полосу своего «ренессанса».
Определение коэффициентов bj методом наименьших квадратов основано на выполнении требования, чтобы сумма квадратов отклонений экспериментальных точек от соответствующих значений уравнения регрессии была минимальна. Заметим, что, в принципе, можно оперировать и суммой других четных степеней этих отклонений, но тогда вычисления будут сложнее. Однако руководствоваться суммой отклонений нельзя, так как она может оказаться малой при больших отклонениях отрицательного знака.
Математическая запись приведенного выше требования
имеет |
вид |
1 |
j |
k |
∑ |
[( , , |
(5.6) i |
→min0 |
bj, |
||||||
Ф(b , b |
…, b…, b |
) = |
b …b …b )- y ] |
||||
где n – число экспериментальных точек в рассматриваемом интервале изменения аргумента x.
Необходимым условием минимума функции Ф(b0, b1,..., bi,..., bk) является выполнение равенства
109