Материал: Основы инженерного эксперимента. Солженикин П.А., Стогней В.Г
представляет собой линию на плоскости, при двухфакторном (k=2) – поверхность в трехмерном пространстве. Связи в общем случае являются достаточно многообразными и сложными. Обычно выделяют следующие виды связей.
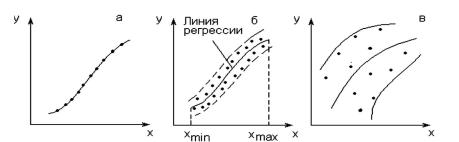
Функциональные связи (или зависимости) – это такие связи, когда при изменении величины X другая величина y изменяется так, что каждому значению xi соответствует совершенно определенное (однозначное) значение yi (рис. 5.1,а). Таким образом, если выбрать все условия эксперимента абсолютно одинаковыми, то, повторяя испытания, получим одну и ту же зависимость, т.е. кривые идеально совпадут для всех испытаний.
К сожалению, такие условия в реальности не встречаются. На практике не удается поддерживать постоянство условий (например, физико-химические свойства шихты при моделировании процессов тепломассопереноса в металлургических печах). При этом влияние каждого случайного фактора в отдельности может быть мало, однако в совокупности они существенно могут повлиять на результаты эксперимента. В этом случае говорят о стохастической (вероятностной) связи между переменными.
Рис. 5.1. Виды связей: а – функциональная связь, все точки лежат на линии; б – связь достаточно тесная, точки группируются возле линии регрессии, но не все они лежат на ней; в – связь слабая
100
Стохастичность связи состоит в том, что одна случайная переменная y реагирует на изменение другой X изменением своего закона распределения (см. рис. 5.1, б). Таким образом, зависимая переменная принимает не одно конкретное значение, а некоторое из множества значений. Повторяя испытания, мы будем получать другие значения функции отклика, и одному и тому же значению X в различных реализациях будут соответствовать различные значения y в интервале [ xmin ; xmax ] Искомая зависимость ỹ =f(X) может быть найдена лишь в результате совместной обработки полученных значений X и y.
На рис. 5.1, б – это кривая зависимости, проходящая по центру полосы экспериментальных точек (математическому ожиданию), которые могут и не лежать на искомой кривой ỹ=f(X), а занимают некоторую полосу вокруг нее. Эти отклонения вызваны погрешностями измерений, неполнотой модели и учитываемых факторов, случайным характером самих исследуемых процессов и другими причинами.
Анализ стохастических связей приводит к различным постановкам задач статистического исследования зависимостей, которые упрощенно можно классифицировать следующим образом:
1)задачи корреляционного анализа – задачи исследования наличия взаимосвязей между отдельными группами переменных ;
2)задачи регрессионного анализа – задачи, связанные с установлением аналитических зависимостей между переменным y и одним или несколькими переменными x1 , x2 , … , xi , … , xk , которые носят количественный характер;
3)задачи дисперсионного анализа – задачи, в которых переменные x1 , x2 , … , xi , … , xk имеют качественный характер, а исследуется и устанавливается степень их влияния на переменное y.
101
Стохастические зависимости характеризуются формой, теснотой связи и численными значениями коэффициентов уравнения регрессии.
Форма связи устанавливает вид функциональной зависимости ỹ=f(X) и характеризуется уравнением регрессии. Если уравнение связи линейное, то имеем линейную многомерную регрессию, в этом случае зависимость ỹ от X описывается линейной зависимостью в k-мерном пространстве:
ỹ=b0+ ∑ |
, |
(5.2) |
где b0, ..., bj, ..., bk – коэффициенты уравнения.
Для пояснения существа используемых методов ограничимся сначала случаем, когда x – скаляр. В общем случае виды функциональных зависимостей в технике достаточно многообразны: показательные, y=b0xb1 , логарифмические y=b0lg(x) и т.д.
Заметим, что задача выбора вида функциональной зависимости – задача не формализуемая, так как одна и та же кривая на данном участке примерно с одинаковой точностью может быть описана самыми различными аналитическими выражениями. Отсюда следует важный практический вывод. Даже в наш век компьютеров принятие решения о выборе той или иной математической модели остается за исследователем. Только экспериментатор знает, для чего будет в дальнейшем использоваться эта модель, на основе каких понятий будут интерпретироваться ее параметры.
Крайне желательно при обработке результатов эксперимента вид функции ỹ=f(X) выбирать, исходя из условия ее соответствия физической природе изучаемых явлений или имеющимся представлениям об особенностях поведения исследуемой величины. К сожалению, такая возможность не
102
всегда имеется, так как эксперименты чаще всего проводятся для исследования недостаточно или неполно изученных явлений.
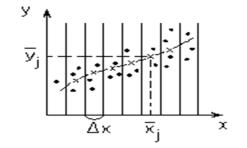
При изучении зависимости ỹ=f(x) от одного фактора при заранее неизвестном виде функции отклика для приближенного определения вида уравнения регрессии полезно предварительно построить эмпирическую линию регрессии (рис. 5.2). Для этого весь диапазон изменения x разбивают на равные интервалы Δx. Все точки, попавшие в данный интервал Δxj относят к его середине xj. Для этого подсчитывают частные средние для каждого интервала:
Рис. 5.2. К построению эмпирической линии регрессии
yj =∑ |
/nj . |
(5.3) |
Здесь nj – число точек в интервале Δxj, причем , где– число интервалов разбиения; n – объем выборки.
Затем последовательно соединяют точки (xj ,yj) отрезками прямой. Полученная ломаная называется эмпирической линией регрессии. По виду эмпирической линии регрессии можно в первом приближении подобрать вид уравнения регрессии ỹ=f(x).
Под теснотой связи понимается степень близости стохастической зависимости к функциональной, т.е.
103
показатель тесноты группирования экспериментальных данных относительно принятого уравнения модели (см. рис. 5.1,б,в). В дальнейшем уточним это положение.
5.2. Определение коэффициентов уравнения регрессии
Будем полагать, что вид уравнения регрессии уже выбран и требуется определить только конкретные численные значения коэффициентов этого уравнения b= {b0… , bj … , bk }. Отметим предварительно, что если выбор вида уравнения регрессии, как это уже отмечалось, – процесс неформальный и не может быть полностью передан компьютеру, то расчет коэффициентов выбранного уравнения регрессии – операция достаточно формальная и ее следует решать с использованием компьютера. Это трудный и утомительный расчет, в котором человек не застрахован от ошибок, а компьютер выполнит его значительно быстрее и качественнее. Существует два основных подхода к нахождению коэффициентов bj . Выбор того или иного из них определяется целями и задачами, стоящими перед исследователем, точностью полученных результатов, их количеством и т.д.
Первый подход – интерполирование. Базируется на удовлетворении условию, чтобы функция ỹ=(X,b) совпадала с экспериментальными значениями в некоторых точках, выбранных в качестве опорных (основных, главных) yj.
В этом случае для определения k+1 неизвестных значений параметров bj используется система уравнений
f(xj ,b0 ,bj ,bk )= yj 1≤i≤n . |
(5.4) |
104