Материал: Проблемы обеспечения надежности и качества приборов, устройств и систем
2)
В противном случае, т. е. если блок p
исчерпан или выбрано множество
,
такое, что
 ,
перейти к шагу 4.
Шаг возвращения
Шаг
4. B
не может привести к лучшему решению.
Если
 (т.е. блок 1 исчерпан), то алгоритм
заканчивает работу и оптимальным
решением является
.
В противном случае удалить последнее
множество, скажем,
 ,
добавить его в B,
положить
 ,
поставить метку над множеством
 ,
удалить предшествующую метку в блоке
l
и перейти к шагу 3.
Проверка нового решения
Шаг
5. Обновить данные:
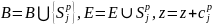 .
Если найдено лучшее решение
 ,
то положить
 ,
 и перейти к шагу 2.
Если
поиск оканчивается с исчерпыванием
блока 1 (см. выше шаг 4), то целесообразно
переставить блоки в порядке возрастания
числа столбцов (множеств) в каждом блоке.
Это может быть осуществлено (перед
построением исходной таблицы)
перенумерацией элементов (строк)
 в порядке увеличения числа множеств
из S,
содержащих соответствующие элементы.
В алгоритме, описанном выше, единственным шагом, характерным для ЗНР, является шаг 3-1. Если удалить в этом шаге требование неперекрываемости (т.е. необязательно, чтобы защита от угрозы реализовывалась только одним средством), то алгоритм может быть использован для ЗНП. Однако в этом случае исходная таблица будет отличаться от таблицы 1.
Положим
Sj={rj1,rj2,…},
где
 …
. Теперь недостаточно включить Sj
только в блок
 ,
поскольку без требования неперекрываемости
нельзя исключить Sj
из рассмотрения, например, в блоке
 ,
если rj1
уже покрыто частным решением. Следовательно,
Sj
должно входить в каждый блок
 …
. С другой стороны, поскольку элемент
 из Sj
согласно тому, что поиск осуществляется
последовательно, покрывается перед
ветвлением на множествах блока β (
 ),
то теперь возможно удалить все элементы
xjα
из Sj
перед введением Sj
в
любой блок
без какого-либо влияния на результат
решения задачи. Эта тривиальная операция
удаления с вычислительной точки зрения
оказывается очень выгодной, поскольку
исходная таблица в ЗНП теперь может
быть сокращена с помощью описанных выше
правил, до значительно меньших размеров.
Рассмотрим некоторые важные условия и вычисление нижних границ, которые могут быть использованы для ограничения дерева поиска и улучшения эффективности основного алгоритма.
Рассмотрим
случай, когда блок 1 содержит (среди
других) множества
 и
 со стоимостями 3 и 4 соответственно, а
блок 2 содержит множества
 и
 ,
каждое со стоимостью 2.
В
процессе работы описанного алгоритма
на некотором этапе получим

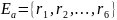 ,
 ;
затем ветвление будет продолжаться до
тех пор, пока мы не найдем решение,
которое лучше, чем текущее
,
либо не установим, что S1
и S3
не могут одновременно появляться в
оптимальном решении.
Далее, через много шагов, мы достигаем такой ситуации, когда

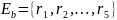 ,

Здесь
становится ясным, что дальнейшее
ветвление делать не нужно, поскольку
 и
 .
Подобная картина наблюдается и при
 ,

Таким
образом имеет смысл хранить для каждого
значения z=1,2,
…,
некоторый список максимальных множеств
E,
которые уже получены для данных z
(где под максимальным понимается такое
множество, которое не содержится в
другом множестве из этого списка). Эти
списки множеств E
путем элиминации тех ветвлений, которые
позже оказываются бесполезными. Пусть
мы сохранили некоторый список
 множеств E,
которые были получены в процессе
выполнения алгоритма на некотором
уровне с суммарной стоимостью
 .
Предположим, что на данном этапе
 ,
 ,
 и мы заняты исследованием блока k
(где
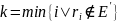 - см. шаг 2 алгоритма) и выбором множества
 со стоимостью
 для следующего ветвления. Если
 ,
то ветвление в рассматриваемом алгоритме
с этого этапа продолжается дальше и
 ,
 ,
 ,
независимо от каких-либо других соображений.
Однако можно гарантировать (на шаге 3), что перед продолжением ветвления
 ,
 и при всех
,
для которых
 .
(4)
Если
не удовлетворяет приведенному выше
условию, то оно отбрасывается и
рассматривается следующее множество
 блока k,
и т.д. Если
удовлетворяет условию (4), то можно
продолжать ветвление дальше с
так же, как и раньше, но с обновленным
списком
 ,
полученным добавлением
 в
 .
Поскольку невозможно практически хранить полные списки , то должны быть использованы некоторые эвристические критерии для определения размеров этих списков и способов их обновления в процессе поиска.
На
некотором этапе поиска, определяемом
 и когда блок k
является следующим блоком, подлежащим
рассмотрению, нижняя граница h
для наименьшего значения величины z
может быть вычислена и использована
для ограничения дерева поиска следующим
образом.
Рассмотрим
некоторый элемент
 ,
который отсутствует в множествах блоков
 ,
соответствующих элементам, еще не
покрытых частным решением. Тогда элемент
ri
не может быть покрыт, пока некоторое
множество
 блока i
не выбрано для добавления к B’
на следующем этапе. Итак, для каждого
такого элемента
 строится строка для матрицы
 и строка для второй матрицы
 ,
где
 равно числу элементов в множестве
 ,
а
 - стоимость множества
.
Кроме
того, к каждой матрице
 и
 добавляется дополнительная строка,
скажем
 ,
с
 для всех
 ,
 и
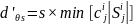
где
минимумом берется по всем множествам
таким, что
 .
Число элементов в строке
 матрицы
(или
)
может быть отлично от числа элементов
в другой строке
 .
Поэтому, добавив в конце строк 0 (нули)
и
 (бесконечности) соответственно для
матриц
и
,
добьемся того, чтобы число элементов в
разных строках стало одинаковым (например
 ),
а матрицы стали прямоугольными.
Теперь выскажем ряд утверждений. Поскольку оптимальное решение текущей подзадачи должно покрывать элементов, то, выбирая по одному значению из каждой строки матрицы с таким расчётом, чтобы удовлетворялось условие
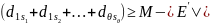
и минимизировалась соответствующая стоимость
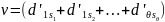 ,
мы
как раз и получим нижнюю границу для
оптимальной стоимости в подзадаче –
границей является найденное значение
 .
Здесь мы предполагали, что множества,
соответствующие элементам матрицы D,
расположенным в разных строках, не
пересекаются; такая ситуация является
наилучшей из возможных, т.к. реализация
защиты от определенной угрозы
осуществляется одним средством.
Последняя строка
просто гарантирует, что если
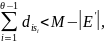
то оставшиеся элементы покрываются наилучшим образом, т.е. с минимальной стоимостью покрытия для каждого дополнительно покрываемого элемента.
Наименьшее
значение для
 при ограничении
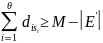
легко может быть получено с помощью следующего алгоритма динамического программирования.
Пусть
 – наибольшее число элементов, которые
могут быть покрыты только с помощью
первых
 строк матрицы D
(т.е. с использованием только
блоков задачи), причем общая стоимость
покрытия не превышает
.
Тогда
может быть найдено итерационным методом,
так как
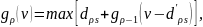

где
 придается начальное значение, равное
0 для всех v.
Следовательно,
наименьшее из значений величины v,
для которых выполняется неравенство
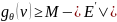 ,
как раз будет требуемой нижней границей
h;
оно может быть легко получено из таблицы
решения задачи динамического
программирования, составленной с
использованием приведенного выше
итерационного уравнения. Следует
отметить, что необходимо рассмотреть
только такие значения величины v.
для которых
 ,
поскольку если
 (т.е.
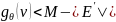 для
 ,
то можно сразу же сделать шаг возвращения.
Таким образом, предложенный способ формирования оптимальной структуры разрабатываемой СЗИ НСД позволяет реализовать СЗИ НСД, перекрывающую все возможные угрозы НСД, с наименьшими ресурсными затратами, если под «стоимостью» в алгоритме подразумевать задействие вычислительных ресурсов защищаемой системы, которые тем самым отвлекаются от выполнения задачи по прямому назначению.
Литература
1. Оптимальный синтез и анализ эффективности комплексов средств защиты информации: Монография / В.Г. Кулаков, В.Г. Кобяшев, А.Б. Андреев, А.Л. Линец, Ю.Е. Дидюк, О.Ю. Макаров, Е.А. Рогозин, Г.А. Остапенко, В.И. Белоножкин Воронеж: Воронеж. гос. техн. ун-т, 2004. - 181 с.
2. Майника Э., Алгоритмы оптимизации на сетях и графах – М.: Мир, 1981 – 324с.
3. Харари Ф., Теория графов – М.: Мир,1973 – 402 с
4. Кристофайдес Н., Теория графов. Алгоритмический подход – М.: Мир, 1978 – 429 с.
Воронежский государственный технический университет
УДК 681.3
С.В. Белокуров, А.А. Змеев, В.А. Хвостов, Р.А. Родин
Нормирование требований к основным элементам автоматизированной СИСТЕМЫ Информационной безопасности
В статье проанализированы структура и основные требования к основным элементам автоматизированной системы информационной безопасности
Поскольку
уровень автоматизированной системы
информационной безопасности (АС ИБ)
системы определяется уровнями ИБ ее
элементов [1], то возникает необходимость
рационального распределения заданных
требований по ИБ системы между ее
элементами. Первым шагом на пути решения
поставленной задачи является Анализ
функциональных схем АС и определение
ее основных элементов с таким расчетом,
чтобы соответствующий показатель уровня
безопасности SOF системы определялся по
формуле
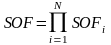 ,
где
 - показатель уровня безопасности i – го
основного элемента АС; N — количество
основных элементов, в системе.