Материал: Разработка математической модели, позволяющей прогнозировать расходы на перевозки в зависимости от увеличения грузооборота
СОДЕРЖАНИЕ
1. Расчет параметров уравнений линейной и нелинейной парной регрессии
регрессия корреляция математический
1.1 Расчет параметров линейной парной регрессии
.2 Расчет параметров степенной парной регрессии
.3 Расчет параметров показательной парной регрессии
2. Дисперсионный анализ линейной и степенной функции регрессии
4. Оценка ошибки аппроксимации уравнений регрессии
6. Оценка статистической надежности результатов линейного регрессионного моделирования
7. Расчет прогнозного значения расходов на перевозки по линейной модели при увеличении грузооборота
8. Реализация решенных задач на компьютере
.1 Реализация процедуры «ЛИНЕЙН»
.2 Реализация процедуры «Анализ данных»
4. Оценка ошибки аппроксимации уравнений регрессии
Из графиков и приведенных в таблицах расчетных данных следует, что фактическое значение расходов на перевозки y отличается от теоретического значения ŷx, рассчитанных по одному из уравнений регрессии. Очевидно, чем меньше это отличие, тем ближе опытные данные к теоретическим значениям и тем лучше качество модели.
Величина, представляющая собой разность опытного и теоретического
результативного признака (y - ŷx) для каждого опыта представляет
собой ошибку аппроксимации функции, связывающей расходы на перевозки и
грузооборот. В данном случае число таких опытов равно 17. Для оценки каждого
опыта используются не сами разности, а абсолютные значения разностей опытного и
теоретического результативных признаков, отнесенные к опытному признаку и выраженные
в процентах, то есть:
Аi = |(yi - ŷxi) / yi | ∙ 100% .
Оценка качества всей функции регрессии может быть осуществлена как
средняя ошибка аппроксимации - средняя арифметическая Аi:
А = (А1 + А2 + … + А17 ) / 17.
Найдем величину средней ошибки аппроксимации линейной функции связи между расходами на перевозки и грузооборотом: А = 275,3 / 17 = 46,6 %.
Аналогично получим среднюю ошибку аппроксимации для степенной функции: А = 38,8 / 17 = 20,09% и для показательной функции: А = 164,09 / 17 = 48,6%.
Таблица 4.1
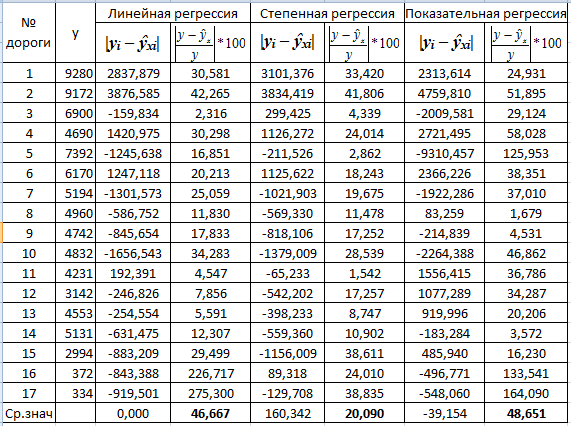
Их анализ показывает, что ошибка аппроксимации находится в допустимых для
практического использования пределах, с теоретической точки зрения может быть
продолжен поиск более качественной функции регрессии.
5. Сравнительная оценка силы связи грузооборота с расходами на перевозки с помощью среднего коэффициента эластичности
Средний коэффициент эластичности Э показывает, на сколько процентов в
среднем изменятся расходы на перевозки ŷx от своей средней величины при изменении грузооборота x на 1% от своего среднего значения.
Для произвольной величины x он
может быть вычислен по следующей формуле:
Э = yx' (x)·  / ŷx.
С учетом приведенной формулы средний коэффициент эластичности Э для линейной функции регрессии ŷx = 1186,047+0,058 · x
примет следующий вид:
 = ŷx' (x) ·
 / ŷx= b ·
 / (a + b) .
Средний коэффициент эластичности для степенной функции:
= b, он
составляет:  .
Средний коэффициент эластичности для показательной функции:
В таблицах 5.1, 5.2, 5.3 вычислены коэффициенты эластичности для линейной, степенной и показательной функций регрессии соответственно:
Таблица 5.1
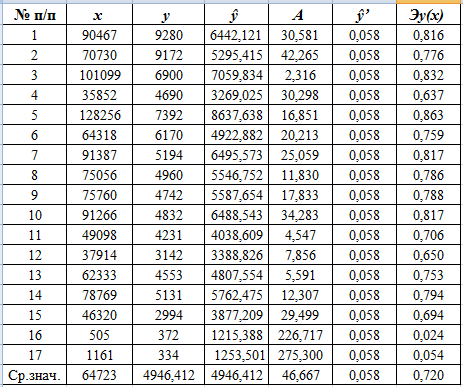
Таблица 5.2
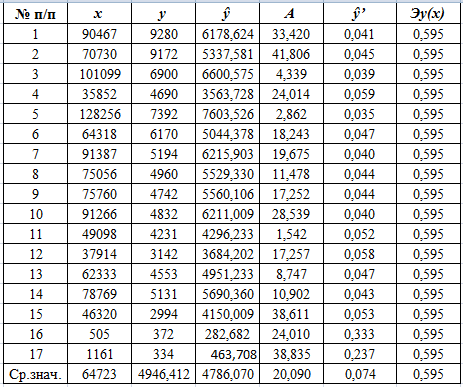
Таблица 5.3
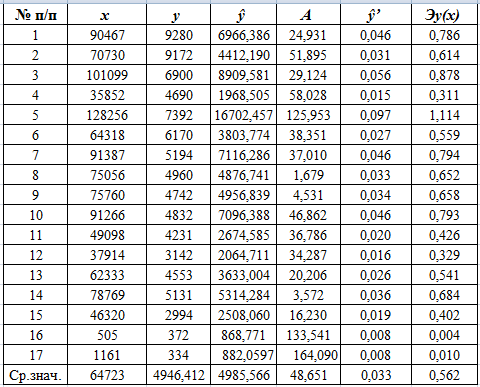
Анализ разработанных математических моделей показывает, что увеличение на
1% грузооборота, например, Московской железной дороги (№2), приводит к
увеличению на 0,776; 0,595; 0,614% расходов на перевозки. При этом по линейной
модели это увеличение составляет 0,78%, по степенной функции регрессии - 0,59%,
по показательной функции регрессии - 0,78%.
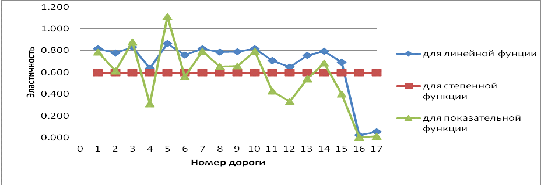
Рис. 5.1 «Значения коэффициентов эластичности линий линейной, степенной и показательной функций регрессии»
6. Оценка статистической надежности результатов линейного регрессионного моделирования
Оценку статистической надежности уравнения регрессии в целом будем
производить с помощью F-критерия
Фишера. При этом примем нулевую гипотезу H0, что коэффициент регрессии b равен нулю. В таком случае фактор x не оказывает влияния на результат y, то есть грузооборот не оказывает влияния на расходы на
перевозки. Альтернативная гипотеза H1 будет состоять в статистической надежности линейного регрессионного
моделирования. Для установления истинной значимости линейной модели необходимо
выполнить сравнение факторного Fфакт
и критического (табличного) Fтабл
значений F-критерия Фишера. Факторный F-критерий Фишера вычисляется по
формуле:
Fфакт
= Sфакт2 / Sост2,
где Sфакт2 - факторная выборочная
дисперсия, вычисленная на одну степень свободы по соотношению:
Sфакт2
= ((ŷx1 -  )2 + (ŷx2 - )2 + ...+ (ŷx17 - )2) / 1;
Sост2
- остаточная выборочная дисперсия, вычисленная на одну степень свободы по
соотношению:
Sост2
= ( (y1 - ŷx1)2 + (y2 - ŷx2)2 + ...+ (y17 - ŷx17)2
)/ n - 2.
Если нулевая гипотеза справедлива, то факторная и остаточная выборочные дисперсии не отличаются друг от друга. Для опровержения нулевой гипотезы H0 необходимо, чтобы факторная дисперсия превышала остаточную дисперсию в несколько раз. Табличное Fтабл значение F-критерия Фишера - это максимальная величина критерия (отношения дисперсий) под влиянием случайных факторов при данных степенях свободы и уровне значимости α, который примем равным 0,05.
Если Fтабл < Fфакт , то нулевая гипотеза о случайной природе коэффициента регрессии, а следовательно, и оцениваемой модели отвергается и признается их статистическая значимость и надежность. Если Fтабл > Fфакт, то нулевая гипотеза не отклоняется и признается статистическая незначимость и ненадежность уравнения регрессии.
По таблице значений F-критерия Фишера при уровне значимости α = 0,05 и степенях свободы k1 = 1, k2 = 15 получаем Fтабл = 4,54. Выполнив расчет, получим Fфакт = 2441938,544 / 61451245,963 = 25,16.
Полученные значения F-критерия
Фишера указывают, что Fтабл
< Fфакт, поэтому необходимо отвергнуть
нулевую гипотезу о случайной природе коэффициента регрессии.
7. Расчет прогнозного значения расходов на перевозки по линейной модели при увеличении грузооборота
Полученное уравнение линейной регрессии позволяет использовать его для прогноза. Согласно заданию на курсовую работу, следует рассчитать прогнозное значение расходов на перевозки, если прогнозное значение грузооборота железной дороги увеличится на 10% от среднего значения всех дорог. При этом установить доверительный интервал прогноза для уровня значимости, равного 0,05.
Если прогнозное значение грузооборота составит:
= 1,1 · = 1,1 ·64723 = 71195,3 млн.ткм
то прогнозное точечное значение расходов на перевозки можно вычислить по
соотношению:
ŷx = 1186+0,058· xр = 1186+0,058 · 71195,3 =
=5322,45 млрд.руб.
Для определения доверительного интервала прогноза расходов на перевозки необходимо вычислить ошибку прогноза по формуле:
ŷp = Sост · (1 + 1 / 17 + ( xp - )2/( (x1 - )2 + (x2 - )2 + ... + (x17 -- )2))1/2 = 1562,67· (1 + 1/17 +
(71195,3 -64723)2 /18204892818)1/2 = 0,0006
Предельная ошибка прогноза, которая с вероятностью 0,95 не будет
превышена, составит:
∆ŷp = tтабл · mŷp =2,131 · 0,0006 = 0,0012.
Здесь tтабл - табличное значение t-статистки Стьюдента для числа степеней свободы n - 2 = 15 и уровне значимости 0,05 равное tтабл = 2,131.
Тогда предельные значения доверительного интервала прогноза расходов на
перевозки при прогнозируемом увеличении грузооборота на 10% можно вычислить по
формулам:
ŷxp min = ŷxp - ∆ŷp =5322,45 - 0,0012=5322,4470 млрд.руб.;
ŷxp max = ŷxp + ∆ŷp =
5322,45 + 0,0012=5322,4494 млрд.руб.
Выполненный прогнозный расчет по линейной регрессионной модели показал,
что с вероятностью 0,95 она достаточно точна. Выполненный прогноз расходов на
перевозки является надежным и находится в пределах от 5322,4470 млрд.руб. до
5322,4494 млрд.руб.
8. Реализация решенных задач на компьютере
Определение линейной функции регрессии выполним с помощью ППП Excel.
.1 Реализация процедуры «ЛИНЕЙН»
Статистическая функция ЛИНЕЙН позволяет вычислить параметры линейной
регрессии:
ŷx = a + b · x .
Вся регрессионная статистика будет выводиться по схеме:
|
Значение коэффициента b |
значение коэффициента а |
|
Среднеквадратическое отклонение b |
среднеквадратическое отклонение а |
|
коэффициент детерминации |
среднеквадратическое отклонение y |
|
F-статистика |
число степеней свободы |
|
регрессионная сумма квадратов |
остаточная сумма квадратов |
Алгоритм вычисления регрессионной статистики включает следующие этапы:
) подготовку исходных данных;
) выделение области пустых ячеек 5 ´ 2 для вывода результатов регрессионной статистики;
) активизацию Мастера функций одним из способов:
а) в главном меню выбрать ВСТАВКА/ФУНКЦИЯ;
в) на панели СТАНДАРТНАЯ щелкнуть по кнопке ВСТАВКА ФУНКЦИИ;
) в окне КАТЕГОРИЯ выбрать СТАТИСТИЧЕСКИЕ, в окне ФУНКЦИЯ - ЛИНЕЙН; затем щелкнуть по кнопке ОК;
) заполнить аргументы функции;
) в левой верхней ячейке выделенной области появится первый элемент итоговой таблицы. Для раскрытия всей таблицы необходимо нажать на клавишу F2, затем нажать комбинацию клавишей CTRL + SHIFT + ENTER.
Ниже приводятся результаты регрессионной линейной математической модели
расходов на перевозки в зависимости от грузооборота 17 дорог по статистическим
данным Рф.
|
Значение коэффициента b 0,058099351 |
Значение коэффициента a 1186,047451 |
|
Среднеквадратическое отклонение b 0,011581726 |
Среднеквадратическое отклонение а 839,9700701 |
|
Коэффициент детерминации 0,626539997 |
Среднеквадратическое отклонение y 1562,670325 |
|
F-статистика 25,1649437 |
Число степеней свободы 15 |
|
Регрессионная сумма квадратов 61451245,96 |
Остаточная сумма квадратов 36629078,15 |
.2 Реализация процедуры «Анализ данных»
Для активизации надстройки «Пакет анализа» необходимо открыть меню «Сервис» и щелкнуть по строке «Надстройки…». В открывшемся меню следует отметить строку «Пакет анализа» и подтвердить выбор кнопкой «ОК».
Инструмент анализа «Регрессия» пакета анализа данных Excel позволяет по введенным
статистическим данным получить значения выборочных коэффициентов корреляции и
детерминации, стандартного отклонения; разложения общей суммы квадратов на
объясненную и остаточную, расчетное значение  -статистики и уровень значимости на
котором расчетная -статистика равняется соответствующей табличной величине;
значения регрессионных параметров, их стандартные ошибки, и
 -статистики; таблицу теоретических
значений и величины их отклонений от опытных данных; график статистических
данных с линией регрессии и график остатков; и другие статистические оценки.
Вызов опции «Регрессия» осуществляется через надстройку «Анализ данных…» меню «Сервис».
Вызов надстройки «Анализ данных…» приведет к появлению списка инструментов анализа. В этом списке необходимо выбрать «Регрессия» и подтвердить выбор нажатием кнопки «ОК».
Интерфейс инструмента анализа «Регрессия» представляет собой диалоговое
окно, в верхней части которого следует ввести статистические данные результирующей
переменной в поле «Входной интервал Y» и данные фактора в поле «Входной
интервал X». При необходимости построения
уравнения регрессии вида  нужно задать параметр «Константа-ноль». Параметр «Уровень
надежности» в процентах определяет величину доверительной вероятности
 . В качестве выходного интервала
удобно задать адрес ячейки непосредственно рядом с таблицей исходных данных.
Рекомендует активизировать параметры «Остатки» (таблица теоретических значений
результирующего показателя и соответствующие значения остатков), «График
остатков» (график отклонений теоретических значений результирующего показателя
от его опытных значений) и «График подбора» (график статистических данных с соответствующими
теоретическими величинами, вычисленными по уравнению регрессии).