Дипломная (вкр): Статистический анализ безработицы в Российской Федерации
Далее производится проверка всех факторов на нормальный закон
распределения (приложение 1), используя одновыборочный критерий Колмогорова-Смирнова.
Мы проверяем гипотезу  о том, что каждая переменная является нормально
распределённой на уровне значимости α=0,05, при конкурирующей гипотезе
 (
 не принадлежит нормальному закону
распределения).
Таблица 1
Одновыборочный критерий Колмогорова-Смирнова
|
|
y |
x1 |
x2 |
x3 |
x4 |
x5 |
x6 |
x7 |
x8 |
x9 |
x10 |
x11 |
x12 |
x13 |
x14 |
|
N |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
80 |
|
Сред. |
0,00 |
0,00 |
0,00 |
0,00 |
0,02 |
0,00 |
0,02 |
0,02 |
0,03 |
0,03 |
0,02 |
0,02 |
0,00 |
0,00 |
0,00 |
|
Стд. Откл. |
1,01 |
1,01 |
1,01 |
1,01 |
0,99 |
1,01 |
0,99 |
0,99 |
0,99 |
0,99 |
0,99 |
0,99 |
1,01 |
1,01 |
1,01 |
|
Статистика Z Колмогорова-Смирнова |
0,74 |
1,34 |
0,98 |
0,80 |
1,00 |
0,85 |
1,00 |
0,73 |
0,65 |
0,91 |
0,98 |
0,48 |
0,92 |
1,15 |
1,96 |
|
Асимпт. знч. (двухсторонняя) |
0,64 |
0,06 |
0,30 |
0,55 |
0,27 |
0,46 |
0,27 |
0,66 |
0,80 |
0,38 |
0,29 |
0,98 |
0,36 |
0,14 |
0,00 |
На основании получившихся значений, можно сделать вывод о том, что
гипотеза о принадлежности каждой переменной нормальному закону распределения не
отвергается на уровне значимости α=0,05, за исключением  . Т.е. переменные
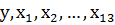 - нормально распределённые величины.
Таким образом, предпосылка регрессионного анализа о нормальности распределения
показателей выполняется, и мы можем переходить к следующему этапу исследования
( мы также включим пока в анализ ввиду
предположения о влиянии размера среднемесячной заработной платы в регионе на
уровень безработицы).
Перед тем как воспользоваться методом регрессионного анализа необходимо выяснить, какие факторы из вышеперечисленных было бы целесообразнее всего использовать для включения в модель. Зачастую, включение большего количества показателей в модель не улучшают её статистические свойства, а наоборот ухудшают, ввиду, к примеру, наличия мультиколлинеарности между переменными. Наиболее обоснованным методом для выбора факторов является.
Корреляционный анализ является одним из методов статистического анализа взаимозависимости нескольких признаков. На данный момент, он определяется как метод, применяемый в случае, когда наблюдение считается случайным и выбранным из генеральной совокупности, распределённой по многомерному нормальному закону распределения. Основной задачей данного анализа является оценка корреляционной матрицы генеральной совокупности по выборке и определении частных и множественных коэффициентов корреляции и детерминации на её основе оценок. Другими словами, корреляционный анализ позволяет обработать статистические данные, с целью измерения тесноты связи между двумя или более переменными.
Для определения необходимости включения в уравнение множественной
регрессии тех или иных факторов, а также для оценки полученного уравнения на
соответствие выявленным связям (используя коэффициент детерминации) мы построим
матрицу парных коэффициентов корреляции  :
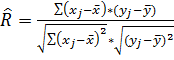 , где
 , а
 .
Согласно корреляционной матрице (приложение 2), на уровне 0,01 оказались значимыми корреляции между уровнем безработицы и средним временем поиска работы безработными (связь является положительной), удельным весом городского населения в общей численности населения (отрицательная зависимость), коэффициентом пенсионной нагрузки (отрицательная взаимосвязь), общими коэффициентами рождаемости (коэффициент имеет положительный знак), коэффициентами миграционного прироста (отрицательная взаимосвязь), удельным весом домохозяйств, имевших персональный компьютер с доступом к сети Интернет (коэффициент корреляции отрицателен), а также среднемесячная номинальная начисленная заработная плата работников организаций (корреляция является также отрицательной). В то же время, на уровне 0,05 значима связь между уровнем безработицы и такими показателями как индекс потребительских цен и мощность амбулаторно-поликлинических учреждений.
Надо заметить, что коррелированных между собой показателей достаточно много, однако при этом мультиколлинеарность между факторами не наблюдается. Таким образом, в регрессионную модель могут войти все переменные, кроме показателей удельного веса убыточных организаций (х2), ожидаемой продолжительности жизни при рождении (х6), общих коэффициентов брачности (х7), индекса физического объема инвестиций в основной капитал (х9), ввода в действие жилых домов (х10).
После проведения корреляционного анализа у нас остались 9 переменных, которые имеют значимую корреляцию на том или ином уровне значимости. Однако включение всех этих факторов в модель может оказаться бессмысленным и увеличение такой характеристики качества построенной модели как коэффициент детерминации может быть результатом добавления в модель большого количества регрессоров. Таким образом, проверим оставшиеся переменные на существенность их включения с помощью дисперсионного анализа.
Дисперсионный анализ предназначен для проверки зависимостей нормально распределённой случайной величины, являющейся результативным признаком, от нескольких величин - факторных признаков, или факторов, среди которых могут быть как случайные, так и неслучайные величины, измеряемые в любой из шкал: интервальной, порядковой или номинальной.
В работе приведён анализ однофакторного комплекса. По очереди изучается влияние 9 факторов на уровень безработицы в Российской Федерации. Исследование существенности влияния каждого фактора на уровень безработицы в РФ заключается в проверке основной гипотезы дисперсионного анализа: уровни факторного признака не влияют на изменение результативной переменной. В данной работе все расчеты производятся на уровне значимости 0,05. Сведем результаты всех расчетов в одну таблицу (приложение 3) и проверим значимость влияния каждого признака в отдельности с помощью F-статистики.
Таким образом, для переменных х1, х5, х8, х11 и х13 наблюдаемое значение F-статистики превосходит ее критическое значение, т.е. гипотеза о несущественности влияния фактора на изменение результативного признака отвергается с вероятностью ошибки, равной 0,05. Следовательно, можно считать, что следующие переменные существенно влияют на уровень безработицы РФ:
· среднее время поиска работы безработными (месяцев);
· общие коэффициенты рождаемости (число родившихся на 1000 человек населения);
· коэффициенты миграционного прироста на 10000 человек населения;
· удельный вес домохозяйств, имевших персональный компьютер с доступом к сети Интернет;
· мощность амбулаторно-поликлинических учреждений на 10000 человек населения (на конец года, тысяч посещений в смену).
В результате проведенных корреляционного и дисперсионного анализов мы определили, какие переменные далее будут включены в регрессионный анализ, для проверки их статистической значимости. Далее необходимо предоставить дескриптивные статистики для каждой переменной, описать математическую модель зависимости показателей, построить уравнение регрессии, описывающее изменение коррелируемых величин и определяющее среднее значение результативного признака при каком-либо значении факторного.
Переобозначим все оставшиеся переменные, которые будут использованы в последующем анализе. Так, зависимым признаком будет являться уровень безработицы в РФ (Y), а независимыми - следующие, упомянутые выше показатели:
х1. среднее время поиска работы безработными (месяцев);
х2. общие коэффициенты рождаемости (число родившихся на 1000 человек населения);
х3. коэффициенты миграционного прироста на 10000 человек населения;
х4. удельный вес домохозяйств, имевших персональный компьютер с доступом к сети Интернет;
х5. мощность амбулаторно-поликлинических учреждений на 10000 человек населения (на конец года, тысяч посещений в смену).
Рассчитаем основные дескриптивные статистики для отобранных переменных и представим результаты в виде следующей таблицы:
Таблица 2
Описательные статистики
|
|
y |
x1 |
x2 |
x3 |
x4 |
x5 |
|
N |
80 |
80 |
80 |
80 |
80 |
80 |
|
Среднее |
7,18 |
8,04 |
12,69 |
0,64 |
48,11 |
265,07 |
|
Медиана |
6,95 |
7,85 |
12,40 |
-1,50 |
48,15 |
257,75 |
|
Стд. отклонение |
2,22 |
1,07 |
2,28 |
61,24 |
11,68 |
51,47 |
|
Минимум |
1,40 |
6,10 |
8,60 |
-121,00 |
13,60 |
113,90 |
|
Максимум |
14,20 |
12,10 |
22,70 |
160,00 |
75,60 |
495,60 |
В среднем, уровень безработицы в России по 80 регионам составляет по данным 2011 года 7,18%. При этом, в 40 регионах уровень безработицы держится ниже уровня 6,95%, что является относительно низким показателям в сравнении с имеющимися в предшествующих годах. Самая низкая безработица наблюдается в г. Москве, что, возможно, связано с тем, что в столицу люди приезжают именно с целью поиска работы и готовы принять наименее выгодные предложения ввиду необходимости денежных средств.
В России, среднее время поиска работы в 2011 году в среднем было чуть более 8 месяцев, при этом стандартное отклонение составляет всего 1 месяц. Таким образом, этот фактор является наиболее однородным, чего нельзя сказать о коэффициенте миграции. В данном случае отток населения из региона приблизительно равен притоку - среднее значение коэффициента составило всего 0,64. При этом, средний коэффициент рождаемости составил 12,69 родившихся на 1000 человек, что говорит об увеличении численности населения внутри самих регионов. Однако, чтобы оценить естественный прирост необходимо рассмотреть значения коэффициентов смертности.
Среднее и медианное значения удельного веса домохозяйств, имеющих компьютер с выходом в Интернет составили в 2011 году 48%, что говорит о том, что половина населения имеет возможность искать и иметь удаленную работу, что вероятнее всего положительным образом сказывается на общем уровне безработицы. Лучше всего информационно оснащен г. Санкт-Петербург, а после него идет г. Москва, что является достаточно логичным, так как данные регионы считаются наиболее экономически развитыми. Всего 13,6% населения имеют выход в Интернет в республике Дагестан, что связано, скорее всего, с их текущим экономико-политическим положением в регионе.
Описав все факторы можно переходить к непосредственному построению математической модели. Следует еще раз заметить, что для анализа мы используем нормированные величины каждой переменной, чтобы уменьшить вариацию каждого признака и сделать их более однородными (привести к одной размерности).
Существует несколько видов уравнений регрессии. В рамках данной работы мы
будем анализировать множественную модель линейной регрессии ввиду её простоты и
ясности интерпретации. Данная модель выглядит следующим образом: 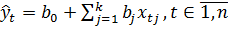 , где t - это номер наблюдения в выборке, а j - номер фактора.
 - является коэффициентом регрессии,
который определяет, на сколько изменится результирующий признак у при изменении
факторного признака
 на единицу. Для определения параметров
 и чаще всего используют метод наименьших
квадратов, который основан на том, что теоретические значения результативного
признака должны быть такими, при которых бы обеспечивалась минимальная сумма
квадратов их отклонений от эмпирических значений, что можно представить в виде
формулы:
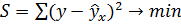 .
Таким образом, используя алгоритм шагового отбора, мы построили следующую
линейную модель регрессии:
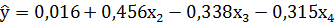
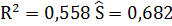
Проверка на значимость данного уравнения регрессии, используя F-статистику, а также проверка за
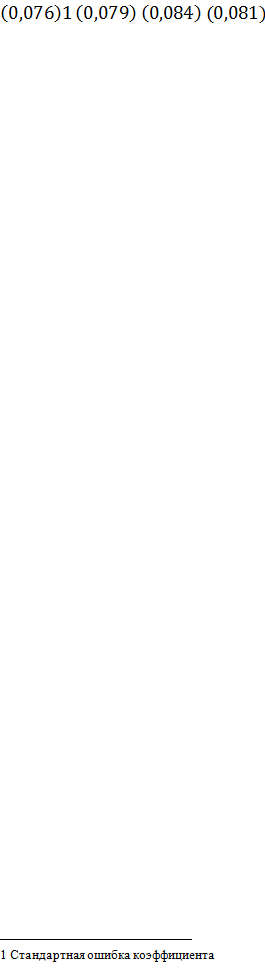
значимость отдельных его коэффициентов с помощью t-статистики показала, что в обоих случаях гипотеза о
незначимости отвергается на уровне  . Кроме того, множественный
коэффициент детерминации показывает, что данное уравнение регрессии описывает
55,8% вариации результирующего признака вошедшими в модель показателями, а
остальная часть вариации обусловлена действием неутонченных факторов.
Из полученного уравнения следует, что увеличение на одну нормированную единицу общего коэффициента рождаемости (при фиксированных значениях х3 и х4) приводит к увеличению уровня безработицы в среднем на 0,456 (в нормированных единицах). Аналогично, при увеличении на одну нормированную единицу коэффициента миграционного прироста и удельного веса домохозяйств, имеющих компьютер с выходом в Интернет, уровень безработицы снижается в среднем (в нормированных единицах) соответственно на 0,338 (при фиксированных значениях х2 и х4 ) и 0,315 (при фиксированных значениях х2 и х3). Стоит отметить, что также была построена модель с принудительным включением всех переменных, однако согласно статистическим тестам, она оказалась незначимой.