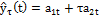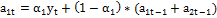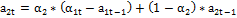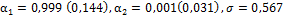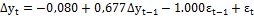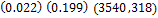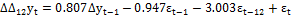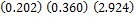Дипломная (вкр): Статистический анализ безработицы в Российской Федерации
Для того, чтобы быть уверенным в том, что модель адекватно отражает статистическую связь между показателями, остатки (приложение 5) оцененной регрессии необходимо проверить на нормальность, гомоскедастичность и отсутствие автокорреляции.
Проверка на нормальность распределения остатков с помощью одновыборочного критерия Колмогорова-Смирнова показала, что с 95% уверенностью мы можем сказать, что остатки являются нормально распределенными (приложение 6).
Тестирование остатков на гомоскедастичность, что дает нам право полагать
об эффективности полученных МНК-оценок и несмещенности и состоятельности оценки
ковариационной матрицы этих параметров, основано на предположении о том, что
при условии выполнения гипотезы  дисперсия ошибок не зависит от значений регрессоров. В данном
случае, наблюдаемое значение в рамках теста Бреуша-Пагана-Годфри (приложение 7)
не превысило критическое, т.е. гипотеза об отсутствии гетероскедастичности
ошибок принимается на уровне значимости 0,05.
В заключение, с помощью теста Дарбина-Уотсона, построенная модель была
проверена на наличие автокорреляции остатков первого порядка, наличие чего
может привести также к неэффективности МНК-оценок и к завышению тестовых
статистик, по которым проверяется качество модели. Рассчитанная статистика
данного теста показала, что нулевая гипотеза Н0 о незначимости
коэффициента авторегрессии принимается на уровне значимости  .
В результате корреляционно-регрессионного анализа данных за 2011 год мы получили статистически значимую и адекватную модель. Согласно данной модели уровень безработицы положительно зависит от общего коэффициента рождаемости и отрицательно от коэффициента миграции и удельного веса домохозяйств, имеющих персональный компьютер с выходом в Интернет.
Положительную зависимость уровня безработицы от числа родившихся на 1000 человек населения (что имеет наибольшее влияние на результирующую переменную при прочих равных) можно объяснить с нескольких точек зрения. Во-первых, растет число человек в регионе, а новые рабочие места не открываются. Более того, в течение последнего десятилетия стали закрываться большие промышленные организации, которые зачастую предоставляли вакантные места для целых городов или поселений. Однако это скорее оказывает влияние в долгосрочной перспективе. С другой стороны, увеличивается число рождений, а следовательно, женщин, оставивших в связи с родами и последующим уходом за грудным ребёнком свое прежнее место работы. По прошествии некоторого времени, эти женщины начинают обращаться в биржи труда с целью поиска работы, тем самым увеличивая уровень безработицы в регионе.
Отрицательная зависимость между уровнем безработицы и коэффициентом миграционного прироста в регионе, то есть при положительном приросте миграции уровень безработицы сокращается, связана с тем, что миграция зачастую связана именно с работой. Другими словами, те люди, которые меняют свое место жительство, часто мигрируют туда, где либо они уже нашли место работы, либо туда, где они намерены устроиться на неё. Таким образом, в регионе уровень безработицы снижается за счет увеличения рабочей силы в общем и числа занятых в частности.
Наличие значимой обратной зависимости между уровнем безработицы и долей домохозяйств, имеющих персональный компьютер с выходом в Интернет, подтверждает выдвинутое в начале анализа предположение о том, что данный фактор оказывает влияние на результирующий показатель. Во-первых, это связано с тем, что, как уже было описано выше, Интернет позволяет «стереть» километры между потенциальным работником и работодателем, например, имея возможность работать над проектами удаленно. Во-вторых, глобальная сеть помогает найти работу, минуя биржу труда, контактируя с работодателем напрямую, тем самым позволяя найти работу, на устраиваемых безработного условиях.
3.1.2 Компонентный анализ
Стремление описать экономическое явление всегда приводит к рассмотрению большого количества исходных переменных, что в итоге вытекает к ненаглядной модели, оценки которой являются неэффективными. В данном случае сначала были выдвинуты к рассмотрению четырнадцать переменных, которые на первый взгляд оказывают влияние на уровень безработицы. Однако, в ходе корреляционно-регрессионного анализа мы получили модель, в которую вошли три переменные из предположенных в начале анализа. Но, несмотря на то, что данная модель описывает около 56% вариации результирующего признака, исключение не вошедших в модель переменных могло повлечь за собой потерю информации.
Для того чтобы построить наглядную модель, исключая незначимые факторы и максимально сохранив информацию и структуру исходных данных применяются такие способы снижения размерности как компонентный анализ. Отличительной особенностью такого анализа является то, что, во-первых, главные компоненты имеют нулевую корреляцию между собой, а во-вторых появляется возможность выявить неявные, непосредственно не измеряемые, но объективно существующие закономерности, которые обусловлены действием как внутренних, так и внешних причин.
Модель компонентного анализа имеет вид: 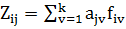 , где
 - «вес», факторная нагрузка, v-ой
главной компоненты на j-ой переменной;
 - значение v-ой главной компоненты
для i-го наблюдения (объекта), где v=1,2,…,k. Для анализа будут выбраны все 14
факторов, вероятно влияющих неким образом на уровень безработицы. Однако,
количество главных компонент, включенных в окончательную модель, будут
определены их вкладом в суммарную дисперсию.
В ходе компонентного анализа получили следующие результаты полной
объяснённой дисперсии:
Таблица 3
Результаты полной объясненной дисперсии
|
Компонента |
Начальные собственные значения |
||
|
|
Итого |
% Дисперсии |
Кумулятивный % |
|
1 |
3,456 |
24,685 |
24,685 |
|
2 |
2,826 |
20,183 |
44,868 |
|
3 |
1,648 |
11,771 |
56,638 |
|
4 |
1,163 |
8,304 |
64,942 |
|
5 |
1,039 |
7,421 |
72,363 |
|
6 |
0,865 |
6,176 |
78,539 |
|
7 |
0,768 |
5,489 |
84,028 |
|
8 |
0,608 |
4,340 |
88,369 |
|
9 |
0,447 |
3,191 |
91,560 |
|
10 |
0,363 |
2,593 |
94,153 |
|
11 |
0,300 |
2,146 |
96,299 |
|
12 |
0,258 |
1,841 |
98,140 |
|
13 |
0,149 |
1,062 |
99,201 |
|
14 |
0,112 |
0,799 |
100,000 |
Считается, что можно ограничиться несколькими первыми главными компонентами, если их суммарная объясненная дисперсия превышает 70%. Как видно из таблицы 3, кумулятивный процент объясненной дисперсии первых пяти компонент составляет 72,4%, что является достаточным для использования их в дальнейшем анализе.
Одним из недостатков компонентного анализа является достаточно сложная смысловая интерпретация главных компонент. Однако рассмотрим с какими переменными тесно связана каждая из них (приложение 8) и попробуем их проинтерпретировать.
Первая главная компонента (z1), согласно соответствующей матрице, тесно связана со следующими переменными: среднее время поиска работы безработными, удельный вес городского населения в общей численности населения, ожидаемая продолжительность жизни при рождении, общие коэффициенты брачности на 1000 человек населения, удельный вес домохозяйств, имевших персональный компьютер с доступом к сети Интернет, мощность амбулаторно-поликлинических учреждений на 10000 человек населения и среднемесячная номинальная начисленная заработная плата работников организаций. Таким образом, данная компонента отражает социально-экономическую сторону жизни безработных.
Вторая главная компонента (z2) имеет тесную связь с коэффициентами пенсионной нагрузки, рождаемости и миграционного прироста. Другими словами, она описывает демографические процессы в регионах.
Третья (z3) и четвертая (z4) компоненты тесно связаны с вводом в действие жилых домов на 1000 человек населения и с индексом потребительских цен соответственно. Таким образом, их можно проинтерпретировать как обеспеченность жильем и инфляция.
Последняя, пятая главная компонента (z5) имеет тесную связь с удельным весом убыточных организаций, а также с индексом физического объема инвестиций в основной капитал. Ввиду отношения обеих переменных к организациям данная компонента может быть проинтерпретирована как экономическое положение организаций.
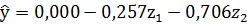
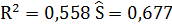
Если проверить данное уравнение на значимость с помощью F-cтатистики Фишера и его коэффициенты - с помощью t-критерия Стьюдента, то во всех случаях отвергается гипотеза о незначимости коэффициентов и уравнения в целом на 95%-ом уровне значимости. Незначимой является только константа, значение которой стремится к нулю.
Остатки данной модели (приложение 10), согласно одновыборочному критерию Колмогорова-Смирнова, являются нормально распределенными. Кроме того, тест Бреуша-Пагана-Годфри на отсутствие гетероскедастичности остатков показал, что остатки гомоскедастичны. В заключение, остатки были проверены на независимость, используя статистику Дарбина-Уотсона, которая указала на отсутствие автокорреляции первого порядка. Таким образом, построенную линейную регрессию на первые две главные компоненты можно считать адекватной.
Как было уже упомянуто выше, возникают затруднения при интерпретации модели, построенной на главные компоненты. Можно отметить, что при увеличении значения компоненты, характеризующей социально-экономическое положение безработных на 1, нормированное значение уровня безработицы уменьшится на 0,257 единиц. Большее влияние оказывает главная компонента, наиболее тесно связанная с демографическими процессами в регионе: при увеличении соответствующей главной компоненты на 1, нормированный уровень безработицы сокращается на 0,706 единиц.
Если сравнивать регрессию, построенную на главные компоненты и на три определенных фактора, то вторая оказывается более удачной, с точки зрения простоты и ясности интерпретации. Кроме того, если сравнивать скорректированные коэффициенты детерминации, которые учитывают разное количество регрессоров в уравнениях, то в первом случае (регрессия на компоненты) он составляет 0,547 а во втором 0,540. Другими словами, построение модели, используя главные компоненты в качестве факторов, не улучшило полученных ранее результатов. Более того, этот анализ еще раз подтвердил результаты предыдущей модели, так как вторая компонента содержит факторы x2 и x3 (коэффициенты рождаемости и миграционного прироста), а x4 (удельный вес домохозяйств, имеющих персональный компьютер с доступом в Интернет) входит в состав первой главной компоненты.
3.2 Анализ динамики уровня безработицы в России
Представим для начала еще раз имеющийся ряд динамики уровня безработицы в
Российской Федерации за период с января 1994 по март 2013 года:
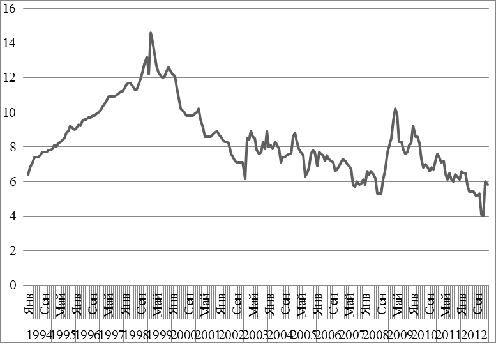
Рис. 5. Уровень безработицы в России (январь 1994 - март 2013)
Если взглянуть на рисунок 5, то визуально весь период можно разделить на
три сектора, в каждом из которых выделяется своя тенденция. В связи с этим, а
также ввиду громоздкости анализа большого массива данных, далее будет
рассмотрена только его часть, а именно период с января 2009 года по март 2013
года. Во-первых, к данному моменту времени кризис уже немного «утих», а
во-вторых, исследование именно этого периода времени позволит нам построить
более точный краткосрочный прогноз будущих значений уровня безработицы в
России.
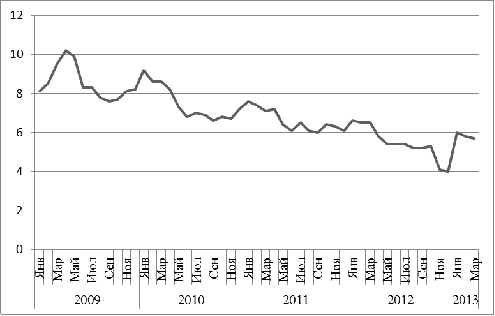
Рис. 6. Ряд динамики уровня безработицы в РФ
(январь 2009 - март 2013)
По представленному графику возможно предположить о том, что данный ряд динамики может быть описан с помощью мультипликативной модели. Кроме этого анализ графика позволяет сделать предположения о наличие тренда, сезонности и случайной компоненты.
Для начала проверим гипотезу о том, что в данном временном ряду
присутствует тренд. Для этой цели существует несколько подходов, в частности, в
рамках работы мы использовали метод Фостера-Стюарта. В основе данного подхода
лежит нулевая гипотеза об отсутствии тренда в динамике значений уровня
безработицы, а именно гипотеза 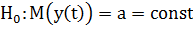 . Рассчитав t-статистики
для данного теста, мы получили, что выдвинутая гипотеза
 отвергается с вероятностью ошибки
 , т.е. мы подтвердили предположение,
которое было выдвинуто выше.
Далее переходим к анализу наличия сезонной компоненты в исследуемом ряду
динамики. Перед началом анализа влияния сезонности необходимо провести
сглаживание ряда. Для этого можно использовать простую скользящую среднюю с
длиной интервала, равной 12-ти наблюдениям. Формула для расчетов будет
выглядеть следующим образом: 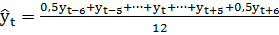 . При расчёте теряются несколько первых и последних значений,
которые восстанавливаются с помощью среднего абсолютного прироста,
рассчитанного на последнем активном участке сглаживания.
В ходе данного исследования индексы сезонности были рассчитаны по методу
отношений помесячных средних к средней месячной соответствующего года.
Предварительно мы избавились от тенденций в ряду путём деления исходного
значения уровня ряда на соответствующую тому же уровню рассчитанную скользящую
среднюю. Для большей наглядности мы изобразили полученные данные (приложение
11) на графике, где красная линия соответствует значению в 100%, а синяя -
соответствующие индексы сезонности:
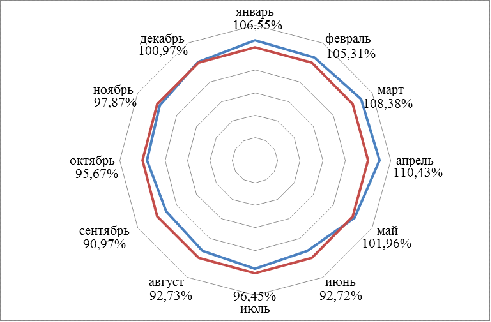
Рис. 7. Индексы сезонности уровня безработицы в России
Представленная диаграмма иллюстрирует смещение синего многоугольника в сторону зимнего и весеннего сезона. Таким образом, выдвинутое предположение о наличии сезонности в модели подтверждается, причём оно достаточно заметное. Такую сезонность можно объяснить следующим образом: люди в течение лета зарабатывают и копят деньги на сезонных предприятиях (сбор урожая, услуги по обслуживанию туристов), а зимой, когда нет работы, они тратят то, что накопили за лето и осень.
Далее в ходе работы были построены и оценены несколько моделей динамики,
с помощью которых можно описать изменение во времени уровня безработицы в
России в период с января 2009 года по март 2013. Предоставим полученные
результаты в виде сводной таблицы:
Таблица 4
Сравнение оценок различных моделей динамики показателя
|
Название модели |
Оценка модели |
Недостатки |
|
Тренд-сезонная мультипликативная модель |
|
- неадекватна (наличие автокорреляции остатков) -не отразила «провал» 2012 года |
|
Гармоническая анализ |
|
-неадекватна (автокорреляция остатков) -незначимость коэффициентов при гармониках |
|
Адаптивная модель Брауна |
|
- наибольшая ст.ошибка |
|
Адаптивная модель Хольта |
|
-один из параметров экспоненциального сглаживания стремится к 1 |
|
ARIMA(1,1,1) |
|
-незначимость одного из коэффициентов при общей значимости уравнения в целом |
|
SARIMA (0,1,1,12) |
|
-незначимость коэффициента, отвечающего за сезонность |
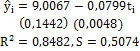
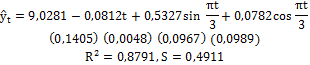
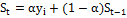
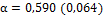 ,