Материал: Статистика. методические указания к выполнению лабораторных работ для студентов направления 38.03.02 «Менеджмент». Моисеев С.И., Перевалова О.С
Таблица 8
Исходные данные
Первый город
23 |
25 |
|
23 |
|
22 |
|
23 |
|
24 |
|
28 |
|
16 |
|
18 |
|
23 |
|
29 |
|
26 |
|
31 |
19 |
||
|
|
|
|
|
|
|
|
|
|
Второй город |
|
|
|
|
|
|
|
|
|
|
||||||
22 |
|
29 |
36 |
24 |
28 |
|
24 |
30 |
24 |
34 |
24 |
29 |
27 |
|
|
|||||||||||
Содержание отчета о выполнении работы:
1.Название и цель работы;
2.Результаты выполненных заданий;
3.Выводы и рекомендации (при необходимости).
ЛАБОРАТОРНАЯ РАБОТА 3 СТАТИСТИЧЕСКИЕ МЕТОДЫ ОБРАБОТКИ ДАННЫХ
Цель работы: приобретение практических навыков обработки собранных статистических данных.
Время выполнения работы: 4 часа.
Ход работы
1. Предварительная обработка данных
Основным объектом исследования в математической статистике является выборка. Выборкой объема n называются числа x1 , x2 , …, xn, получаемые на практике при n – кратном повторении эксперимента в неизменных условиях. На практике выборку чаще всего представляют статистическим рядом. Для этого вся числовая ось, на которой лежат значения выборки, разбивается на k интервалов (это число выбирается произвольно от 5 до 10), которые обычно равны, вычисляются середины интервалов zi, и считается число элементов выборки, попадающих в каждый интервал ni. Статистическим рядом называется последовательность пар (zi , ni). Рассмотрим решение задачи на ЭВМ в программе EXCEL на следующем примере.
ПРИМЕР 1. Дана выборка числа проданных автомобилей торговой фирмой за 25 недель:
14, 18, 16, 21, 12, 19, 27, 19, 15, 20, 27, 29, 22, 28, 19, 17, 18, 24, 23, 22, 19, 20, 23, 21, 19.
Построим статистический ряд, полигон, гистограмму и кумулятивную кривую. Откроем книгу программы EXCEL, Введем в первый столбец (ячейки А1-А25) исходные данные. Определим область чисел, на какой лежат данные. Для этого найдем максимальный и минимальный элементы выборки. Введем в В1 подпись «Максимум», а в В2 - подпись «Минимум». В соседних ячейках С1 и С2 определим функции «МАХ» и «MIN». Для этого ставим курсор в С1 и в ы- зываем мастер функций, нажав на кнопку fx, в открывшемся окне в поле «Категория» выбираем «Статистические», и ниже ищем функцию МАКС и вызываем ее двойным щелчком мыши по названию. В качестве аргумента функции (в графе «Число 1») обведем область данных (ячейки А1-А25). Поле «Число 2»
11
оставляем пустым. Нажимаем «ОК». Результатом будет число 29. Ставим курсор в ячейку С2 и аналогично вводим функцию МИН. Р езультат – число 12. Видно, что все данные укладываются на отрезке [12;30]. Разделим его на девять (выбирается произвольно от 5 до 10) интервалов по 2 единицы каждый:
12-14, 14-16, 16-18, 18-20, 20-22, 22-24, 24-26, 26-28, 28-30. В ячейки D1-D9
вводим верхние границы интервалов группировки – числа 14, 16, 18, 20, 22, 24, 26, 28, 30. Для вычисления частот ni используют функцию ЧАСТОТА, находящуюся в категории «Статистические». Введем ее в ячейку Е1. В строке «Массив данных» введем диапазон выборки (ячейки А1-А25). В строке «Массив интервалов» введем диапазон верхних границ интервалов группировки (ячейки D1-D9). Результат функции является массивом и выводится в ячейках Е1-Е9. Для полного вывода (не только первого числа в Е1) нужно выделить ячейки Е1Е9, обведя их мышью, и нажать F2, а далее одновременно CTRL+SHIFT+ENTER. Результат – частоты интервалов 2,2,3,7,4,3,0,3,1.
Для построения гистограммы нужно выбрать ВСТАВКА/ДИАГРАММА или нажать на соответствующий значок на основной панели (при этом курсор должен стоять в свободной ячейке). Далее выбрать тип: ГИСТОГРАММА, вид по выбору, нажать «ДАЛЕЕ», в строке «ДИАПАЗОН» обвести частоты Е1-Е9, перейти на вкладку «РЯД», в строке « ПОДПИСИ ОСИ Х» ввести интервалы в ячейках D1-D9, нажать «ДАЛЕЕ» ввести название «ГИСТОГРАММА», подписи осей: ось Х - «ИНТЕРВАЛЫ» и ось Y - «ЧАСТОТА», нажать «ГОТОВО». Для создания полигона перейти на пустую ячейку и сделать то же самое, только вместо типа диаграммы «ГИСТОГРАММА», выбрать «ГРАФИК». Для построения кумулятивной кривой нужно посчитать накопленные частоты. Для этого в ячейку F1 вводим «=Е1», в F2 – вводим «=F1+Е2» и автозаполнением перетаскиваем эту ячейку до F9. Далее строим график как и в случае полигона, но в строке «ДИАПАЗОН» вводим накопленные частоты, ссылаясь на F1-F9, а на вкладке «РЯД», в строке « ПОДПИСИ ОСИ Х» вводим интервалы в ячейках
D1-D9.
Задание 1. Дана выборка выручки магазина за последние 30 дней (табл. 9). Составить статистический ряд, построить гистограмму, полигон, кумуляту.
Таблица 9
Исходные данные
Выборка
18 |
19 |
21 |
18 |
16 |
19 |
18 |
16 |
17 |
18 |
15 |
22 |
18 |
17 |
22 |
14 |
19 |
16 |
14 |
14 |
22 |
14 |
21 |
18 |
16 |
12 |
19 |
18 |
18 |
15 |
2. Точечное оценивание
Для исследования основных свойств явления или объекта, представленного выборкой вычисляют точечные и интервальные оценки.
Точечные оценки параметров распределения это оценки, полученные по выборке и приближенно равные оцениваемым параметрам. Основными точечными оценками являются:
12
Объем выборки n – количество элементов в выборке.
Выборочное среднее x – оценка математического ожидания, среднеарифметическое элементов выборки.
Выборочная дисперсия S 2 – среднее квадратов отклонения элементов выборки от выборочного среднего, является оценкой дисперсии, характеризует разброс выборочных значений.
Стандартное отклонение S – корень из дисперсии.
Медиана h – средний элемент вариационного ряда или полусумма двух средних элементов, если объем выборки четный.
Мода d – наиболее часто повторяющийся элемент.
Коэффициент эксцесса δ - характеризует «островерхость» гистограммы или полигона по сравнению с кривой Гаусса нормального распределения.
Коэффициент асимметрии γ - характеризует степень симметричности гистограммы или полигона.
Перцентиль на уровне р - значение t p , меньше которого p 100% элементов
выборки.
ПРИМЕР 2. Имеется выборка числа автомобилей, проданных автосало-
ном за 25 недель: 43, 38, 34, 51, 47, 45, 41, 52, 50, 38, 43, 44, 39, 46, 49, 42, 42, 38, 53, 55, 48, 45, 41, 49, 47. Найти основные числовые характеристики выборки.
Запускаем программу EXCEL, первый лист. Вводим исходные данные в ячейки А1-А25. Находим числовые характеристики. Для ввода функций выделяем два столбца, например В и С, в первом вводим название характеристики, во втором – функцию. В ячейки В1-В11 вводим подписи числовых характеристик, то есть вписываем в эти ячейки первый столбец таблицы приведенной ниже. В С1 вводим текст «Функция» и ниже определяем функции, соответствующие названию (из второй колонки таблицы). Все функции вызываются нажатием на кнопку fx, находятся в категории «Статистические» и в качестве массива данных (поле «ЧИСЛО 1»), указывается ссылка на А1-А25. Например, для ввода первой из них ставим курсор в С2, нажимаем fx, выбираем категорию «Статистические» и функцию «Счет», в открывшемся окне ставим курсор в поле «Число 1» и обводим курсором ячейки А1-А25, нажимаем «ОК». Также поступаем и с другими функциями (табл. 10).
13
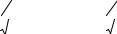
Таблица 10
Виды функций
Характеристика |
Функция |
Объем выборки |
СЧЁТ(массив данных) |
Выборочное среднее |
СРЗНАЧ(массив данных) |
Дисперсия |
ДИСП(массив данных) |
Стандартное отклонение |
СТАНДОТКЛОН(массив дан- |
|
ных) |
Медиана |
МЕДИАНА(массив данных) |
Мода |
МОДА(массив данных) |
Коэффициент эксцесса |
ЭКСЦЕСС(массив данных) |
Коэффициент асиммет- |
СКОС(массив данных) |
рии |
|
Перцентиль 40% |
ПЕРСЕНТИЛЬ(массив дан- |
|
ных; 0,4) |
Перцентиль 80% |
ПЕРСЕНТИЛЬ(массив дан- |
|
ных; 0,8) |
Существует другой способ вычисления числовых характеристик выборки. Для этого ставим курсор в свободную ячейку (например, D1). Затем вызываем в меню «Данные» подменю «Анализ данных». Если в меню «Данные» отсутствует этот пункт, то в обратитесь к преподавателю для его подключения. В окне «Анализ данных» нужно выбрать пункт «Описательная статистика». В появившемся окне в поле «Входной интервал» делаем ссылку на выборку А1-А25, помещая курсор в поле и обводя эти ячейки. Оставляем группирование «По столбцам». В разделе «Параметры вывода» ставим флажок на «Выходной интервал» и в соседнем поле задаем ссылку на верхнюю левую ячейку области вывода (например, D1), ставим флажок напротив «Описательная статистика», нажимаем «ОК». Результат – основные характеристики выборки (сделайте шире столбец D, переместив его границу в заголовке).
Задание 2. Для данных из задания 1 вычислить основные числовые характеристики выборки обоими способами.
3. Интервальное оценивание
Рассмотрим теперь методы интервального оценивания. Доверительным интервалом называется интервал (a;b) , в который с заданной вероятностью р
попадает оцениваемый параметр. Вероятность р называется доверительной. Вместо нее часто задают величину α =1− p , называемую уровнем значимости.
Если выборка объема п представляет случайную величину, распределенную нормально, то доверительные интервалы для матожидания и дисперсии равны
|
S t |
α |
|
(n −1) |
|
S t |
α |
|
(n −1) |
|
|||
|
1− |
|
2 |
|
|
1− |
|
2 |
|
|
, |
||
m x − |
|
|
|
|
|
; x + |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
n |
|
|
|
n |
||||||
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
14
|
|
|
2 |
|
|
|
|
2 |
|
|
|
|
σ2 |
|
S |
(n −1) |
; |
S |
(n −1) |
|
, |
||||
|
|
|
|
|
||||||||
χ2 |
|
|
|
(n −1) |
χα2 (n −1) |
|||||||
|
|
|
α |
|
|
|
||||||
|
|
1− |
|
|
2 |
|
|
|
2 |
|
|
|
где tp (n) и χ2p (n) - квантили распределения Стьюдента и хи-квадрат, α =1− p .
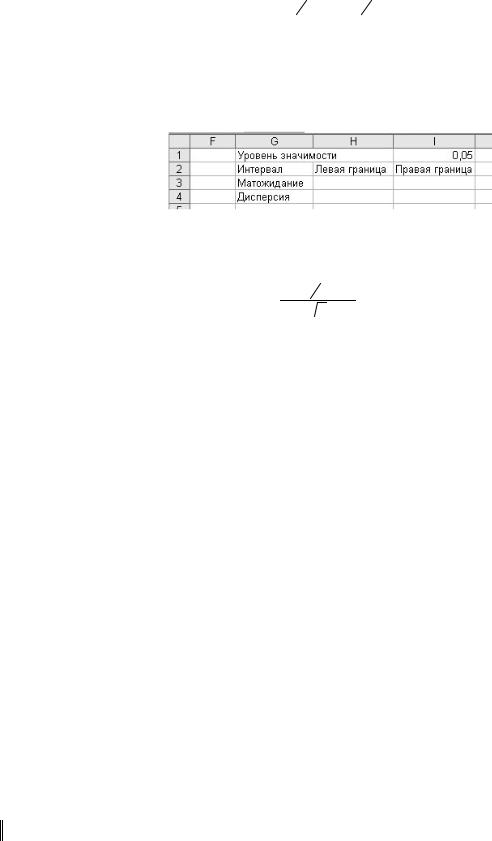
Возвращаемся на лист 1 электронной таблицы с данными примера и для них вычислим доверительные интервалы при р=0,05. Вводим данные согласно рис. 1.
Рис. 1. Лист введенных данных
Для вычисления величины S t1−α2 (n −1) служит функция «ДОВЕРИТ» кате-
 n
гории «Статистические» с тремя параметрами «Альфа» - уровень значимости α =1− p , «Станд_откл» - среднеквадратическое отклонение S, «Размер» - объем
выборки п. Таким образом, вводим в Н3 функцию:
=СРЗНАЧ(А1:А25)-ДОВЕРИТ(I1;СТАНДОТКЛОН(А1:А25);25)
а в ячейку I3 функцию:
=СРЗНАЧ(А1:А25)+ДОВЕРИТ(I1;СТАНДОТКЛОН(А1:А25);25)
Для вычисления доверительного интервала для дисперсии следует отметить, что функция вычисления квантили распределения хи-квадрат (обратного распределения хи-квадрат) называется «ХИ2ОБР» (категория «Статистические») и имеет два параметра: первый «Вероятность» содержит доверительную вероятность р, второй – степень свободы п-1. Вводим в соответствии с данными условиями и формулой для доверительного интервала в ячейку Н4 запись:
=ДИСП(A1:A25)*24/ХИ2ОБР(0,025;24)
а в ячейку I4 запись: =ДИСП(A1:A25)*24/ХИ2ОБР(0,975;24).
Получаем значения границ доверительных интервалов.
Задание 3. Для данных из задания 1 вычислить доверительные интервалы для матожидания и дисперсии при α = 0,01 . Изменяя значения уровня значимости
α сделать вывод о его влиянии на ширину интервала. Содержание отчета о выполнении работы:
1.Название и цель работы;
2.Результаты выполненных заданий;
3.Выводы и рекомендации (при необходимости).
15