Дипломная (вкр): Защита функционально-логической структуры интегрированных инфокоммуникационных систем от вскрытия технической компьютерной разведкой
Условимся использовать следующие обозначения:
вершина Unr - вершина с номером n, и степенью - r (количеством инцидентных ей ребер);
подграф {Unr (Ul, Um, Uk)} - вершина Unr которого является основной (той вершиной, в рамках которой управление ДМП позволяет достигать преобразования), а в скобках указываются вершины, с которыми связана основная вершина подграфа (количество указанных в скобках вершин соответствует степени r основной вершины);
степень rmax - максимальная степень вершины (нескольких вершин) в исходном графе;
номер вершины nmax - максимальный номер вершины в текущем (исходном или преобразованном графе до применения очередного правила), необходимый для обозначения номеров новых вершин графа;
правило U73 (U4, U5, U6) ® U74 (U4, U5, U6, U10), описываемое, как и в формальных грамматиках, будет означать, что вершина U7 переходит в саму себя, но при этом ее степень r повышается на единицу, и она получает дополнительное ребро, связывающее ее с вершиной U10.
Здесь и далее под основной вершиной понимается вершина, отображающая такой УС, на котором должны быть выполнены действия, позволяющие достичь задаваемых правилами преобразований.
Например, на рис. 2.7 графически изображено правило преобразования,
описанное выше.
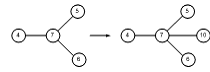
Рисунок 2.7 - Правило преобразования графовой грамматики
Далее графически и в символьном виде сформулированы, как пример алфавита
создания графовых грамматик, несколько правил преобразования, необходимые для
решения задач, поставленных перед ПЗЛС, а также будут даны ограничения и
физический смысл использования таких правил.
Правило преобразования 1
Unr (Ul, Um, Uk, …) ® Unr (Ul, Um, Uk,
…) + Unmax+1r (Ul, Um, Uk,
…)
правило, изображенное на рис. 2.8, и заключающееся в добавлении в исходный граф дополнительной вершины Unmax+1, полностью дублирующей основную вершину Unr заменяемого подграфа по ее связям с остальными вершинами графа.
Физически такое правило можно интерпретировать созданием в СС ложного УС,
который будет связан ИП с теми же УС, что и УС, интерпретируемый в графе
вершиной Un, что может быть вызвано
необходимостью усложнения ЛССС на информационном поле КР.
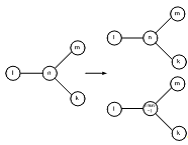
Рисунок 2.8 - Правило преобразования ЛССС №1
Правило преобразования 2
Unrmax (Ul, Um, Uk,
Uj, Uh, …) ® Unrmax-i (Ul, …) + Unmax+1j
(Uk, …) + … -
правило, изображенное на рис. 2.9, и заключающееся в понижении степени r вершины Un на величину i (i=j+…) и добавлении в исходный граф
новых вершин, забирающих часть связей основной вершины заменяемого подграфа на
себя. Наибольший смысл применение этого правила имеет в случае, когда степень r вершины Un наибольшая в СС (rmax), однако в ряде случаев можно
заменить в правиле Unrmax на Unr (т.е. понизить степень не только вершины с максимальной
степенью, но и других вершин).
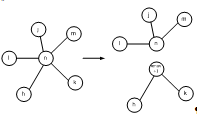
Рисунок 2.9 - Правило преобразования ЛССС №2
Физический смысл такого преобразования заключается в понижении уровня иерархии УС, интерпретируемого в графе вершиной Un, и усложнения структуры СС. Понижение уровня иерархии УС также вызвано необходимостью смещения акцента с наиболее важных УС на второстепенные (отвлечение противника на другие цели). Такая необходимость является следствием того, что количество связей УС с другими узлами равное rmax с наибольшей вероятностью будет у УС, занимающего высший уровень иерархии в СС.
Правило преобразования 3
Unr (Ul, …) ® Unr (Ul, …) + Unmax+1r+i (Uf,
Ug, Uk, Uj, Uh, …)
правило, изображенное на рис. 2.10, и заключающееся в добавлении в
исходный граф дополнительной вершины Unmax+1 с увеличенной на величину i степенью (количеством связей с другими вершинами), и при
этом не имеющей дублирующих по сравнению с заменяемым подграфом связей основной
вершины Unr. Наибольший смысл такая процедура
имеет в случаях, когда степень вершины Unr мала (стремится к единице).
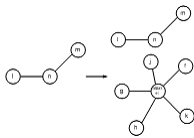
Рисунок 2.10 - Правило преобразования ЛССС №3
Суть этого преобразования играет важную роль при смещении акцентов КР на второстепенные УС. Физический его смысл заключается в создании ложного УС высокого уровня иерархии (с большим количеством связей с другими УСС), играющего перед КР отвлекающую роль.
Важно, что все представленные правила преобразований позволяют исказить и усложнить ЛССС на информационном поле КР. Последние же два правила (2, 3), применяемые одновременно к разным узлам, позволят существенно исказить информацию об оперативно-тактической принадлежности УС, входящих в ЛССС, формируемую на информационном поле КР. Одно из них будет снижать уровень иерархии УС, а другие два будут повышать его для других УС. В случае применения описанных преобразований в СС ПДВ будут направлены на второстепенные УС.
В соответствии с задачами, возложенными на ПЗЛС, она должна обеспечить не только первоначальное формирование защищенной ЛССС и функционирование, но и возможность дополнительных мер защиты в случае осуществления противником попыток ПДВ на элементы СС.
Под дополнительными мерами защиты в данном случае понимаются действия, направленные на дезорганизацию противника в случае обнаружения попыток осуществления им ПДВ на элементы СС, позволяющие дезорганизовать противника лишением его эффективности накопленной развединформации о СС.
Для реализации этой задачи необходимо разработать дополнительные правила преобразований ЛССС.
Правило преобразования 4
Unr (Ul, Um, Uk, Uj, Uh, …) ® Uor (Up, Uf, Uc,
Ud, Ua, …)
правило, изображенное на рис. 2.11, и заключающееся в замене подграфа в исходном подграфе на идентичный ему, но при этом в заменяющем подграфе полностью изменена нумерация вершин.
Рисунок 2.11 - Правило преобразования ЛССС №4
Физический смысл такого преобразования заключается в полной замене
идентификаторов (адресов) всех узлов в СС по аналогии со сменой радиоданных в
радиосвязи. Это преобразование позволит уже вскрытой КР ЛССС пропасть с
информационного поля разведки, и КР понадобится существенное время для того,
чтобы вновь вскрыть ее. Такое преобразование лучше применять сразу ко всей
ЛССС, однако может иметь смысл и частичное преобразование отдельных (критически
важных) сегментов.
.1.4 Методы и показатели оценки эффективности мероприятий по формированию логической структуры системы связи
Разработано обеспечение, позволяющее осуществлять практически бесконечное количество преобразований ЛССС. Однако для того, чтобы не превысить свои возможности (например, по наличию защитного ресурса на преобразования в реальной СС), следует выполнить лишь достаточное и необходимое количество преобразований.
Поскольку применение разработанного аппарата позволяет получить множество вариантов такого преобразования, представляется необходимым разработать методы, позволяющие количественно оценить эффективность получаемых вариантов с целью выбора из них наиболее эффективного.
В первую очередь для получения обоснованного решения необходимо обеспечить возможность выбора, т. е. с помощью разработанного аппарата преобразований ЛССС сформировать некоторое множество вариантов преобразования. Во вторую очередь необходимо оценить эффективность предлагаемых вариантов с целью выбора наилучшего.
Очевидно, что с целью снижения сходства реальной ЛССС и получаемой противником в результате КР, оценку эффективности целесообразно производить методами, позволяющими оценить это сходство.
Такая оценка может быть получена следующим образом. Параметры ЛССС могут быть приняты в качестве координат многомерного пространства. При этом реальной ЛССС, отражающей СУ, можно привести в соответствие вектор S (Н1,…,НN), где H1, …,HN - параметры, количественно характеризующие свойства ЛССС, а логическую структуру, получаемую КР, будет характеризовать вектор S', который в самом благоприятном для КР случае (без осуществления преобразований ЛССС и в случае полного вскрытия СС), равен вектору S.
Поскольку в математическом аппарате, о котором идет речь, объекты описываются вектором признаков, а ЛССС описана матрицей, целесообразно представить каждую матрицу в виде вектора, записав последовательно все строки матрицы в вектор. Для более качественной оценки целесообразно производить ее, используя обе матрицы, описывающие ЛССС: матрицу связности и матрицу интенсивности ИП, отражающие граф ЛССС.
В этих условиях необходимо определение меры близости реальной ЛССС (вектор S), и ЛССС, получаемой КР (вектор S'). Мера близости - характеристика различимости двух гипотез, а также качества имитации истинного объекта с помощью ложного. В математической статистике известны несколько подходов к вычислению мер близости.
Наиболее часто для количественных шкал в качестве меры близости
применяется Евклидово расстояние:
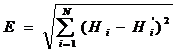 (2.5)
где Нi и Н'i - компоненты признакового описания реальной ЛССС и ЛССС, получаемой КР, соответственно.
Необходимо отметить, что для еще более качественной и наглядной оценки эффективности необходимо выполнить классификацию всех вариантов преобразования ЛССС и выделить, таким образом, множество наиболее эффективных вариантов из всех предлагаемых. То есть необходимо разбить предлагаемые варианты преобразования на два множества эффективных и неэффективных вариантов. Для выполнения такой классификации наиболее подходит математический аппарат кластерного анализа (кластер-анализа).
Кластер-анализ - это способ группировки многомерных объектов, основанный на представлении результатов отдельных наблюдений точками подходящего геометрического пространства с последующим выделением групп как «сгустков» этих точек. Другие названия этого аппарата (распознавание образов без учителя, таксономия, классификация) говорят о том, что он позволяет решать задачу автоматически, без привлечения знаний человека, а, следовательно, исключает возможность ошибочного решения задачи вследствие влияния личных предпочтений оператора.
Кластер-анализ
позволит нам разбить множество предлагаемых вариантов преобразования ЛССС на
заданное число групп. Для решения этой задачи необходимо применить
иерархический алгоритм классификации ко всем вариантам преобразования, включая
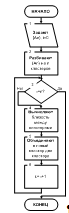
и исходный вариант, отражающий реальную ЛССС. Иерархические алгоритмы
классификации выполняются по следующей схеме (рис. 2.12). Первоначально каждый
объект из множества объектов {An} считается отдельным кластером (бл. 1 и 2 на рис.
2.12). Строится матрица расстояний размера n´n (n - количество классифицируемых объектов), каждый
элемент которой вычисляется с помощью выбранной меры близости (бл. 4 на рис. 2.12).
На следующем шаге объединяются два кластера, которые образуют новый класс (бл.
5 на рис. 2.12). Далее определяются расстояния от этого класса до всех
остальных кластеров, и размерность матрицы расстояний D сокращается на
единицу.
Рисунок
2.12 - Обобщенный алгоритм иерархической классификации
На p-ом шаге повторяется та же процедура
на матрице D(n-p) ´ (n-p), до тех пор, пока все объекты не объединятся в один
класс. В результате классификации строится дендрограмма, отображающая
последовательность включения исходных объектов в кластеры и расстояния между
классами. На рис. 2.13 представлен пример дендрограммы.
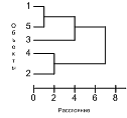
Рисунок 2.13 - Пример дендрограммы, получаемой в результате иерархической
классификации.
Слева указаны номера исходных объектов. Снизу расположена шкала расстояний между кластерами. Вертикальная связь обозначает объединение кластеров. Например, в соответствии с алгоритмом классификации объекты 1 и 5 были первыми объединены в кластер, а вычисленная мера близости между ними равна 1.
Основными показателями эффективности по которым происходит объединение являются:
Показатель близости к исходной ЛССС без учета информации о направлениях и
интенсивностях ИП rстр и показатель близости к исходной
ЛССС с ее учетом rстрИП
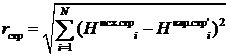 , (2.6)
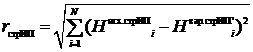 (2.7)
Чем
выше указанные показатели у конкретного варианта преобразования, тем меньше
сходство между получаемой в результате преобразования ЛССС и исходной (т.е.
больше отличий в этих структурах). Т.е. критерием эффективности является
rстр, rстрИП ® max. (2.8)
Показатель
близости не имеет единицы измерения и верхнего (максимального) значения, что
требует его нормировки к единице::
rстр, rстрИП ® 1. (2.9)
Показатель, отражающий доступность пунктов управления в случае реализации
противником ПДВ с учетом их важности для СУ (их оперативно-тактической
принадлежности):
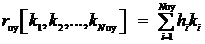 , (2.10)
где: rпу - показатель доступности пунктов управления в случае реализации противником ПДВ;
hi - коэффициент важности i-ого ПУ, который зависит от его оперативно-тактической принадлежности;
ki Î [0, 1] - индикатор состояния УС i-ого ПУ, ki = 1, если i-ый УС ПУ функционирует, ki = 0 - в противном случае.
Вычислять
показатель доступности ПУ при реализации конкретного преобразования, необходимо
задав, например, количество УС ПУ, на которые КР будет осуществлять ПДВ. При
этом в случае, когда противник не реализует ПДВ, все УС ПУ функционируют, т.е.
показатель доступности имеет свое максимальное значение, а в зависимости от
количества УС ПУ, подавляемых противником, и их важности, показатель будет
уменьшаться. Следовательно, в качестве показателя устойчивости ПУ для j-го
варианта целесообразно использовать отношение его rпу в случае реализации противником ПДВ (rпуПДВj)
к rпу в
исходном состоянии (rпуИСХ):
 (2.11)
Таким
образом, мы получаем еще один показатель эффективности для применяемого
преобразования - показатель доступности ПУ. Критерием эффективности в этом
случае является:
rпу ® 1. (2.12)
Суммарные затраты должны включать в себя следующие составляющие:
ΔN - количество добавленных по сравнению с исходным вариантом ЛССС узлов (адресов узлов);
ΔM - добавленная по сравнению с исходным вариантом интенсивность информационного обмена (объем маскирующего обмена);
Δn - номинал затрат на один адрес;
Δm - номинал затрат на единицу трафика.
Номиналы затрат на адреса и трафик могут быть заданы в виде неких весовых коэффициентов, отражающих важность параметра.
В результате суммарные затраты Z на реализацию j-го
варианта преобразования должны вычисляться следующим образом: