Материал: 3106
3. Моделирование вычислительных процессов и алгоритмов обслуживания вычислительных задач
Процесс обработки данных в информационной технологии преследует определенную цель – решение с помощью ЭВМ вычислительных задач, отображающих функциональные задачи той системы, в которой ведется управление. Для реализации этой цели должны существовать модели обработки данных, соответствующие алгоритмы управления и воплощенные в машинных программах.
Процесс обработки данных может быть разбит на ряд связанных между собой процедур: организация вычислительного процесса, преобразование данных и отображение данных.
Организация вычислительного процесса (ОВП)
Содержание процедуры процесса обработки данных представляет его концептуальный уровень, модели и методы, формализующие процессы обработки данных в ЭВМ – логический уровень, а средства аппаратной реализации процедур – физический уровень процесса.
Процедура ОВП имеет различную функциональную сложность в зависимости от класса и количества решаемых задач, режимов обработки данных, топологии системы обработки данных. При обработке данных на ЭВМ различают три основных режима: пакетный, разделения времени, реального времени.
При пакетном режиме обработки задания программы с соответствующими исходными данными накапливаются на дисковой памяти ЭВМ, образуя «пакет». Обработка заданий осуществляется в виде непрерывного потока. Такой режим позволяет максимально загрузить ЭВМ, но дает задержки в получении решения из-за того, что некоторое время задание простаивает в очереди.
Режим разделения времени реализуется путем выделения для выполнения заданий определенных интервалов времени (квантов). Предназначенные для обработки задания находятся в ОП ЭВМ одновременно. В режиме разделения времени возможна реализация диалоговых операций.
Режим реального времени используется при обработке данных в ЭВМ, предназначенных для управления физическими процессами. В таких системах ЭВМ должна обладать высокой скоростью реакции, чтобы успеть за короткий интервал времени обработать поступившие данные и использовать результаты для управления процессами. В режиме разделения времени используется вариант мультипрограммного режима.
Задания в виде программ и данных подвергаются процессу обработки, поступая из системы ввода, системы хранения и по каналам вычислительной сети. В этих условиях остро ставиться вопрос планирования и выполнения заданий в вычислительной системе.
Организация обслуживания вычислительных задач
При организации и планировании процесса обработки данных в ВС возможны различные методы организации и обслуживания очередей заданий. При этом преследуется цель получения лучших значений таких показателей, как производительность, загруженность ресурсов, малое время простоя, высокая пропускная способность, разумное время ожидания в очереди заданий.
При организации обслуживания вычислительных задач на логическом уровне создается модель задачи обслуживания, которая может иметь как прямой, так и оптимизационный характер. При постановке прямой задачи данными являются параметры ВС, а решением – показатели эффективности организации вычислительных процессов (ОВП). При постановке оптимизационной задачи задаются требуемые показатели эффективности ОВП и требуется определить параметры ВС.
В ВС моменты появления заданий являются случайными и случайным является момент окончания вычислительной обработки. Поэтому при моделировании пользуются статистическими данными о среднем количестве поступающих заявок в единицу времени на обработку в ВС, а также о среднем времени решения одной задачи. Эти данные позволяют рассматривать процедуру организации ВП с помощью теории систем массового обслуживания [10]. ОВП можно представить схемой, приведенной на рис. 2.
Т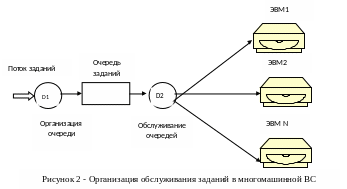 акая
схема может быть охарактеризована как
система с дискретными состояниями и
непрерывным временем. Под дискретным
состоянием понимается то, что в любой
момент времени система может находиться
только в одном состоянии. Число состояний
ограничено. Под непрерывным временем
подразумевают, что границы перехода из
одного состояния в другое не фиксированы.
Состояние системы характеризуется
числом заданий в очереди плюс число
заданий, обрабатываемые ЭВМ. Очередь
уменьшается, когда ЭВМ
заканчивает обработку задания. Число заданий в системе растет благодаря потоку заданий. Поток заданий характеризуется интенсивностью λ – средним количеством заданий, поступающим в единицу времени. Среднее время обслуживания одного задания ЭВМ определяет интенсивность потока обслуживания μ:
μ = 1/tобсл ,
где tобсл – среднее время обработки одного задания.
Рассмотрим модель обслуживания вычислительных заданий (рис.2) введя следующие предположения:
- в системе протекают Марковские случайные процессы;
- потоки событий (появление заданий, окончание их обработки) являются простейшими;
- число заданий в очереди не ограничено, но конечно.
Случайный процесс, протекающий в системе, называется Марковским. Простейший поток событий характеризуется стационарностью (независимость параметров во времени), ординарностью (события в потоке появляются поодиночке) и «безпоследствием» (появляющиеся события не зависят друг от друга).
Обозначим состояния рассматриваемой системы:
S0 – в системе нет заданий;
S1 – в системе одно задание и оно обрабатывается на ЭВМ1;
Sn – в системе n заданий и они обрабатываются на ЭВМ1, ЭВМ2,..ЭВМn ;
Sn+1 – в системе (n+1) задание, n заданий обрабатываются на ЭВМ и одно задание стоит в очереди;
….
Sn+m - в системе (n+m) заданий, n заданий обрабатываются на ЭВМ и m заданий стоят в очереди.
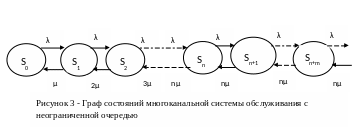
Рост числа заявок в системе происходит под воздействием их потока с интенсивностью λ, а уменьшение – под воздействием потока обслуживания с интенсивностью μ. Размеченный граф состояний системы приведен на рис.3.
Увеличение числа одновременно работающих машин приводит к росту интенсивности обслуживания от μ до nμ. Дальнейший рост числа заявок переводит систему в состояние n+1, n+2, ..n+m, а интенсивность потока обслуживания будет оставаться неизменной, равной nμ..
При исследовании такой вероятностной системы важно знать значение вероятностей состояний, с помощью которых можно вычислить показатели эффективности, такие, как количество заданий в системе, время ожидания обработки, пропускная способность и др.
Дискретная система в любой момент времени может находиться только в одном состоянии, поэтому
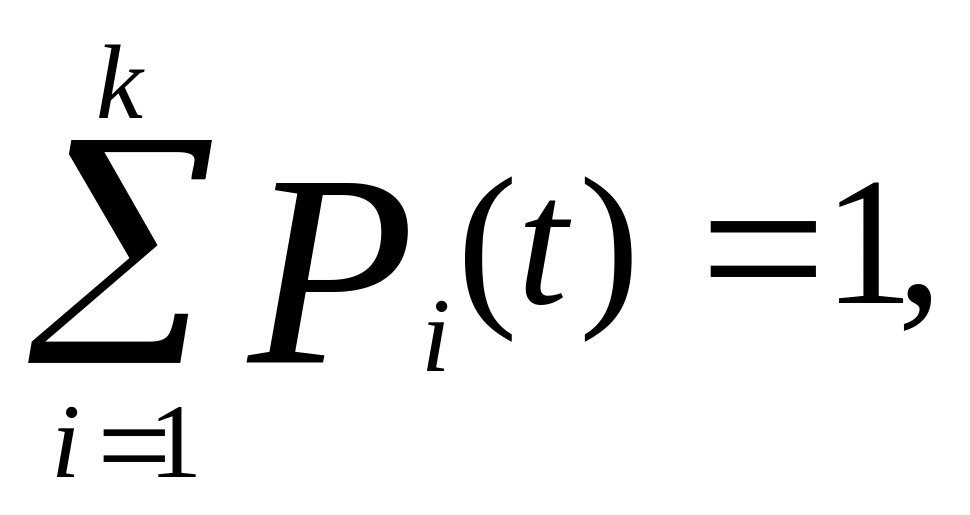
где k- число возможных состояний системы.
В процессе работы реальные вычислительные системы быстро достигают установившегося режима. Тогда вероятности состояний не будут зависеть от времени. Для вычисления финальных вероятностей используют систему дифференциальных уравнений Колмогорова, которые превращаются в систему алгебраических уравнений. На основе графа (рис. 2.3) может быть записана следующая система алгебраических уравнений [9]:
λP0 = μP1;
(1μ + λ)P1 = λP0 + 2 μP2;
(2μ + λ)P2 = λP1 + 3 μP3;
…………………………..
(nμ + λ)Pn = λPn-1 + nμPn+1;
(nμ + λ)Pn = λPn-1 + nμPn+1;
(nμ + λ)Pn+1 = λPn + nμPn+2;
……………………………….
(nμ + λ)Pn+j = λPn+j-1 + nμPn+j+1; j>=1.
Финальные вероятности состояний системы в результате решения системы уравнений описываются следующими уравнениями:
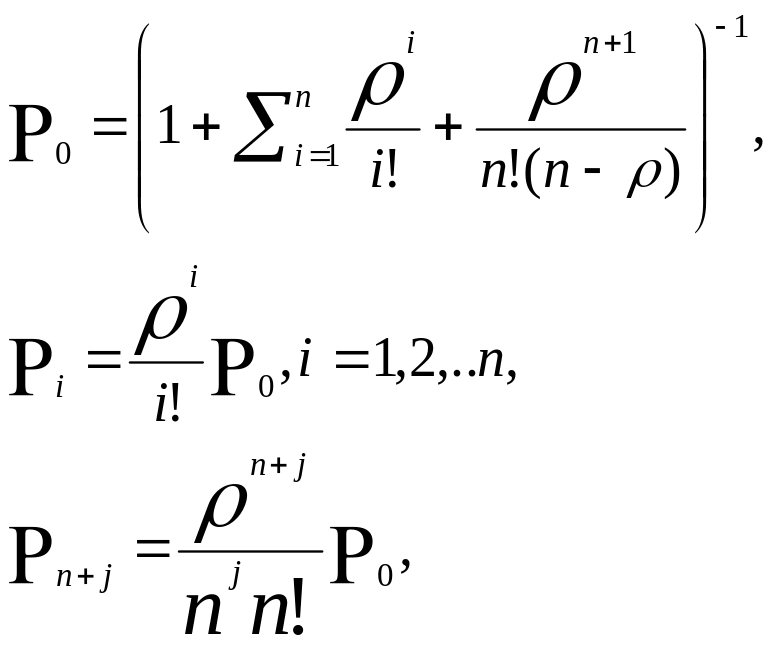
где P0 –вероятность состояния S0, при котором в системе заявок нет;
ρ=λ/μ – параметр системы, показывающий, сколько в среднем заявок приходит в систему за время обслуживания заявки одной ЭВМ (одним каналом обслуживания);
Pi - вероятность состояния системы Si , i=1, 2, ...n;
Pn – вероятность того, что все ЭВМ заняты обслуживанием заявок;
Pn+j – вероятность того, что все ЭВМ системы заняты обработкой заданий
и j заявок стоят в очереди.
Приведенные формулы имеют смысл тогда, когда очередь конечна,
т.е. ρ/n < 1 или λ/nμ < 1.
Это выражение говорит о том, что в среднем число заданий, приходящих в вычислительную систему в единицу времени, должно быть, меньше числа обрабатываемых заданий в единицу времени всеми ЭВМ системы. При ρ/n>1 очередь растет до бесконечности и такая система не справится с потоком заданий. Тут появляются задания, ожидающие обработки вечно.
Основными показателями эффективности работы системы являются:
- среднее число занятых каналов (ЭВМ)
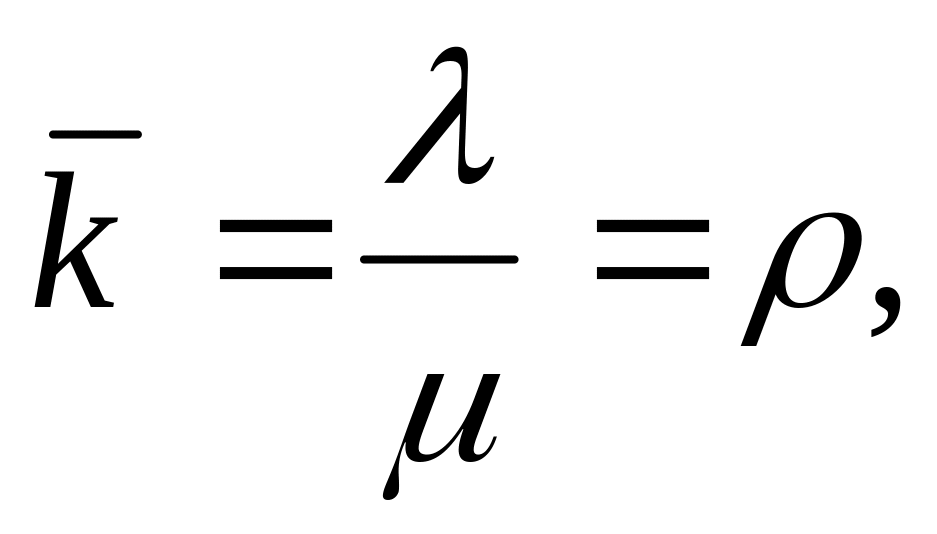
- среднее число заданий в очереди
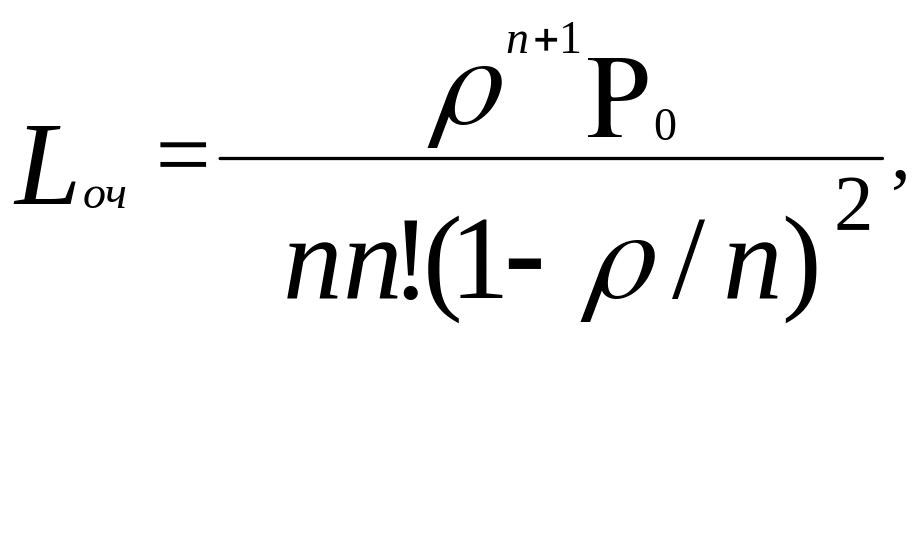
- среднее число заданий в системе
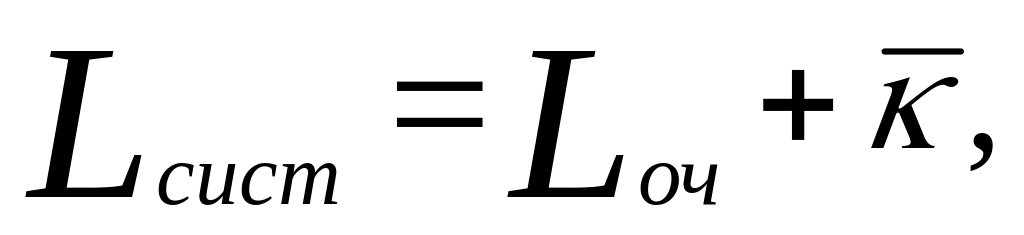
- среднее время пребывания задания в системе
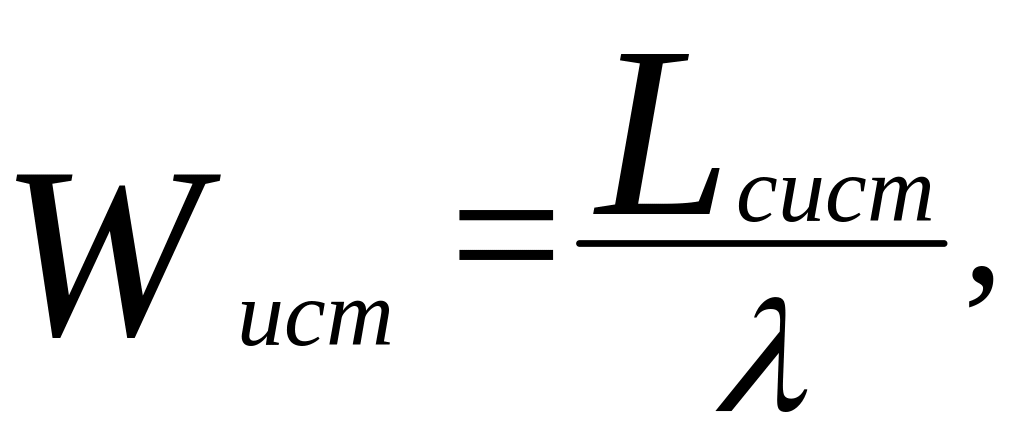
- среднее время пребывания задания в очереди
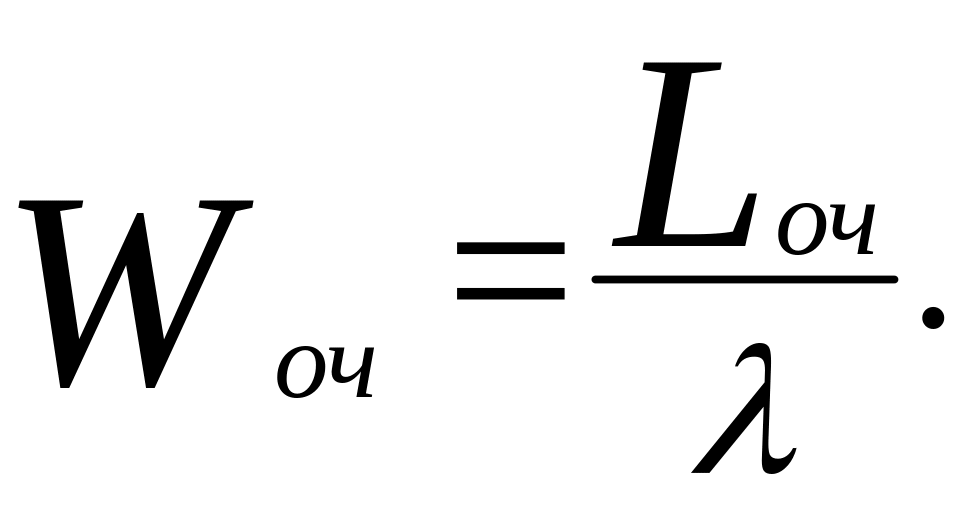
Для уменьшения времени пребывания задания в системе, а значит, и в очереди, требуется при заданной интенсивности потока заявок либо увеличивать число обслуживающих ЭВМ, либо уменьшить время обслуживания каждой ЭВМ, либо и то и другое вместе.
С помощью теории массового обслуживания можно получить аналитические выражения и при других дисциплинах обслуживания очереди и конфигурациях вычислительной системы.
При немарковских процессах в системе и не простейших потоках аналитические выражения получить трудно. В таких случаях моделирование проводят с помощью метода статистических испытаний (метод Монте – Карло), который позволяет создать алгоритмическую модель, включающую элементы случайности. Путем многократного запуска модели получают статистические данные, обработка которых дает значения финальных вероятностей состояний.
Тестовые задания
1) Общие сведения о теории массового обслуживания. Предмет теории массового обслуживания.
2) Параметры и характеристики систем массового обслуживания.
3) Моделирование систем массового обслуживания (СМО).
4) Показатели эффективности систем массового обслуживания.
5) Критерии эффективности систем массового обслуживания.
6) Моделирование вычислительных процессов и алгоритмов обслуживания вычислительных задач
7) Организация вычислительного процесса.
8) Граф состояний многоканальной системы обслуживания с неограниченной очередью.
9) Вычисление финальных вероятностей системы обслуживания. Система алгебраических уравнений Колмогорова.
10) Основными показателями эффективности работы системы массового обслуживания.
Литература
1) Автоматизированные информационные технологии в экономике: Учебник/ М.И. Семенов, И.Т., Трубилин, В.И. Лойко, Т.П. Барановская; Под общ. ред. И.Т Трубилина. –М.: Финансы и статистика, 2001.-416с. ISBN 5-279-02162-8.
2) Методология проектирования информационных систем: учеб. пособие/Р.И. Макаров, Е.Р. Хорошева; Владимирский гос. университет, Владимир, 2008.-334с.
3) Теория систем и системный анализ в управлении организациями: Справочник: Учеб. пособие/Под ред. В.Н. Волковой и А.А. Емельянова. - М.: Финансы и статистика, 2006. - 848 с:. ISBN 5-279-02933-5.
4) Р.И. Макаров. Анализ и синтез информационных систем. Методические указания к практическим занятиям (вторая часть). Учебное электронное издание. Владимир 2013. -45с.
5) Р.И. Макаров. Анализ и синтез информационных систем. Методические указания к лабораторным занятиям (часть 2-я). Учебное электронное издание. Владимир 2013. -50с.
Лекция 17. Ситуационное моделирование или ситуационное управление
Метод ситуационного управления возник в связи с необходимостью моделирования процессов принятия решений в системах с активным элементом (человеком). В его основе лежат три основные предпосылки.
Первая предпосылка - это психология, которая начала изучать принципы и модели принятия решений человеком в оперативных ситуациях. Основой построения модели являются понятийные представления об объектах и отношениях между ними, отражающие семантику выделенной сферы деятельности человека (предметной области). В.Н. Пушкин впервые выделил три важные особенности процесса принятия решений: наличие возможности классификации ситуаций в соответствии с типовыми решениями по управлению; принципиальная открытость больших систем; существенная ограниченность языка описания пространства состояний и решений объекта управления.
Второй предпосылкой метода ситуационного управления стали представления, полученные в исследованиях по семиотике - науке о знаковых системах. В прикладной семиотике знаки, вариантами которых являются слова, предложения, тексты, стали рассматриваться как системы, замещающие реальные объекты, процессы, события внешнего мира. Совокупности знаков с отношениями между ними, таким образом, стали моделирующими псевдофизическими аналогами реальных систем функционирования и управления.
Третья предпосылка связана с разработками в области информационно-поисковых систем и попытками создания формального языка описания и представления технических наук с целью автоматизации работ по реферированию научных публикаций и организации процессов поиска, хранения и представления информации.
Сформулирована новая кибернетическая концепция управления большими системами в виде метода ситуационного управления. Сущность метода состоит в следующем:
- за основу управления принято понятие ситуация как основной объект описания, анализа и принятия решений. Следовательно, необходимы соответствующие средства - описания, классификации, обучения и трансформации ситуаций в соответствии с принимаемыми решениями;
- классификация ситуаций обосновывалась существованием исходя из анализа структуры задач управления в больших системах.
Задача принятия решений трактовалась как задача поиска такого разбиения множества ситуаций на классы, при котором каждому классу соответствовало решение, наиболее целесообразное с позиции заданных критериев функционирования. При наличии такого разбиения поиск решения в конкретной ситуации сводился к поиску класса и соотнесения ему решения по управлению. Такая постановка задачи справедлива для систем управления, в которых число потенциально возможных ситуаций (ПВС) существенно превышает (иногда на несколько порядков) число возможных решений по управлению. Этот случай соответствует контекстно-независимому способу вывода решений, когда все множество ПВС разбивается на классы таким образом, чтобы каждому классу в соответствие ставилось решение по управлению;
- Важнейшая идея метода - формирование семиотической модели объекта путем обучения принятию решений. При этом рассматривались два режима обучения: экспертом, хорошо знающим исследуемую предметную область, либо на основе анализа множества конкретных ситуаций и решений по управлению. Очевидно, что последний случай более длителен, не гарантирует полноту описания, требует наличия статистики ситуаций и принятых в них решений, что далеко не всегда возможно.