Курсовая работа (т): Эконометрика. Корреляционный анализ
Получаем гиперболическую модель:
у = 8,7815 - 16,7377
Оценим эластичность:
Э = 
 =
 =
 =
 Þ


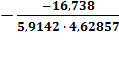 =
0.61 %
. Оценка тесноты связи, качества и
точности модели
Уравнение регрессии всегда дополняется
показателем тесноты связи. При использовании линейной регрессии в качестве
такого показателя выступает линейный коэффициент корреляции rxy,
который можно рассчитать по следующим формулам:
rxy, =  =
 Þ
rxy, = b

Линейный коэффициент корреляции находится в пределах: [-1; 1] . Чем ближе абсолютное значение rxy к единице, тем сильнее линейная связь между факторами (при rxy = ±1 имеем строгую функциональную зависимость). Но следует иметь в виду, что близость абсолютной величины линейного коэффициента корреляции к нулю еще не означает отсутствия связи между признаками. При другой (нелинейной) спецификации модели связь между признаками может оказаться достаточно тесной.
При нелинейных зависимостях лучше использовать
другой показатель - индекс корреляции  ,
тесно связанный с коэффициентом детерминации R2:
 =

где  =

 -
общая дисперсия результативного признака у;
 =
 -
остаточная дисперсия
Величина данного показателя находится в пределах: 0 ≤ ρxy ≤1.
Чем ближе значение индекса корреляции к единице, тем теснее связь рассматриваемых признаков, тем более надежно уравнение регрессии.
Квадрат индекса корреляции носит название
индекса детерминации и характеризует долю дисперсии результативного признака y
, объясняемую регрессией, в общей дисперсии результативного признака:
 ,
О качестве модели можно судить по относительным ошибкам (ошибкам аппроксимации). Нежелательно, чтобы относительные ошибки превышали 8 - 10% от уровня наблюдаемых у.
А. Линейная модель
rxy = b
= 0,81561 = 0,908
так как rxy  0,7
и положителен, то связь прямая и очень сильная.
Определим коэффициент детерминации:
R2
= 1 -  =
rxy2 = 0.8245
Изменение валового выпуска с/х продукции на 90,8% объясняется вариацией числа работников. Доля неучтенных факторов составляет 100 - 82,45 = 17,55%.
Контроль в программе Advenced Grapher 8.0
Формула: Y(x) = -0.1951671 + 0.815607x
Расчетная в задании: Y(x) = -0.1952 + 0.815617x
Стандартное отклонение: 1,442057;
R2 = 0.8252358
Б. Степенная модель
Индекс корреляции и коэффициент детерминации:
= =
 =
 0.956
R2 = 0,914
В случае степенной модели вариация валового выпуска на 95.6 % объясняется вариацией числа работников. Доля неучтенных факторов составляет 8.6 %.
Коэффициент детерминации степенной модели выше коэффициента детерминации линейной модели, но различия незначительны - менее 10 %. (6,2 %). Значение индекса близко к 1, что свидетельствует об очень сильной взаимосвязи исследуемых факторов.
Контроль в программе Advenced Grapher 8.0
Формула: Y(x) = 0,3571002*х1,3974895
Расчетная в задании: Y(x) = 0,3571*х1,3975
Стандартное отклонение: 1,9881345;
R2 = 0.9138602
В. Показательная модель
=  =
 0,852
R2 = 0,726
Связь в этой модели удовлетворительная
Контроль в программе Advenced Grapher 8.0
Формула: Y(x) = 0,8971571*2,450054х
Расчетная в задании: Y(x) = 0,897*2,46х
Стандартное отклонение: 3,0569256;
R2 = 0.7261552
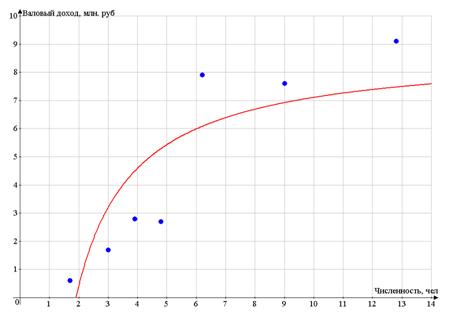
Г. Гиперболическая модель
= 
R2 = 0,7056
Связь в этой модели удовлетворительная.
Контроль в программе Advenced Grapher 8.0
Формула: Y(x) = 8,7815289 - 16,7377103/х
Расчетная в задании: Y(x) = 8,7815 - 16,7377/х
Стандартное отклонение: 1,8718524
R2 = 0,7055368
Вывод: Расчеты произведены правильно, о чем свидетельствуют данные стандартной расчетной Программы
Расчет относительных ошибок произведён в
предыдущих расчетах.
. Оценка статистической значимости
регрессионных уравнений
Статистическую значимость уравнений регрессии оцениваем при помощи критерия Фишера (F - тест).
Пусть основная гипотеза Н0 состоит в
предположении, что R2
= 0? А альтернативная Н1 - R2
 0.
Основная гипотеза Н0 принимается в том случае, если расчетная F-статистика
меньше критического значения:
Fфакт =

 Fкрит
(α,
df1
= m; df2
= n - m
- 1)
в противном случае принимается гипотеза Н1
где df - число степеней свободы;
m - число факторов в модели;
n - число наблюдений.
Для линейной модели:
Fфакт =
 =
23,49
Критическое значение критерия Фишера при уровне
значимости 0,05; m = 1; n
= 7 равна 5,59. Так как Fфакт
Fкрит,
то при доверии 95% принимается гипотеза Н1 о неслучайной природе выявленной
зависимости и статистической значимости показателей тесноты связи.
Для остальных моделей:
Степенная модель: Fфакт
=
 =
53,14
Показательная модель: Fфакт
=
 =
13,25
Гиперболическая модель: Fфакт
=
 =
11,98
Таким образом, все модели выдержали тест на
значимость, т. к. во всех случаях Fфакт
Fкрит.
Улучшение достоверности уменьшает критическую область: при уровне достоверности
α
= 0,01
критическое значение увеличивается до 12,25, и тогда в этом случае
гиперболическая модель отпадает.
Сравним регрессионные модели по всем показателям
и выделим лучшую
|
Сравнительный анализ характеристик регрессионных моделей |
||||
|
Модель |
Линейная |
Степенная |
Показательная |
Гиперболическая |
|
rxy/ |
0.908 |
0.956 |
0.852 |
0.840 |
|
R2/r2 |
0.8245 |
0.914 |
0.726 |
|
|
Э |
1.042% |
1.4% |
1.3% |
0.61% |
|
А |
38.74% |
17.49% |
36.76% |
81.712% |
|
F |
23.49 |
53.14 |
13.25 |
11.98 |

Показатели тесноты связи указывают, что очень сильная связь исследуемых признаков: числа работников х и валовой продукции у у степенной и линейной модели (лучшая степенная); у показательной и гиперболической моделей связь удовлетворительно тесная
Наибольший коэффициент детерминации у степенной модели - 0,914, отличие от линейной меньше 10%. Значительно отстают показательная и гиперболическая модели.
Степенная модель оказалась и более эластичной - 1,4%.
Наилучшим образом экспериментальные и теоретические значения результативного признака согласуются для степенной модели : А = 17,49%. Наихудшее согласование у гиперболической модели.
F-тест на значимость выдержали все модели при уровне значимости 0,05
Таким образом, для степенной модели получены наилучшие показатели тесноты связи.
Графики моделей приведены в предыдущих расчетах.
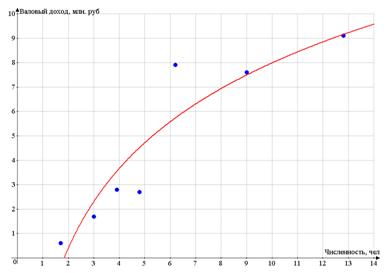
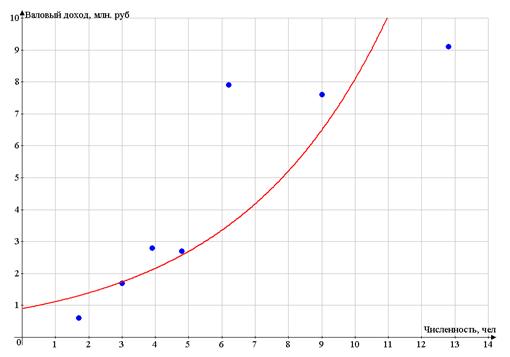
Программа Advenced Grapher 8/ 0 показывает ещё следующие возможные регрессионные модели:
Логарифмическая модель:
Y(x)
= 4.7189419*ln(x)
-2.8745813
Стандартное отклонение 1,2853802
R2 = 0.8611484
Экспотенциальная модель:
У(х) = 0,8971571*е0,22х
Стандартное отклонение: 3,0569228
R2 = 0.7261548
Полиноминальна модель
У(х) = -0,0714504х2 + 1,8598х - 2,9675345
Стандартное отклонение: 1,1326346
R2 = 0.8921867
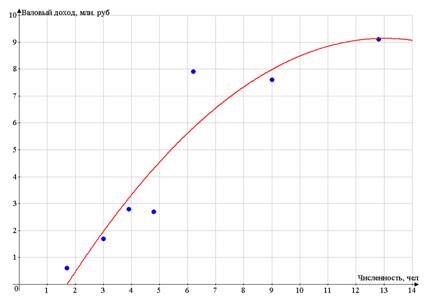
Лучшая
Y(x) = 0,0080221х6 - 0,2899243х5 + 4,0186219х4 - 27,2974512х3 + 95,8786377х2 - 163,8950124х + 106,6035793
R2 = 0.9861976
Стандартное отклонение: 0,040621
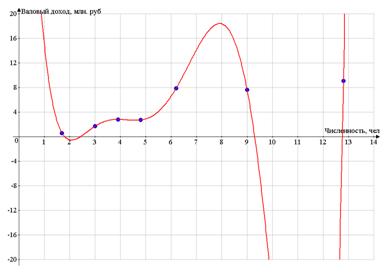
4. Составление прогноза
Прогноз валовой продукции выполняем по лучшей модели - степенной.
Вначале рассчитаем прогнозной значение числа
работников на уровне 90% от среднего значения:
хр = 0,9 = 0,9
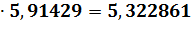
Точечный прогноз:
найдем значение ур подстановкой в
уравнение регрессии:
ур = 0,3571*5,3228611,3975 =
3,695
для построения доверительного интервала вычислим
предварительно среднюю стандартную ошибку прогноза mp
и предельную ошибку  .
= tтабл
 mp
mp
= σост
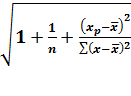
где σост
= 
для степенной модели остаточная сумма:  =
0,09586 в логарифмической форме, в действительной: 1,247, тогда
σост
=  =
0,4993 = 0,5
вычислим квадратичную сумму отклонений фактора х
от среднего значения:
 = n
 = 7 3.55706
= 24.89942
Стандартная ошибка прогноза:
mp = 0,5 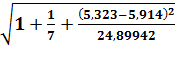 =
0,538
при уровне значимости 0,05 и степени свободы df
= 7 - 1 - 1 = 5 определим критическое значение критерия Стьюдента tтабл
=
2,57, следовательно, предельная ошибка
= tтабл
mp
=
2,57*0,538 = 1,382
Таким образом, можно определить нижнюю и верхнюю
границы доверительного интервала:
ymin = yp - =
3.695 - 1.382 = 2.313max = yp + =
3.695 + 1.382 = 5.077
выполненный прогноз достаточно надежен (95%), но
точность невысока, так как диапазон верхней и нижней границы доверительного
интервала составляет 5,077/2,313 = 2,2 раза.
Задача 2
По данным основных показателей производства с/х предприятий:
а. Построить матрицу коэффициентов корреляции;
б. Вычислить стандартизированные коэффициенты, ранжировать факторы по силе их влияния;
в. Построить линейное уравнение множественной регрессии в нормальном масштабе;
г. оценить тесноту связи факторов с результативным признаком;
д. оценить качество и адекватность модели;
е. оценить статистическую значимость уравнения в целом и целесообразность включения в модель каждого из факторов.
Число работников на 100 га пашни (х1), затраты
на производство продукции на 100 га пашни (х2) и валовая продукция в
сопоставимых ценах на 100 га пашни (у).
Дано:
|
№ п/п |
Площадь пашни, га |
Число работников, сот. чел |
Затраты на производство продукции, млн. руб. |
Валовый доход, млн. руб |
|
1 |
110 |
12,8 |
27,5 |
9,1 |
|
2 |
69 |
4,3 |
13,5 |
9,1 |
|
3 |
44 |
4,2 |
20,0 |
5,2 |
|
4 |
75 |
4,8 |
15,8 |
2,7 |
|
5 |
75 |
7,8 |
20,4 |
1,0 |
|
6 |
85 |
9,0 |
29,1 |
7,6 |
|
7 |
50 |
3,5 |
7,5 |
2,9 |
|
8 |
63 |
6,2 |
20,8 |
7,9 |
|
9 |
67 |
8,1 |
17,3 |
3,5 |
|
10 |
21 |
1,7 |
2,5 |
0,6 |
|
11 |
82 |
5,7 |
16,5 |
8,6 |
|
12 |
102 |
11,3 |
34,6 |
18,8 |
|
13 |
49 |
3,0 |
9,1 |
1,7 |
|
14 |
55 |
4,0 |
12,7 |
1,6 |
|
15 |
55 |
4,2 |
15,7 |
9,3 |
|
16 |
73 |
4,6 |
13,9 |
2,8 |
|
17 |
23 |
2,4 |
4,0 |
0,2 |
|
18 |
83 |
7,4 |
32,7 |
3,1 |
|
19 |
37 |
3,9 |
9,1 |
2,8 |
|
20 |
60 |
4,4 |
14,5 |
2,0 |