Материал: Глава 7
Выбор между пропорциональной и непропорциональной стратификацией исследователь осуществляет, исходя из содержательных и экономических соображений. Нужно, однако, иметь в виду некоторые «послевыборочные» последствия непропорционального отбора, с которыми социологи сталкиваются на стадии анализа 12. В частности, для получения более точных оценок распределения исследуемых переменных иногда приходится применять так называемое взвешивание (иногда употребляют термин «перевзвешивание»). Взвешивание используют также для того, чтобы исключить влияние некоторых типов систематического смещения в основе выборки и других типов систематической ошибки измерения (см. гл. 6). Например, взвешивание полезно для исключения смещений, возникающих из-за дублирования в списке-основе или, наоборот, из-за наличия систематических «пропусков» для какой-то одной группы (скажем, если в списке пропущено много пожилых людей, постоянно проживающих с детьми, но прописанных по другому адресу). Так как необходимость взвешивания чаще всего вызвана нарушением исходных соотношений, пропорций между входящими в целевую совокупность группами, мы опишем общую идею этой процедуры на примере непропорционального стратифицированного отбора.
Напомним, что к непропорциональной стратифицированной выборке прибегают в тех случаях, когда точность оценок для выборки в целом или для отдельных подгрупп (субпопуляций) внутри выборки оказывается недостаточной. В этом случае доли генеральной совокупности (f) будут различны для разных страт. Последнее утверждение равносильно признанию разной вероятности попадания в выборку для единиц, принадлежащих к разным стратам. Как совместить неравные вероятности отбора с данным нами выше определением вероятностной (случайной) выборки, в котором подчеркивалось равенство шансов попадания в выборку для всех входящих в генеральную совокупность еди-ниц-«случаев»? Некоторые статистики считают предложенное нами выше определение не вполне точным и предпочитают говорить о вероятностной выборке как о выборке, где каждая единица отбора имеет «известную, ненулевую вероятность быть включенной в выборку»13, хотя шансы для различных единиц не обязательно равны. Существующее многообразие определений вероятностной выборки восходит к давней дискуссии о правомерности выводов, основанных на априорных («до») и апостериорных («после испытания») вероят-
12 Обсуждение «послевыборочных» последствий различных процедур отбора можно найти, в частности, в книге: Henry G. Т. Practical sampling (Appl. Research Methods Series. Vol. 21). Newbury Park etc.: Sage, 1990. Ch. 8.
13 Henry G. Т. Op. cit. P. 25.
ностях. Мы, однако, сохраним наше определение случайной выборки, внеся в него некоторое уточнение: когда шансы попадания в выборку неравны, как при непропорциональном отборе из страт, они могут быть выровнены при помощи взвешивания на стадии анализа, т. е. на собственно послевыборочной стадии исследования (конечно, если отбор внутри страт сохраняет свой случайный и равновероятный характер). Для этого нужно внести определенные поправки в полученные данные, а именно—приписать некоторым наблюдениям (классам наблюдений) больший «вес», компенсирующий меньшие шансы попадания в выборку (и наоборот).
Результатом приписывания веса каждому наблюдению является увеличение точности оценок для исследуемых параметров. Вес каждой единицы (респондента) в k-й страте равен отношению числа таких элементов в генеральной совокупности к объему выборки для k-й страты 14, т. е.:
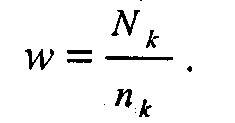
При расчете среднего или других параметров (см. гл. 8) каждое наблюдавшееся значение просто умножается на весовой коэффициент «своей» страты.
В частности, среднее значение какого-то параметра совокупности (например, средний доход или среднее количество хронических заболеваний) будет равняться просто взвешенной сумме средних значений для отдельных страт:
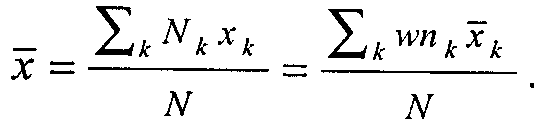
Формула расчета стандартной ошибки (см. гл. 8) для стратифицированной выборки также включает в себя весовые коэффициенты, w:
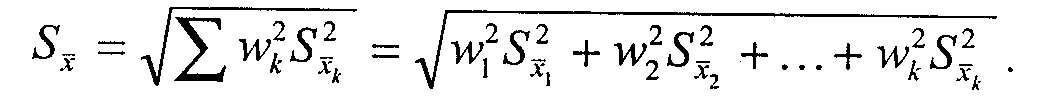
Стандартные компьютерные программы, используемые при статистическом анализе данных, всегда содержат элементарные процедуры взвешивания.
Вернемся к нашему примеру с непропорциональным стратифицированным отбором русского и украинского населения. Предположим, мы выяснили, что в среднем каждая украинская семья заготавливает на зиму 50 кг варенья, тогда как среднее значение для русской страты составило 40 кг. Для украинской страты весовой коэффициент составит:
wукр. =10000:400=25.
Соответственно для русского населения:
w русск. = 80000 : 400 = 200.
С учетом этих весовых коэффициентов уточненная оценка среднего запаса варенья в выборке составит:
х = 25 • 50 • 400 + 200 • 40 • 400 / 100000 = 37 кг. Если бы мы не учли в своих расчетах сверхпредставительность украинцев в нашей непропорциональной стратифицированной выборке, то оценка среднего запаса варенья для всей совокупности оказалась бы завышенной (45 кг).
14 Подробнее см.: Sudman s, Applied sampling. N. Y.: Academic Press, 1975. P. 126—130.
Четвертый тип вероятностной выборки, используемой социологами,— это кластерная выборка. «Кластеры» (дословно с англ.—гроздья)—это естественные группировки единиц наблюдения. Например, популяция избирателей имеет тенденцию жить в городах и деревнях, генеральная совокупность военнослужащих естественным образом группируется по воинским частям и подразделениям, а совокупность студентов — по университетам, институтам и колледжам. Способность к образованию локальных группировок, которую обнаруживают генеральные совокупности, изучаемые социологами, при соблюдении ряда условий позволяет уменьшить расходы на получение единицы информации.
Цель использования кластерной выборки таким образом заключается в повышении эффективности затрат на проведение исследования. При фиксированном бюджете и объеме выборки социолог получает возможность снизить общие расходы на проведение личных интервью преимущественно за счет уменьшения транспортных расходов15.
В общем случае кластерная выборка основана на первоначальном отборе группировок (кластеров) и затем — на изучении всех единиц внутри кластеров. Возможными примерами кластеров, используемых в больших общенациональных опросах, являются сельские районы, городские квартиры, избирательные участки. При изучении специфических популяций используются иные кластеры: больницы — при изучении пациентов, школы — при изучении школьников и т. п.
Корректное применение кластерной процедуры основано на неукоснительном соблюдении четырех необходимых условий16:
1) кластеры должны быть однозначно и явно заданы: каждый член генеральной совокупности должен принадлежать к одному (и только одному) кластеру;
2) число членов генеральной совокупности, входящих в каждый кластер, должно быть известно или поддаваться оценке с приемлемой степенью точности;
3) кластеры должны быть не слишком велики и географически компактны, иначе кластерная выборка теряет всякий финансовый смысл;
4) выбор кластеров должен быть осуществлен таким способом, который минимизирует рост выборочной ошибки (последний процесс, в свою очередь, является неизбежным следствием кластеризации).
Для того чтобы уяснить, как именно кластерная процедура влияет на рост выборочной ошибки, рассмотрим ее на простейшем примере. Допустим, мы изучаем труд и занятость жителей небольшого сельского района. Для того чтобы составить полный список-основу для случайной выборки, нам пришлось бы предварительно посетить все сельские советы, а в некоторых случаях — и весьма отдаленные деревни. Располагая ограниченными ресурсами, мы решаем использовать имеющуюся в нашем распоряжении карту района, на которой отмечены все населенные пункты, включая самые небольшие хутора. Известна и
15 Соответственно использование кластерной процедуры отбора лишено смысла при проведении почтовых опросов, централизованных телефонных интервью и локальных обследований.
16 Sudman S. Op. cit. P. 70.
численность населения для каждого пункта. Естественными границами кластеров-поселений являются шоссе и проселочные дороги. Составив список всех 40 деревень и хуторов, мы можем теперь без труда осуществить простую случайную выборку кластеров. Для отдельного поселения вероятность попадания в выборку составит 1/40 . Если, например, мы собираемся опросить 200 человек, нам, скорее всего, потребуется отобрать 1—2 кластера-поселения. Отметим здесь, что естественные различия в величине кластеров17 никак не влияют на процедуру кластерного отбора.
Что при этом происходит с выборочной ошибкой и, следовательно, с получаемыми в нашем исследовании статистическими параметрами генеральной совокупности сельского населения района (т. е. с оценками возраста, дохода и т. п.)? Чтобы ответить на этот вопрос, мы должны ввести еще одно статистическое понятие «независимых наблюдений» (степеней свободы).
Предположим, мы хотим оценить соотношение работающих и пенсионеров в обследуемом нами районе. Мы отобрали, условно, три деревни по 30 домовладений каждая (итого 90 домовладений). Однако в ходе опроса выясняется, что в двух деревнях, не входящих ни в одно сельхозобъединение или кооператив, живут исключительно старики-пенсионеры, а в одной, построенной недавно для переселенцев из Средней Азии, живут только молодые семьи с детьми. Таким образом, каждая деревня является населенной либо только работающими семейными парами, либо исключительно «пенсионерской». В результате мы можем заранее предсказать результат обследования каждой деревни (кластера), посетив лишь один дом. Если в первом доме интервьюер обнаружит чету пенсионеров, во всех остальных домах тоже будут жить пенсионеры. Если в первом доме живут люди трудоспособного возраста, посещение остальных 29 домовладений приведет к тому же результату. Фактически для каждой деревни мы будем располагать одним независимым наблюдением и, посетив 90 семей в трех деревнях, получим лишь три независимых, информативных наблюдения относительно распределения работающих и пенсионеров в выборке. Соответственно наши оценки величины данного соотношения в генеральной совокупности окажутся более неточными, чем в случае 90 независимых наблюдений. Причина возникающей ошибки заключается в том, что использованные нами кластеры (деревни) оказались гомогенными, однородными по исследуемому признаку трудовой занятости, хотя по другим признакам, например, по политической активности, они вполне могут быть гетерогенными, неоднородными. В принципе можно показать, что рост выборочной ошибки для кластерной выборки (в сравнении с простой случайной) является функцией двух переменных — величины кластеров и гомогенности исследуемого признака внутри каждого кластера18.
Ясно, что оценка гомогенности часто становится важной практической задачей в планировании кластерной выборки. Основная проблема здесь заключается в том, что соответствующими данными о распределении признаков внутри кластеров исследователь располагает после завершения собственно полевой стадии. Практически при проектировании выборки обычно основываются на уже существующих данных предыдущих исследований, переписей и т. п. Мера го-
17 В нашем случае так называемой территориальной кластерной выборки таковыми являются различия в численности населения отдельных деревень и хуторов.
18 См.: Sudman S. Op. cit. P. 73—78.
Таблица 7.2 Значения мер гомогенности р для кластеров, состоящих из домовладений (для основных социально-демографических параметров) |
||||
Параметр |
Значение р для кластера, имеющего средний размер п |
|||
п=3 |
п=9 |
п=Т1 |
n=62 |
|
Доля домовладений: — находящихся в личной собственности; |
,170 |
,171 |
,161 |
,096 |
— наемных, с низкой квартплатой; |
,235 |
,169 |
,107 |
,062 |
— наемных, с высокой квартплатой; |
,430 |
,349 |
,243 |
,112 |
|
|
|
||
Среднее количество жильцов |
,230 |
,186 |
,142 |
,066 |
|
|
|
|
|
Доля среди жильцов: |
|
|
|
|
— белых мужчин |
,100 |
,088 |
,077 |
,058 |
— безработных мужчин |
,060 |
,070 |
,045 |
,034 |
— мужчин в возрасте 25—34 лет |
,045 |
,026 |
,018 |
,008 |
могенности р ведет себя так же, как соответствующий коэффициент корреляции. Величина р — это корреляция между значениями признака для всех возможных парных сочетаний элементов, входящих в кластер. Эта величина обычно положительна и возрастает с ростом гомогенности элементов внутри кластера. Если наблюдения внутри кластера абсолютно независимы (как в примере случайного распределения между разными кластерами), то р = 0. При использовании территориальной кластерной выборки городского населения, например при отборе кварталов или многоэтажных домов, р для признаков экономического статуса может быть весьма высоким из-за «пороговых» эффектов:
в престижном кооперативном доме маловероятно встретить семьи с очень низкими доходами (верхний порог) и, наоборот, лишь немногие состоятельные люди обитают в коммуналках, подобно герою «Золотого теленка» Александру Ивановичу Корейко (нижний порог).
Ориентировочное представление о типичных значениях р и их изменении для кластеров разной величины для общенационального выборочного исследования дает табл. 7.2. В таблице показаны величины р для имеющих разные размеры кластеров, составленных из соседних городских домовладений (квартир и домов). Данные таблицы основаны на выборке городского населения США (N>100000)19.
Еще одной немаловажной практической проблемой в планировании кластерной либо стратифицированной выборки является сравнение эффективности