Дипломная (вкр): Проблематика прогнозирования спроса
Один из статистических критериев для проверки наличия
гетероскедастичности (то есть непостоянной дисперсии) случайных ошибок модели
линейной регрессии - Критерий Бройша-Пагана. Применяется, если есть основания
полагать, что дисперсия ошибок  может зависеть от некоторой совокупности наблюдаемых
переменных:
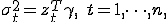 , где
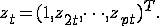 .
Проверяемая гипотеза сформулирована следующим образом:
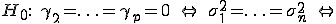 остатки гомоскедастичны;
Альтернативная гипотеза:
 неверна (остатки гетероскедастичны).
Процедуру вычисления статистики можно описать следующими шагами.
1) Начальная модель

оценивается стандартным методом наименьших квадратов
(МНК), определяются остатки  .
2) Предположив гомоскедастичность модели, дисперсия ее
ошибки вычисляется как
 .
) Вычисляются стандартизированные остатки  .
4) Производится построение дополнительной регрессия
квадратов стандартизированных ошибок на начальные значения предикаторов:
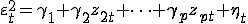 .
)  ,
где  - коэффициент детерминации построенной на предыдущем этапе
регрессии.
Если статистика критерия имеет распределение
хи-квадрат с  степенями свободы, то гипотеза о гомоскедастичности остатков
подтверждается.
.2.4 Проверка качества модели
Проверка адекватности модели или, другими словами, тестирование значимости объясняющей переменной X проводится по критерию Фишера. Другими словами, проверяется, значимо ли влияние предикатора X влияет на значение объясняемой переменной Y.
Используя суммы квадратов отклонений, вычислим F-критерий Фишера по
формуле:
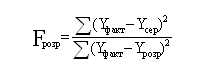
При учете степеней свободы расчетная формула для вычисления критерия
Фишера выглядит следующим образом:
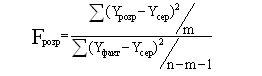
где m, (n-m-1) - число степеней свободы числителя и знаменателя зависимости соответственно; n - количество наблюдений; m - количество предикаторов.
Тестирование значимости переменной X по критерию Фишера состоит из следующих этапов:
. Формулируем нулевую гипотезу H: β1=0;
2. Принимаем вероятность ошибки (уровень значимости) α (5%);
3. Производим вычисления F-отношения;
. Из таблицы F-распределения Фишера определяем величину F-критическое при заданном уровне значимости (или ошибки) и по степеням свободы f1 и f2;
. Если Fфакт < Fтабл то гипотезу о незначимости предикатора отклоняем с 5%-ным риском ошибиться, где Fтабл - значение F при 5%-ном риске ошибки.
Значение Fтабл определяют по специальным таблицам в зависимости от степеней свободы f1 и f2:
=(n-m-1), f2=(n-1).
Если неравенство Fфакт > Fтабл справедливо, то можно сделать заключение об адекватности построенной модели, следовательно линейная связь между предикатором и объясняемой переменной допустима.
Итоговое оценочное значение качества модели отражается в коэффициент
детерминации R². Если регрессия является парной, коэффициент детерминации
будет совпадать с квадратом коэффициента корреляции:
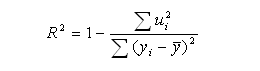
где u²i - разница между исходным значением Y и предсказанным значением с помощью построенной модели.
Коэффициент детерминации определяет долю разброса объясняемой переменной, которая определяется регрессией Y на X; дробное отношение определяет составляющую часть разброса объясняемой переменной, которая не определяется регрессией.
Для общего случая корректным является соотношение 0≤R²≤1. Чем ближе коэффициент детерминации к единице, тем сильнее линейная связь между X и Y. Чем связь слабее, тем R² ближе к нулю.
Средняя ошибка аппроксимации - еще одно средство оценки уравнения регрессии является.
Фактические значения результативного признака отличаются от теоретических, вычисленных по уравнению регрессии, т.е. y и yx. Чем меньше эта разность, тем теснее теоретические значения к эмпирическим данным, качество модели лучше.
Средняя ошибка аппроксимации рассчитывается по следующей формуле:
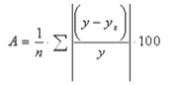
Для качественно построенных моделей, величина этого показателя не должно превышать 10%.
.3 Программное обеспечение для анализа модели
.3.1 Статистические пакеты для анализа данных
В связи с ростом потребности статистического анализа данных практически во всех сферах деятельность, а особенно в научной, рынок программного обеспечения для статистической обработки данных стремительно развивался. В течение последних 20 лет компьютерные программы, способные статистически анализировать большие объемы данных для прогнозирования событий, оценки вероятных альтернатив выбора, выявления закономерностей, сделали большой шаг в своем развитии. Постоянно ведутся работы по совершенствованию программ в части сокращения времени работы с данными, повышения качества представления отчетов с результатами, модернизации интерфейса, актуализации справочной информации, добавления новых статистических методов, процедур и прочего.
Рынок программного обеспечения развивается стремительными темпами. Задачи по обработке данных разнообразны, для их решения применяются разноплановые типы статистических процедур анализа для получения ответов на вопросы по всем областям деятельности. Все это вызвало появление большого разнообразия статистических пакетов. На текущий момент на рынке можно встретить порядка тысячи статистических пакетов (компьютерных программ) для обработки данных.
Для рынка ПО для статистического анализа данных характерна высокая конкуренция, зачастую происходит объединение или поглощение компаний по разработке программ. К примеру, один из лидеров на рынке компания SPSS Inc. поглотила компанию SYSTAT Software Inc в 1994 году, а в 1996 году - BMDP Statistical Software Inc. За счет данных "покупок" компания повысила качество своих продуктов. Приобретение SYSTAT позволило оптимизировать процедуру обработки и анализа данных, а поглощение BMDP Software - улучшить графические инструментарий SPSS. В 2009 году компанию IBM Inc. поглотила компанию SPSS Inc.
Пользователю каждый раз необходимо выбирать оптимальный и подходящий для него статистический пакет, исходя из поставленного круга задач. Ни для кого не секрет, что оптимальным является вариант, комбинирующий в себе высокий уровень работы, нужные функциональные возможности и умеренную цену. При выборе важно обратить внимание на следующие характеристики:
· соответствие параметрам поставленных задач;
· объем данных для статистического анализа;
· квалификация пользователя в области статистики (уровень знаний);
· соответствие компьютерного оборудования пользователя.
По функциональности программы для статистического анализа можно разделить на 3 основные группы.
1. Универсальные пакеты, или пакеты общего назначения (например, Minitab, STATISTICA, STATA, S-PLUS, STATGRAPHICS, Stadia, SYSTAT, SPSS).
Данные программы не заточены под определенную предметную область, их можно применять для анализа данных в различных областях деятельности. В основном в этих программах используется простой интерфейс и предложен широкий спектр статистических методов и процедур. Как правило, с подобными статистическими пакетами работают начинающие пользователи, обладающие начальным уровнем знаний в статистике, или же опытные пользователи, которые находятся на начальном этапе работы и с набором статистических методов еще не определились. Возможность использовать широкий спектр статистических методов для пробного анализа различных типов данных делает данный пакет многопрофильным и универсальным. Практические все универсальные пакеты имеют ряд схожих друг с другом встроенных статистических процедур.
Каждый универсальный статистический пакет должен соответствовать следующему перечню требований:
o иметь достаточно широкий перечень встроенных стандартных методов и процедур для статистического анализа.;
o быть понятным для "новичка" в освоении интерфейса и применении различных методов анализа;
o быть способным обрабатывать большие базами данных и соответствовать высоким требованиям к хранению данных;
o иметь стандартизированный вид представления данных для их последующего использования в других пакетах анализа и базах данных;
o иметь в наличии широкий выбор в графическом представлении данных и результатов анализа;
o иметь некую базу знаний, или справочную систему, в которой пользователь сможет найти ответы на свои вопросы по использованию пакета; иметь документационное.
2. Профессиональные пакеты (например, BMDP, SAS).
Основное отличие профессиональных пакетов от универсальных в том, что первые позволяют обрабатывать гораздо больший объем данных, имеют более узкоспециализированные методы, есть возможность для создания своей системы для обработки данных. Зачастую, такие пакеты сложны для начинающих пользователей. Для профессионалов, наоборот, подобные пакеты предоставляют дополнительный широкий круг возможностей для более подробного анализа данных, исходя из своих потребностей к построенным моделям. Конечно, такие возможности добавляют к себестоимости, и профессиональные пакеты являются более дорогостоящи. Ценовой фактор препятствует широкому распространению использования профессиональных статистических пакетов в различных областях деятельности.
3. Специализированные пакеты (например, DATASCOPE, BioStat, MESOSAUR).
Существуют некоторые области деятельности, исследуемые данные которых специфичны и отличны от других, требуют применения соответствующих специфических методов, которых нет в универсальных пакетах.
Специализированные пакеты предназначены для проведения анализа данных отдельно взятой предметной области с применением узкого круга специализированных статистических процедур. Подобные пакеты используют высококвалифицированные специалисты соответствующей предметной области. Приведем примеры существующих специализированных пакетов:
· BioStat - нацелен на анализ данных в области биологии и медицины.
· MESOSAUR - отечественный статистический пакет, используется при анализе одномерных и многомерных временных рядов и построении регрессионных моделей.
· DATASCOPE - российский статистический пакет, используется при анализе многомерных данных.
В случаях необходимости систематического решения для конкретной области или решения с использованием ограниченного набора сложных статистических методов, следует использовать соответствующий специализированный пакет.
Преобладающее количество существующих на рынке статистических пакетов имеют гибкую модульную структуру, которую можно изменять и дополнять за счет установки дополнительных плагинов (модулей), представленных для покупки или свободного скачивания в Интернете. Данная способность способствует адаптации пакета к требованиям конкретного пользователя.
Перечень минимальных требований, которым должен соответствовать каждый статистический пакет:
· модульность;
· ассистирование при выборе способа обработки данных;
· использование простого проблемно-ориентированного языка для формулировки задания пользователя;
· автоматическая организация процесса обработки данных;
· ведение банка данных пользователя и составление отчета о результатах проделанного анализа;
· диалоговый режим работы пользователя с пакетом;
· совместимость с другим программным обеспечением.
Как правило, постоянно ведется поддержка существующих статистических пакетов. Каждая последующая версия приобретает новые возможности для анализа (добавление новых методов), не теряя при этом старый функционал. Новые версии зачастую остаются с начальным названием, меняется лишь порядковый номер версии. Распространенные пакеты поддерживают мультиязычность.
Каждая команда разработчиков рекламирует свой
статистический пакет, как самый наилучший для анализа данных. При широком
выборе зачастую сложно выбрать правильный пакет. В любом случае, статистический
пакет лишь инструмент в руках аналитика. Если специалист не компетентен в
конкретной области, то никакой совершенный пакет не поможет ему проделать
качественный анализ. С другой стороны, неверно выбранный пакет может сильно
затруднить процесс работы даже высококвалифицированного специалиста.
Таблица 2.1. Статистические пакеты
|
Универсальные пакеты или пакеты общего назначения |
Профессиональные пакеты |
Специализированные пакеты |
|
SPSS, STATA, STATISTICA, Stadia, STATGRAPHICS, Minitab |
SAS |
BioStat |
Ниже приведен минимальный набор статистических методов, который включены в каждый наиболее известный программный продукт, предназначенный для статистической обработки данных и относящихся к упомянутым ранее трем основным группам программ (таб. 2.1).
· описательная статистика (базовые статистические методы, проверка нормальности распределения данных);
· дисперсионный анализ;
· кластерный анализ;
· непараметрическая статистика (анализ таблиц сопряженности, непараметрические сравнения, дисперсионный анализ);
· контроль качества;
· обработка данных (сортировка, трансформация данных, отбор);
· дискриминантный анализ;
· регрессионный анализ;
· факторный анализ.
.3.2 Пакет SPSS
Statistical Package for the Social Sciences (далее пакет SРSS) - один из универсальных статистических пакетов, который был разработан компанией SРSS Inc. Первая версия продукта была представлена еще в 1968 году. В 2009 году, после поглощения компанией IBM, название пакета включает в свое название аббревиатуру IBM (IBM SPSS Statistics).
Команда разработчиков статистического данного пакета считает, что их программный продукт занимает одну из лидирующих позиций среди существующих по части решения вопросов при анализе данных в академической, правительственной и бизнессфере.РSS относится к типу многомодульной программы. В стартовом пакете идет SPSS Base (базовый модуль), который предоставляет возможность управлять данными и содержит основные методы статистического анализа, перечисленные в предыдущей главе. Чтобы проделать более широкий и глубокий анализ данных, дополнительно потребуется установить модули пакета. Для 19 версии пакета IBM SPSS Statistics существует шестнадцать дополнительных модулей. Например, модуль Advanced Statistics позволяет проводить глубокий анализ взаимосвязей, процедуры, которые способны учитывать свойства данных. Также в модуле присутствуют мощные инструменты для создания моделей. Подобной возможности в базовом модуле нет. Среди разработанных модулей есть модуль Direct Marketing, с помощью которого маркетологи могут самостоятельно проводить основные виды анализа. Модуль Bootstrapping предоставляет специалистам возможность тестировать модель на устойчивость. Модуль Data Entry облегчает процедуру создания анкет и заполнения результатов, автоматизируя его.