Дипломная (вкр): Проблематика прогнозирования спроса
Достоинства SPSS:
· мощный аппарат статистического анализа;
· пакет относится к универсальным (возможность использовать широкий спектр статистических методов для анализа различных типов данных в разных областях деятельности);
· большой ряд статистических и графических процедур и методов (свыше 50 типов диаграмм) для анализа данных исоздания отчетов;
· понятный для пользователя интерфейс, высокая производительность;
· открытый доступ для свободного скачивания пробной версии программного продукта на официальном сайте, поддержка мультиязычности;
· совместимость с ОС Windows, Mac, Linux;
· наличие достаточного количества справочной информации, литературы по работе с пакетом.
Недостатки SPSS:
· для хорошей работы пакета необходима высокая производительная мощность компьютера;
· в сравнении с аналогичными статистическими пакетами относительно высокая стоимость.
В последнюю на данный момент версию пакета добавлены следующие возможности:
· возможность импортировать данные из SAS и MS Excel;
· возможность экспортировать результаты в MS Office, PDF; сохранение результатов в формате HTML;
· способность обрабатывать несколько наборов данных одновременно;
· возможность создания диаграммы для переменных с несколькими ответами;
· возможность создания диаграммы с двумя осями ординат;
· модернизированный редактор синтаксиса для самостоятельного написания скриптов (поддержка автозавершения, цветовое кодирование команд);
· с помощью Data Preparation осуществляется быстрая подготовка данных к анализу, что способствует облегчению процедуры ручного анализа данных, выявляя, объясняя и исправляя недочеты. С помощью указанной функции подготовки данных возможно построить различные отчеты по существующим данным.
На рисунке 2.1 отображено окно редактора данных SPSS.
В нижней части окна по центру расположены две вкладки: Данные и Переменные,
позволяющие переключаться с режима просмотра/редактирования значений переменных
в режим просмотра/редактирования их характеристик.
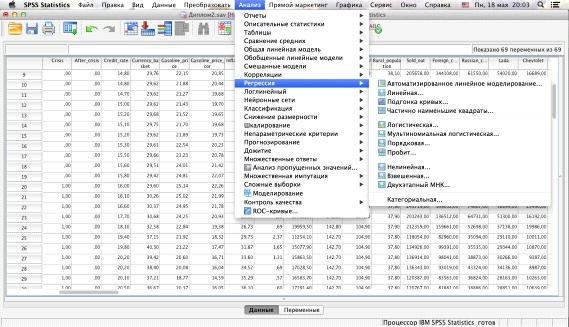
Рисунок 2.1. Окно редактора данных SPSS
Результаты статистического анализа приводятся в
диалоговом окне под названием Вывод (рис. 2.2).
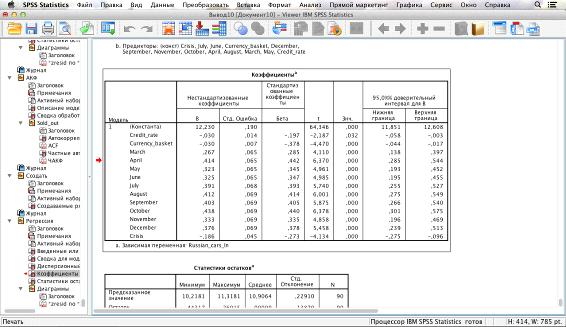
Рисунок 2.2. Окно вывода SPSS
В качестве основного программного обеспечения, используемого в течение практической работы, выступает статистический пакет SPSS.
SPSS обеспечивает достаточный инструментарий обработки данных, позволяет выполнять регрессионный анализ и строить прогностические модели. С помощью этого программного средства можно очень быстро выявить наличие статистической зависимости в анализируемых данных и затем, используя полученные взаимосвязи, сделать прогноз изучаемых показателей.
Глава 3. Построенные эконометрические модели спроса на зарубежные и отечественные автомобили в России
В построении модели спроса использованы количественные переменные:
) Credite_rate - средневзвешанная процентная ставка по кредитам, предоставленными кредитными организациями физическим лицам на срок свыше 1 года, %
) Currency_basket - бивалютная корзина, руб
) Cosoline_price -розничная цена на бензин АИ-95, руб/л
) Average income - среднедушевой доход, руб/месяц 5) Population - численность населения
) Inflation_dynamic - динамика инфляции, %
Для наблюдения сезонности продаж в процессе построения модели будут добавлены 11 номинальных переменных: February, March, April, May, June, July, August, September, October, November, December. Фиктивная переменная принимает значение 1 в соответствующем названию периоду наблюдения, во всех остальных случаях - 0.
Также в модель будут добавлены две фиктивные переменные: Crisis и After_crisis. Переменная Crisis будет равна 1, если на момент наблюдения в стране будет финансовый кризис. After_crisis равна 1, если кризис закончился и начался послекризисный период. Во всех остальных случаях значения этих переменных принимают значение 0. В работе период кризиса напрямую отражает падение фондового рынка.
.1 Анализ парных корреляций
Так как для построения модели используются переменные с количественными
шкалами, используем коэффициент корреляции Пирсона. Высоким коэффициент
корреляции принимаем при значении коэффициента большем 0.75.
Таблица 3.1. Парные корреляции независимых переменных
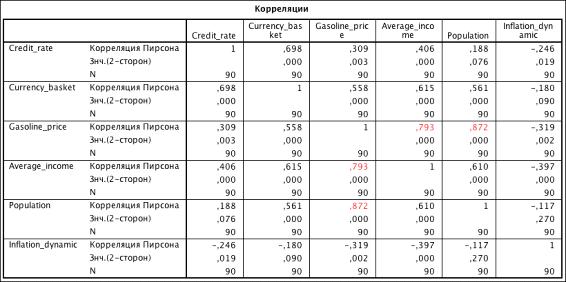
Из таблицы 3.1 видно, что следующие переменные имеют наивысший
коэффициент корреляции: Population и Gasoline_price. В значениях данных
переменных наблюдается тендеция увеличения, можем сделать вывод о наличии
временной зависимости. Избавимся от нее, убрав тренд из переменных
Gasoline_price и Population. Разберем процедуру избавления от тренда на примере
переменной Gasoline_price. Представим зависимость розничной цены на бензин y от времени t в виде линейной модели первого порядка:
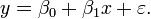
β0 и β1 - параметры модели, а ε - ошибка, распределение которой подчиняется нормальному закону с нулевым средним значением и постоянным отклонением σ2.
Построим линейную регрессию, где зависимой переменной будет Gasoline_price, независимой - Time (ряд натуральных чисел от 1 до 90, соответствующий номеру наблюдения).
Таким образом мы можем записать:
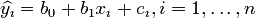
Где  означает предсказанное моделью значение y при данном x,
b0 и b1 - выборочные оценки параметров
модели, а

значения ошибок аппроксимации.
Убрав из уравнения b1xi, мы избавимся от явления тренда для переменной Gasoline_price. Рассчитаем новую переменную Gasoline_price_cor,
как значение y без b1xi. Проделаем аналогичную процедуру для
Population, получим скорректированную переменную Population_cor. Вновь построим
таблицу парных корреляций для проверки зависимости переменных друг от друга.
Таблица 3.2. Парные корреляции независимых переменных
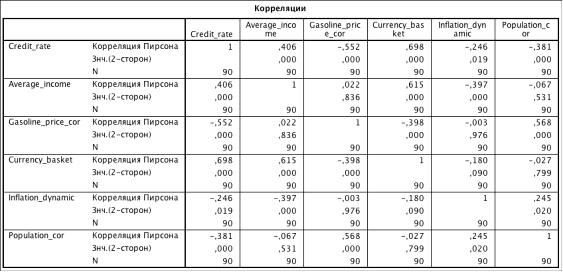
Из таблицы 3.2 видно, что убрав тренд из переменных Gasoline_price и Population, избавились от корреляционной зависимости. Все коэффициенты меньше 0.75 - можно использовать переменные для построения модели прогноза уровня продаж.
При построении моделей спроса вместо переменных Gasoline_price и Population будут использоваться скорректированные переменные Gasoline_price_cor и Population_cor соответственно.
.2 Модель общего спроса на автомобили в России
.2.1 Построение модели
Зависимая переменная: Sold_out - общее кол-во продаж автомобилей в России за период
Отбор переменных
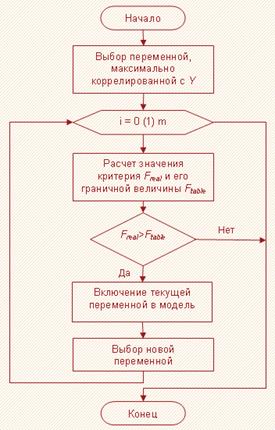
Рисунок 3.1.Блок-схема метода Forward Selection
Методом прямого отбора (рис. 3.1) определим переменные, которые будут
использованы при построении модели. Фактор, который сильнее всего коррелирован
с результирующим признаком, имеет больший приоритет на включение в модель.
Таблица 3.3.Корреляция входных переменных с результирующим признаком
|
|
Credit_rate |
Currency_basket |
Gasoline_price_cor |
Average_income |
Population_cor |
Inflatiom_dynamic |
|
Sold_out |
-0,359 |
-0,213 |
0,604 |
0,404 |
0,163 |
-0,179 |
Из таблицы 3.3 видно, наибольшая тесная связь с зависимой переменной
наблюдается у показателя Gasoline_price_cor. Следуя алгоритму метода прямого отбора эту
переменную в первую очередь следует проверить на включение в модель. Вычислим
оценки значений результирующего признака, которые получим из модели, включающую
в себя одну переменную Gasoline_price_cor. Результаты сведены в таблицу:
Таблица 3.4.Расчетные данные для проверки переменной на включение в модель
|
№ |
Gasoline_proce_cor (X) |
Sold_out (Y) |
Pred_Sold (Ŷ) |
Yср |
(Ŷ - Yср)^2 |
(Y - Ŷ)^2 |
|
1 |
20,01 |
117256 |
217657,7922 |
202988,1444 |
215198566,2 |
10080519883 |
|
2 |
20,9 |
130675 |
237946,7571 |
202988,1444 |
1222104599 |
11507229871 |
|
3 |
20,76 |
179057 |
234682,7005 |
202988,1444 |
1004544885 |
3094218558 |
|
4 |
20,52 |
201867 |
229380,4017 |
202988,1444 |
696551243,6 |
756987273,7 |
|
5 |
20,48 |
204478 |
228381,0587 |
202988,1444 |
644800095,9 |
571356216,6 |
|
6 |
20,59 |
199013 |
230778,7862 |
202988,1444 |
772319767 |
1009065170 |
|
7 |
20,85 |
211110 |
236800,0553 |
202988,1444 |
1143245318 |
659978943,4 |
|
8 |
21,15 |
218150 |
243500,7386 |
202988,1444 |
1641270286 |
642659948,1 |
|
… |
… |
… |
… |
… |
… |
… |
|
90 |
20,65 |
199398 |
232213,6789 |
202988,1444 |
854131866,6 |
1076868784 |
|
|
|
|
|
Итого |
89323437298 |
1,55132E+11 |
Исходя из данных таблицы 3.4 расcчитаем величину частного F-критерия, соответствующую Gasoline_price_cor.
MSE = SSE/df = 1,55132E+11/88 = 1762859429real =
SSR / MSE = 89323437298 / 1762859429 = 50,66963131
По таблице значений F-критерия Фишера (Приложение 2)на уровне значимости α = 0,05 найдем граничное значение для Freal (при количестве степеней свободы d1 = 1 и d2 = 88).
Ftable = 3.95
Freal > Ftable
Рассчитанное значение F-критерия существенно превышает пороговое значение Ftable, что указывает на необходимость включения переменной X2 в регрессионную модель (при этом вероятность того, что решение о включении окажется неправильным, составляет α = 0,05).
В таблице 3.5 отображены рассчитанные значения F-критерия для остальных независимых переменных в порядке
убывания их корреляционной зависимости от объясняющей переменной
Таблица 3.5. Рассчетные значения F-критериев для каждой переменной
|
Переменная |
Freal |
Ftable |
|
Gasoline_price_cor |
50,67 |
3.95 |
|
Average_income_cor |
17,189 |
3.95 |
|
Credit_rate |
13,058 |
3.95 |
|
Currency_basket |
4,184 |
3.95 |
|
Inflation_dynamic |
2,918 |
3.95 |
В ходе метода прямого отбора мы отобрали все объясняющие переменные, за исключением Infation_dynamic и Population_cor, так как их Freal < Ftable. Использовав метод обратного отбора, можно было сократить количество итераций алгоритма.
Выявление зависимости спроса от сезона
Построим модель линейной регрессии, где зависящей переменной будет Sold_out, а объясняющими - отобранные переменные, а также
переменные, отвечающие за сезонность. Согласно t-таблице (Приложение 1), коэффициент для нашей модели будет
значимым, если модуль его значения t будет больше 1,98. Вероятность того, что решение о включении окажется
неправильным, составляет α = 0,05.
Таблица 3.6. Коэффициенты модели (R2 = 0.770)
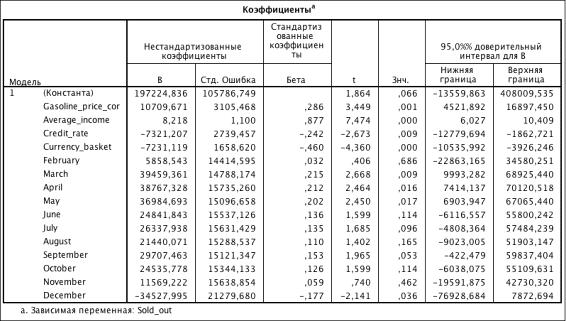
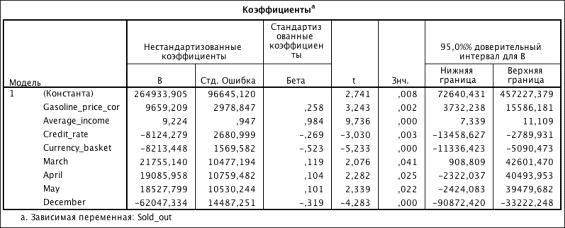
Исключим из модели фиктивные переменные, которые незначимы: February,
June, July, August, September, October, November. Построим новую модель.
Таблица 3.7. Коэффициенты модели (R2 = 0.762)
Проверка значимости квадратичной формы переменных
Для проверки функциональности количественных переменных будем поочередно включать их квадратичное значение в модель, проверять значимость.
) Включаем Credit_rate_sqr:
Таблица 3.8. Коэффициенты модели (R2 = 0.757)
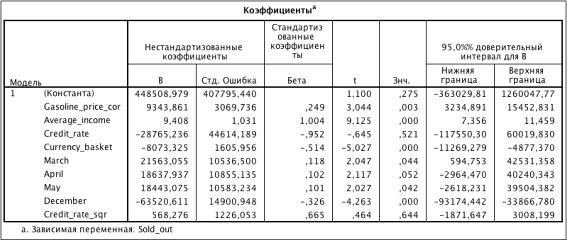
Из таблицы 3.8: Credit_rate_sqr незначим.
) Включаем Currency_basket _sqr:
Таблица 3.9. Коэффициенты модели (R2 = 0.731)
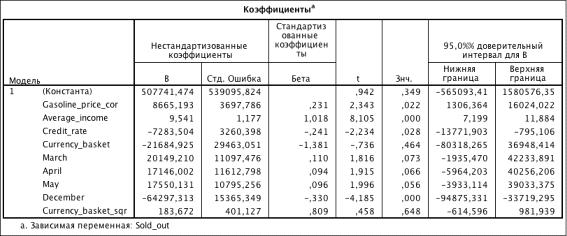
Из таблицы 3.9: Currency_basket_sqr незначим.
) Включаем Gasoline_price_cor _sqr:
Таблица 3.10. Коэффициенты модели (R2 = 0.736)
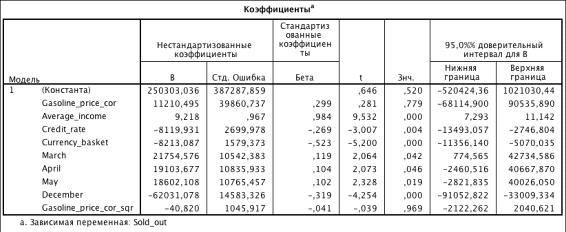
Из таблицы 3.10: Gasoline_price_cor _sqr незначим.
4) Включаем Average_income _sqr2 (значение Average_income в квадрате
и поделенное на 1000000):
Таблица 3.11. Коэффициенты модели (R2 = 0.786)
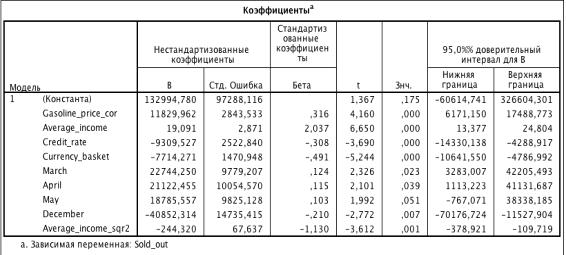
Из таблицы 3.1: Average_income _sqr значим.
Квадратичную форму переменной можно использовать только в том случае, когда сама переменная также входит в состав модели. По итогам проверки переменных в модели на квадратичную зависимость добавили новый предикатор Average_income_sqr2.
Влияние кризиса на продажи
Добавим в модель две новые фиктивные переменные: Crisis и After_crisis. Переменные отражают период
финансового кризиса в стране. Соответственно, если в момент конкретного
наблюдения в стране был кризис - значение Crisis равно 1, в после кризисный период - значение After_crisis равно 1. Во всех остальных случаях - 0.
Таблица 3.12. Коэффициенты модели (R2 = 0.812)
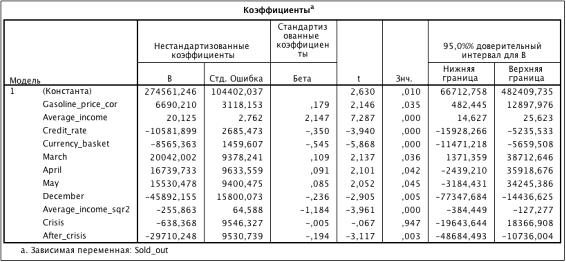
Из таблицы 3.12: Crisis
незначим, исключаем из модели:
Таблица 3.13. Коэффициенты модели (R2 = 0.810)
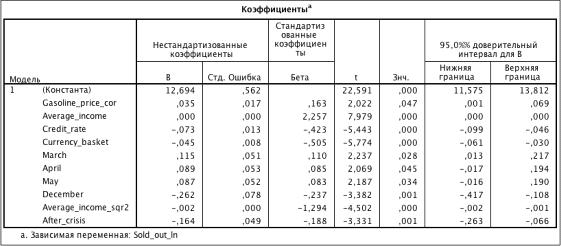
Исходя из результатов таблицы 3.13 все переменные значимы.
Проверка логорифмической зависимости
Построим линейную регрессию отобранных переменных от ln(Sold_out):
Таблица 3.14. Коэффициенты модели (R2 = 0.820)
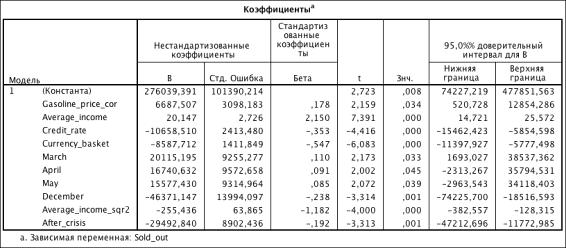
Результат оценки модели (таблица 3.14) с зависящей переменной, выраженной натуральным логарифмом Sold_out, показал лучшее значение коэффициента детерминации R2.
Проверка на гетероскедастичность
Количество степеней свободы p = 11
Критерий Бройша-Пагана LW = 24,21
LW
имеет распределение  с 10 степенями свободы (Приложение 3) при уровне значимости α
= 0,01, следовательно
гипотеза о гомоскедастичности остатков подтверждается.
Проверка на автокорреляцию
Для проверки модели на наличие автокорреляции использовался критерий
Дарбина-Уотсона, подсчет производился автоматически системой SPSS. Для построенной модели DW = 0,463. Значение критерия меньше
табличного dL, что говорит о наличии положительной
автокорреляции, необходимо в модель к предикторам добавлять лаговое значение
зависимой переменной (Sold_out_ln_lag).
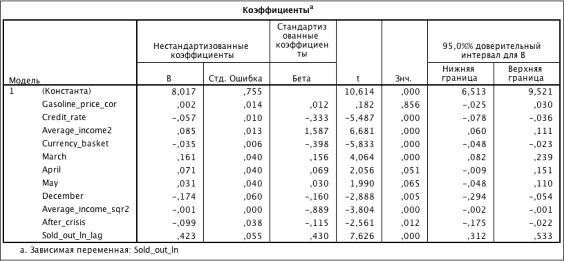
Таблица 3.15. Коэффициенты модели (R2 = 0.895)
.2.2 Ретроспективный прогноз
На основе 90 наблюдений была построена модель и применена к 9 наблюдениям. Рассчитанные прогнозные значения сведены в таблицу 3.26.