Курсовая работа (т): Современные поисковые системы
Современные поисковые системы
Министерство образования и науки Российской Федерации
Федеральное государственное бюджетное образовательное учреждение высшего профессионального образования "Московский государственный технологический университет "СТАНКИН"
Кафедра: информационные технологии
и вычислительные системы
Курсовая работа
по дисциплине
"Математическое моделирование процессов и систем"
СОВРЕМЕННЫЕ ПОИСКОВЫЕ СИСТЕМЫ
Выполнил: студент группы ИДМ-13-06
Блажко Сергей
Проверил: к. т. н., доцент
Пителинский К. В.
Москва 2013
Оглавление
Введение
1. Организация хранения данных
1.1 База данных и система управления базами данных
1.2 Хранение данных
2.1 Поиск информации в базах данных
2.2 Понятие индекса
3. Поисковые системы
3.1 Понятие поисковой системы
3.2 Особенности работы поискового движка
3.3 Использование индексов в поисковых системах
3.4 Особенности поиска текстовой информации
3.5 Особенности поиска графической информации
3.6 Особенности поиска аудио информации
3.7 Обзор популярных текстовых поисковых систем
3.8 Обзор популярных поисковых систем, предназначенных для поиска изображений
3.9 Обзор популярных поисковых систем, предназначенных для поиска аудио композиций
3.10 Обзор специализированных поисковых систем
Список использованной литературы
Введение
Сеть Интернет растет очень быстрыми темпами, и найти нужную информацию среди миллиардов Web-страниц и файлов становится все сложнее. Для поиска информации используются специальные поисковые серверы, которые содержат более или менее полную и постоянно обновляемую информацию о Web-страницах, файлах и других документах, хранящихся на десятках миллионов серверов Интернета.
Тем не менее, всякий рядовой пользователь наловчился находить нужную ему информацию при помощи поисковых систем. Казалось бы, что может быть проще - зайти при помощи веб-браузера на необходимый поисковый сайт и ввести в строку поиска необходимую комбинацию слов после чего получить несколько сотен тысяч подходящих результатов.
Однако технологии не стоят на месте. С появлением компактных цифровых мультимедийных устройств, таких как цифровых фотоаппаратов, плееров, видеокамер, мобильных телефонов, совмещающих предыдущие устройства, появилась возможность загружать на просторы интернета необходимые данные (музыкальные файлы, изображения, электронные документы). И если до недавнего времени стоял вопрос, можно ли находить мультимедийные данные в интернете таким же образом, как мы находим текстовую информацию, то сейчас даже это не является проблемой.
Итак, целью реферата является знакомство с организацией и основными методами хранения и поиска данных, которые востребованы в настоящее время, а именно данных, представленными в текстовом и мультимедийном (графическом и аудио) виде.
поисковая система информация база
1. Организация хранения данных
1.1 База данных и система управления базами данных
В настоящее время каждая серьезная система, целью которой является сбор и обработка информации не может обойтись без собственных баз данных (БД) и систем управления базами данных (СУБД).
Системы управления базами данных (СУБД) дают полный контроль над определением и обработкой и совместным использованием данных. Такие системы предоставляют все возможности управления и каталогизации больших объемов информации во множестве таблиц. СУБД обеспечивает три основные возможности: определение данных, обработка данных и управление данными. [1]
· Определение данных. Можно определить, какие данные будут храниться в базе данных, тип данных (например, текст или число) и связи между ними. В некоторых случаях можно задать способы форматирования и проверки допустимости данных.
· Обработка данных. Допускается любое манипулирование данными. Можно выбирать необходимые поля данных, фильтровать и сортировать данные. Также можно выполнять слияние связанной информации и выводить итоговые данные. Имеется возможность выделить подмножество данных и попросить СУБД обновить, удалить или скопировать его в другую таблицу либо создать новую таблицу с этими данными.
· Управление данными. Можно определять, кому разрешено просматривать, обновлять и добавлять информацию. В большинстве случаев имеется возможность определить порядок совместного использования и обновления данных несколькими пользователями.
Существует много видов и классов БД (и соответственно СУБД), которые различаются, как и в способе хранения данных, так и в способе доступа к ним и обработки, но рассмотрим только классы БД, которые используются в поисковых системах:
· Объектно-реляционная СУБД;
· Графовая СУБД;
Объектно-реляционная СУБД - реляционная СУБД (РСУБД), поддерживающая некоторые технологии, реализующие объектно-ориентированный подход: объекты, классы и наследование реализованы в структуре баз данных и языке запросов.
Объектно-реляционными СУБД являются, к примеру, широко известные Oracle Database, Informix, DB2, PostgreSQL. [2]
Пожалуй, самый распространенный класс СУБД, хорошо себя зарекомендовал и используется практически повсеместно для различных целей, начиная с организации телефонного справочника, заканчивая обработкой сверхбольших объемов данных. Также представители данного класса имеют самые высокие показатели производительности при выполнении задач общего назначения.
Графовая база данных - разновидность баз
данных с реализацией сетевой модели в виде графа и его обобщений.
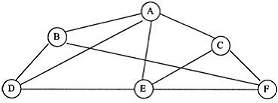
Модель хранения информации в виде графов, графов со свойствами в узлах и гиперграфов сложилась в 1990-2000 годах. Хотя использование графов в виде модели представления данных сложилась гораздо раньше, уже в 80-х годах 20-го века. Первую графовую СУБД создали уже в 2007 году (Neo4j). На настоящий момент существует более десятка графовых СУБД и это направление бурно развивается.
Графовую модель данных обычно рассматривают как обобщение RDF-модели или сетевой модели данных. Основными элементами модели являются узлы и связи. В зависимости от реализации узлов и ребер граф-модель данных разделяют на несколько подтипов. [3]
Данный вид баз данных применяется для моделирования социальных графов (социальных сетей), в биоинформатике, а также для семантического веб. [4] [5]
По мнению некоторых авторов, для задач с естественной графовой структурой данных графовые СУБД могут существенно превосходить реляционные по производительности, а также иметь преимущества в наглядности представления и внесения изменений в схему БД.
1.2 Хранение данных
Как и любые другие данные, обрабатываемые компьютером, информация в базах данных на низком уровне хранится в двоичной форме. От данного способа представления данных пока что уйти не получится. Тем не менее, в каждой из двух представленных баз данных возможно представление, понятное пользователю или программе, работающей с базой данных (которая все же делает данные понятные человеку).
В большинстве БД текстовую (строковую информацию) можно хранить напрямую, без каких-либо модификаций, потому что БД имеют встроенные типы и алгоритмы для этих целей. [6]
Что же касается мультимедийной информации (изображения,
аудио-видео и пр.), то "удобном" виде такие данные хранить не
получится, потому что чаще всего СУБД не имеет ни малейшего представления каким
образом эту информацию обрабатывать. Поэтому одним из решений является хранение
таких данных в битовых полях без возможности представить их в удобочитаемом
виде (эту возможность оставляют программному обеспечению, работающему с СУБД).
Иногда, в случае, если БД не может (из каких-либо соображений) хранить подобную
информацию, её представляют в знакомом нам, тестовом виде, например, используя BASE64 систему счисления
(кодирование Base64). [7]
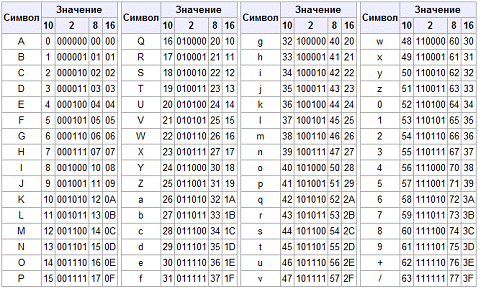
Схема соответствия "символ ↔
значение" в Base64
В каком бы виде не хранилась бы информация, необходимо
обеспечить взаимосвязь её с иной информацией. В объектно-реляционных СУБД эта
взаимосвязь устанавливается при помощи связи отношений, действуют законы и
операции теории множеств. В графовых БД данные данная связь изображается в виде
ребер графов или гиперграфов (что предпочтительнее в нашем случае).
2. Поиск данных
2.1 Поиск информации в базах данных
Процедура поиска является одной из центральных процедур в системах автоматической обработки информации. При решении любой задачи требуется выбирать исходные данные из некоторых заранее подготовленных массивов информации и записывать результаты решения в эти или другие массивы. Проблемы поиска информации в формализованных базах данных заслуживают самого серьезного внимания. Поиск информации в базах данных - это процесс отбора из них множества описаний объектов, удовлетворяющих сформулированным в запросе условиям. При этом в качестве результатов поиска могут выдаваться не все признаки объектов, а только часть их - в соответствии с условиями запроса. Объект может выбираться из массива по значению одного идентифицирующего его (ключевого) признака или по сочетанию значений нескольких ключевых признаков. Он может также выбираться по сочетанию любых других (неключевых) признаков, если это сочетание однозначно выделяет его из множества всех объектов массива.
Важной методологической проблемой прикладной компьютерной лингвистики является правильная оценка необходимого соотношения между декларативной и процедурной компонентами систем автоматической обработки текстовой информации. Чему отдать предпочтение: мощным вычислительным процедурам, опирающимся на относительно небольшие словарные системы с богатой грамматической и семантической информацией, или мощной декларативной компоненте при относительно простых процедурных средствах. И высказали мнение, что второй путь предпочтительнее. Можно представить себе крайний случай такого предпочтения, когда лингвистическая задача решается путем создания большого словаря и поиска в этом словаре необходимой информации. Однако более реальна ситуация, когда задача решается путем последовательного поиска в небольшом количестве достаточно представительных словарей и выполнения несложных процедур преобразования результатов поиска.
Будем различать первичные и производные (в частности, обобщенные) признаки объектов. Первичные признаки назначаются при первоначальном описании объектов, а производные являются функциями первичных. Поиск может вестись как по первичным, так и по производным признакам. Чаще всего в процессе поиска информации выбирается не один объект, а множество объектов. Оно может быть задано различными способами:
) перечнем значений ключевых признаков или сочетаний ключевых признаков;
2) значением или интервалом (перечнем) значений одного неключевого признака;
) булевой функцией значений или интервалов (перечней) значений любых признаков объекта (как ключевых, так и неключевых);
) отношением между признаками, выраженным с помощью арифметических и логических операции (операций типа "И”, "ИЛИ”, "НЕ”), а также отношений =, >, < и их отрицаний. Условия выборки признаков у найденных объектов задаются в виде перечней наименований этих признаков.
Важной проблемой, возникающей при реализации процедур поиска информации, является проблема отождествления признаков объектов и установления парадигматических отношений между ними (отношений типа род-вид, целое-часть и др.). Общее решение этой проблемы связано с возможностью распознавания смыслового тождества и парадигматических отношений различных форм наименований понятий на основе их морфологического, синтаксического и семантического анализа. Но на практике широко применяются и другие решения, основанные на унификации форм представления наименований понятий в базах данных и использования систем меню, в которых пользователю предлагается делать выбор наименований понятий только из числа рекомендованных.
· композиция запросов - запросы выполняются в строго определенной последовательности, а результаты поиска по предыдущему запросу используются в качестве исходных данных для формирования следующего за ним запроса. При этом первый запрос в серии запросов определяется полностью, а остальные - не полностью и доопределяются в процессе поиска.
· объединение запросов - когда результаты поиска по нескольким запросам объединяются в одну общую выдачу.
· разветвление запросов - когда после выполнения очередного запроса есть возможность перехода к одному из нескольких запросов в зависимости от выполнения тех или иных условий. Перечисленные способы организации процесса выполнения запросов могут применяться в различных сочетаниях, что позволяет строить различные процедуры многошагового поиска. [8]
2.2 Понятие индекса
Создание или внедрение СУБД обусловлено в первую очередь большими объемами хранимых и обрабатываемых данных. Немаловажной операцией с данными является их поиск. Современные СУБД используют индексы для хранимых данных, то есть производится их индексация. Индекс - объект базы данных, создаваемый с целью повышения производительности поиска данных. Таблицы в базе данных могут иметь большое количество строк, которые хранятся в произвольном порядке, и их поиск по заданному критерию путем последовательного просмотра таблицы строка за строкой может занимать много времени. Индекс формируется из значений одного или нескольких столбцов таблицы и указателей на соответствующие строки таблицы и, таким образом, позволяет искать строки, удовлетворяющие критерию поиска. Ускорение работы с использованием индексов достигается в первую очередь за счёт того, что индекс имеет структуру, оптимизированную под поиск.
Существует два типа индексов: кластерные и некластерные. При наличии кластерного индекса строки таблицы упорядочены по значению ключа этого индекса. Если в таблице нет кластерного индекса, таблица называется кучей. Некластерный индекс, созданный для такой таблицы, содержит только указатели на записи таблицы. Кластерный индекс может быть только одним для каждой таблицы, но каждая таблица может иметь несколько различных некластерных индексов, каждый из которых определяет свой собственный порядок следования записей.
Индексы могут быть реализованы различными структурами. Наиболее частоупотребимы B*-деревья, B+-деревья, B-деревья и хеши.
Для эффективной работы многомерными данными самыми популярными типами индекса являются: GIST (Generalized Search Tree) и GIN (Generalized Inverted Index). GIN индекс, или обобщенный обратный индекс - это структура данных, у которой ключом является лексема, а значением - сортированный список идентификаторов документов, которые содержат эту лексему. Так как в обратном индексе используется бинарное дерево для поиска ключей, то он слабо зависит от их количества и потому хорошо шкалируется. Этот индекс используется практически всеми большими поисковыми машинами, однако его использование в базах данных для индексирования изменяющихся документов затруднено, так как любые изменения приводят к большому количеству обновлений индекса. Этот индекс лучше всего подходит для неменяющихся коллекций документов. В тоже время, GIST индекс является "прямым" индексом, т.е. для каждого документа ставится в соответствие битовая сигнатура, в которой содержится информация обо всех лексемах, которые содержаться в этом документе, поэтому добавление нового документа приводит к добавлению только одной сигнатуры.