Курсовая работа (т): Современные поисковые системы
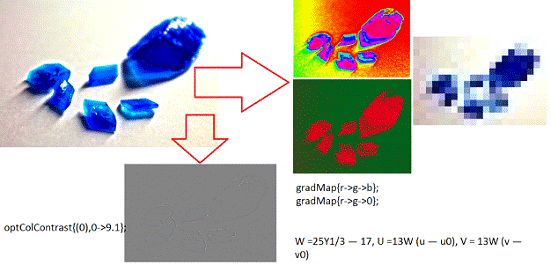
Пример извлечения признаков
Далее пользователь загружает необходимое ему изображение, тем самым формируя поисковый запрос. Поисковый движок по тому же принципу, по которому производилось извлечение признаков у изображений подлежащих индексации, получает признаки загруженного пользователем изображения, после чего происходит поиск вариантов аналогично поиску текстовой информации.
Такой способ поиска также иногда называют компьютерным зрением.
Также иногда поисковая система позволяет комбинировать прямой
и реверсивный способы поиска для более точного результата.
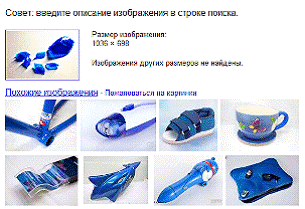
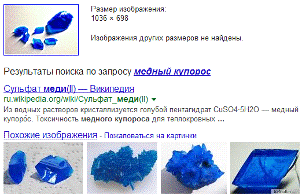
Примеры результатов поиска: слева - реверсивный, справа комбинированный
3.6 Особенности поиска аудио информации
Каждый из нас бывал в такой ситуации, когда в голове вертится какая-то мелодия, но название никак не вспоминается. Или композиция была услышана по радио или просто на улице, а кто поет и как называется - не известно. В таких случаях очень кстати приходятся поисковые системы, способные производить поиск аудио информации.
Аналогично поиску графической информации, существует несколько техник в опознании песни, применение каждой из них зависит от того, что, собственно, знает человек об искомой композиции.
У каждого аудиофайла есть два главных идентификатора - название
и исполнитель.
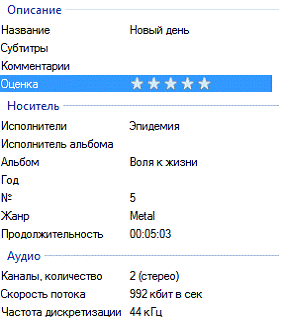
Пример метаданных аудиофайла
Другое дело, что с комбинацией "название и исполнитель" далеко не всегда все ясно. Даже вполне официальные источники порой путаются в правильном написании названий музыкальных групп или их песен. Чего уж говорить об обычных людях.
Простейший случай - человек помнит название песни, но не
помнит исполнителя. Или наоборот. В этом случае поисковая система должна иметь
доступ к базам данных по исполнителям и их творчеству. Производится
обыкновенный тестовый поисковый запрос. Пользователь посмотрит предложенные
варианты, послушает их фрагменты в потоковом формате и выберет нужное.
Пример результата поиска по названию композиции
Для создания подобной базы точкой опоры пока даже в Интернете остаются музыкальные CD. Ведь подавляющее число аудиозаписей по-прежнему выходит в первую очередь в этом формате. Все выпущенные диски каталогизируются, заносятся в классификаторы с соответствующими индексами.
С технической точки зрения, у поисковых систем, работающих с аудио информацией структура индекса немного различается и чаще всего представляется в виде N-грамм. С семантической точки зрения, это может быть последовательность звуков, слогов, слов или букв. На практике чаще встречается N-грамма как ряд слов. Целью построения N-граммных моделей является определение вероятности употребления заданной фразы. Эту вероятность можно задать формально как вероятность возникновения последовательности слов в неком корпусе (наборе текстов). К примеру, вероятность фразы "счастье есть удовольствие без раскаяния" можно вычислить как произведение вероятностей каждого из слов этой фразы:
= P (счастье) * P (есть|счастье) * P (удовольствие|счастье
есть) * P (без|счастье есть удовольствие) * P (раскаяния|счастье есть
удовольствие без)
Рассчитать вероятность P (счастье) дело нехитрое: нужно всего лишь посчитать сколько раз это слово встретилось в тексте и поделить это значение на общее число слов. Но рассчитать вероятность P (раскаяния|счастье есть удовольствие без) уже не так просто. К счастью, мы можем упростить эту задачу.
Примем, что вероятность слова в тексте зависит только от предыдущего слова. Тогда наша формула для расчета фразы примет следующий вид:
= P (счастье) * P (есть|счастье) * P (удовольствие|есть) * P
(без|удовольствие) * P (раскаяния|без)
Уже проще. Рассчитать условную вероятность P (есть|счастье) несложно. Для этого считаем количество пар 'счастье есть' и делим на количество в тексте слова 'счастье'.
В результате, если мы посчитаем все пары слов в некотором тексте, мы сможем вычислить вероятность произвольной фразы. Этот набор рассчитанных вероятностей и будет биграммной моделью. [14]
Именно такая структура наиболее полно позволяет индексировать как контекстуальные (текстовые) признаки аудиофайлов, так и исключительно музыкальные признаки (будут рассмотрены позже).
Вернемся к базам данных. В Интернете уже довольно долго существуют онлайн-базы музыкальных данных. В таких базах содержится справочная информация о множестве исполнителей, альбомов, композиций. Их называют CDDB. Большинство музыкальных сервисов и поисковых систем использует эти первичные данные.
Если сравнивать песню с человеком, то информацию,
содержащуюся в базах CDDB, можно сравнить с паспортными данными. Название
композиции, альбом, в состав которого она входит, имя исполнителя или название
группы - это ее ФИО. Но нужен номер паспорта. Его роль играет уникальный
идентификатор CD, с тем отличием, что он относится не к одному треку, а к их группе.
Откуда берется этот идентификатор? Так как создатели стандарта аудио-CD в свое время никак не могли планировать существования треков с CD вне самого CD, то они не предусмотрели на диске никакой идентификационной информации. Таким образом, компакт-диск по умолчанию - человек без паспорта. Его самого надо опознать.
Если продолжить аналогию с человеком, то сделать это можно по его приметам. Для CD это будет сочетание числа аудиофайлов и их продолжительности. Вместе они дают достаточно уникальную картину. Так и работают CDDB - в их базах хранятся уникальные идентификаторы CD, рассчитанные на основании данных о числе, последовательности и продолжительности треков - "фоторобот" диска. Программа-клиент на ПК пользователя создает такой "фоторобот" для диска, подлежащего идентификации, соединяется через Интернет с базой и ищет в ней совпадающий по приметам диск. Подобным образом могут опознаваться как физические CD-диски, так и их сжатые в MP3 и другие форматы копии, главное, чтобы сохранилась уникальная структура.
В идеале у музыки должны быть "устанавливающие личность документы" или "особые приметы". Для композиций на носителе - CD - это уникальные параметры диска, позволяющие восстановить все данные по базам CDDB. Для оцифрованной музыки это метаданные.
В реальности же все не так просто. Что делать, если аудиофайл лишен каких-либо примет? Таких ситуаций может быть немало: запись с радио, безвестный файл, скачанный из интернета, запись с диктофона, оцифрованная аналоговая запись.
В случае с человеком на помощь приходят отпечатки пальцев. Это работает и для песен.
Акустические "отпечатки пальцев" - это выжимка из
цифрового аудиофайла, минимальный объем информации, по которой его можно
достоверно установить. Обычно это небольшой массив данных, до 10 КБ.
Принципиально, что "отпечатки", содержат чисто музыкальные
характеристики - ритм, окраску звучания, информацию о мелодии - и не зависят от
конкретного файла, из которого получены. Стоит также заметить, что способ получения
таких отпечатков может отличаться у различных поисковые систем, и часто
является закрытой информацией, хотя есть и представители с открытым кодом
(например, The Echo Nest Musical Fingerprint). [15]
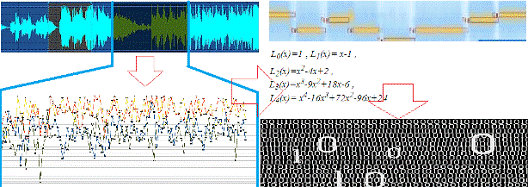
Анализ звукового файла
Далее все делается очень похоже на технологии CDDB: программа-клиент через интернет сверяет передаваемую ей композицию с базой данных таких "отпечатков". Если обнаруживается совпадение, значит, файл опознан.
В итоге мы можем алгоритмизировать процесс опознания музыки и разбить его на степени сложности:
-ая степень - известно имя песни и/или автор, но неточно. Здесь вполне может помочь система автокоррекции ошибок, поиск по базам CDDB по названию - чтобы найти исполнителя или наоборот.
-ая - нет информации о песне, но есть аудиоматериал. Это запись с радио, диктофона, оцифровка аналога. Здесь на помощь придет опознание по акустическим отпечаткам пальцев. [16]
3.7 Обзор популярных текстовых поисковых систем
Для обзора выберем некоторые популярные в Российской Федерации системы текстовой информации:
· Google;
· Bing;
· Яндекс;
· DataparkSearch;
· Sphinx;
· Lucene.
Данный выбор обоснован как популярностью использования среди пользователей Интернета, так и популярностью внедрения в порталы, в том числе и в корпоративные.
Google (произносится как "Гугл", производное от слова гугол - числа, равного 10100) - Крупнейшая в интернете поисковая система, принадлежащая корпорации Google Inc.
Первая по популярности система [17] (79,65 %), обрабатывает 41 млрд 345 млн запросов в месяц (доля рынка 62,4 %), индексирует более 25 млрд веб-страниц, может находить информацию на 195 языках.
Поисковый робот Google - Googlebot, является основным роботом, сканирующим содержание страницы для поискового индекса. Также существует робот для сканирования страниц, предназначенных для мобильных устройств (Googlebot-Mobile). Робот соблюдает стандартные Интернет-приёмы для запросов, такие как использование файлов robot. txt, Sitemap, мета-теги, noindex, nofollow . Поддерживает поиск в документах форматов PDF, RTF, PostScript, Microsoft Word, Microsoft Excel, Microsoft PowerPoint и других.
Существует возможность выполнения в интерфейсе сложных запросов на внутреннем языке, что также позволяет использовать поисковую систему как сканер уязвимостей. [18]
Также система позволяет встраивать поиск в собственных сайтах, благодаря открытому API.
Bing
Популярность данной поисковой системы обуславливается в первую очередь большим числом пользователей ОС Windows (не Windows Phone), в стандартном браузере которой Bing является поисковым сервисом по умолчанию.
Основой для поисковой системы служит поисковый движок Kumo (произносится "Кумо" - яп. паук или облако).
Возможности поисковой системы больше направлены на визуальное оформление, такие как:
· ежедневно изменяющиеся темы оформления стартовой страницы с информационными блоками;
· вывод уточняющих вариантов поисковых запросов по отдельным категориям;
· видео с автоматически запускающимся предварительным просмотром;
· дополнительные данные по каждому результату поиска;
· встроенный сервис для поиска маршрутов (другие специальные поисковые сервисы появятся в скором времени);
· функции, повышающие удобство в использовании при поиске информации, изображений и видео.
Яндекс
Поисковая система "Яндекс" (также "Яндекс. Поиск") является четвёртой среди поисковых систем мира по количеству обработанных поисковых запросов (4,84 млрд, 2,8 % от мирового количества, статистика за декабрь 2012 года). Причём, нужно отметить, "Яндекс" является самым быстрорастущим поисковиком из первой пятёрки, с 28 % за 2012 год. Доля на рынке Рунета составляет 60,5 %.
Поиск Яндекса позволяет искать документы на русском, татарском, украинском, белорусском, казахском, турецком, английском, немецком и французском языках с учётом морфологии этих языков и близости слов в предложении.
С 23 июня 2011 года поиск "Яндекса" установлен на портале Rambler (произносится "рамблер").
Помимо веб-страниц в формате HTML, Яндекс индексирует документы в форматах PDF (Adobe Acrobat), Rich Text Format (RTF), двоичных форматах Word (. doc), Excel (. xls), PowerPoint (. ppt), RSS (блоги и форумы). Поисковая система способна также индексировать текст внутри объектов Shockwave Flash (если текст не помещен на само изображение), если эти элементы передаются отдельной страницей, имеющей MIME-тип application/x-shockwave-flash, и файлы с расширением. swf. [19]
Отличительная особенность Яндекса - возможность точной настройки поискового запроса. Стоит отметить, что язык менее гибкий, но более простой в отличие от языка запросов Google.
Поисковый движок по аналогии с Google соблюдает стандартные Интернет-приёмы для запросов, однако именно Яндекс впервые предложил использование тега noindex.Engine (произносится "Дэйта-Парк-Сёрч Энжин") - поисковая машина (не система) с открытым исходным текстом, написанная на языке С. Распространяется по лицензии GNU GPL. Предназначена для организации поиска на одном или многих веб-серверах.самостоятельно может индексировать текст, HTML, а также многие другие данные, используя внешние парсеры.
Машина готова для индексирования мультиязычных сайтов: поддерживается множество различных кодировок и языков, а также их автоматическое определение; использует технологию согласования содержимого для индексирования копий одной и той же страницы на разных языках; может искать без учёта акцентов символов (диакритических знаков); а также разбивать на слова и фразы китайского, корейского, тайского и японского языков. Возможно использование синонимов, акронимов и всех морфологических форм слова для расширения результатов поиска.
Использует собственную технологию ссылочного ранжирования, основанную на нейронной сети. Эта технология называется Neo Popularity Rank (произносится "Нио Попьюларити Ранк"). Результаты поиска могут сортироваться по релевантности, популярности, дате последнего изменения и по важности (произведению релевантности на популярность).
Для уточнения ранжирования сайтов может автоматически строить рефераты индексируемых страниц, состоящие из трёх наиболее важных предложений. [20](от англ. SQL Phrase Index - индекс фраз (фразовый индекс) SQL) - система полнотекстового поиска, разработанная Андреем Аксеновым и распространяемая по лицензии GNU GPL. Отличительной особенностью является высокая скорость индексации и поиска, а также интеграция с существующими СУБД (MySQL, PostgreSQL) и API для распространённых языков веб-программирования (официально поддерживаются PHP, Python, Java; существуют реализованные сообществом API для Perl, Ruby,.net и C++).
По технологии SphinxSE осуществляется поиск на популярном блоге Хабрахабр, проекте Викимапия, популярном книжном интернет-магазине Буквоед, BitTorrent-трекере Пиратская бухта и других высоконагруженных проектах. [21]
The Apache Lucene (произносится "Апач Люцен") - это свободная библиотека (не система) для высокоскоростного полнотекстового поиска, написанная на Java. Может быть использована для поиска в интернете и других областях компьютерной лингвистики (аналитическая философия). Например, Lucene используется как компонента в децентрализованной поисковой системе YaCy. [22]
Возможности:
· Масштабируемая и высокоскоростная индексация
· свыше 95GB в час на современном оборудовании;
· требуется малый объем оперативной памяти - размер поджкачки всего 1MB;
· размер индекса примерно 20-30 % от размера исходного текста.
· Мощный, точный и эффективный поисковый алгоритм
· ранжированный поиск - лучшие результаты показываются первыми;
· множество мощных типов запросов: запрос фразы, шаблонные запросы, поиск интервалов и т.д.;
· поиск основанный на "полях" (таких как заголовок, автор, текст);
· возможность сортировать по различным полям;
· множественный индексный поиск с возможностью объединения результатов;
· возможность одновременного поиска и обновления индекса.
· Кроссплатформное решение
· исходный код полностью написан на Java;
· наличие портов на другие языки
программирования (С, С++, Perl и др.).