Курсовая работа (т): Современные поисковые системы
Для определения области применения каждого из индексов необходимо знать их основные различия:
· создание индекса - GIN требует в 3 раза больше времени чем GIST;
· размер индекса - GIN-индекс в 2-3 раза больше GIST-индекса;
· время поиска - GIN-индекс в 3 раза быстрее, чем GIST-индекс;
· обновление индекса - GIN-индекс
обновляется в 10 раз медленнее.
3. Поисковые системы
3.1 Понятие поисковой системы
Ранее неоднократно упоминалось понятие поисковой системы, однако не было сказано, что эта сама поисковая система из себя представляет.
Поисковая система - программно-аппаратный комплекс с веб-интерфейсом, предоставляющий возможность поиска информации в интернете. Под поисковой системой обычно подразумевается сайт, на котором размещён интерфейс (фронт-энд) системы. Программной частью поисковой системы является поисковая машина (поисковый движок) - комплекс программ, обеспечивающий функциональность поисковой системы и обычно являющийся коммерческой тайной компании-разработчика поисковой системы.
Поисковая машина (поисковый движок) - комплекс программ, предназначенный для поиска информации. Обычно является частью поисковой системы. [9]
Основными критериями качества работы поисковой машины являются релевантность (степень соответствия запроса и найденного, т.е. уместность результата), полнота индекса, учёт морфологии языка.
Поисковый движок выполняет следующие функции:
· Поиск ссылок на страницы и другие документы сайтов;
· Извлечение из документов информации, важной для поиска, преобразование этой информации в формат, удобный для поисковой машины и сохранение этой информации в базу данных поисковой машины (индексация данных);
· Поиск по базе данных проиндексированных документов;
· Ранжирование (сортировка) документов в соответствии с их релевантностью поисковым запросам;
· Кластеризация документов.
Чаще всего (текстовый) поисковый движок состоит из следующих компонентов:
· Spider (англ. паук) он же робот - программа очень похожая на браузер, но разница в том, что она скачивает HTML тексты и не работает с графической частью;
· Crawler (англ. обходчик) - программа обрабатывает найденные ссылки и как поводырь ведет паука по ссылкам;
· Indexer (англ. индексатор) - программа занимается анализом документов;
· Database (англ. база данных) - база данных всех найденных и обработанных документов;
· Search engine, results engine (англ. система обработки результатов) - именно данная программа решает какая страница соответствует введенному запросу, в каком порядке должны быть отсортированы html страницы. Все расчеты происходят исходя из внутреннего алгоритма, с которым и имеет дело оптимизатор;
· Web server (англ. веб-сервер) - сервер, предназначенный для взаимодействия между пользователем и поисковой системой. [10]
Пользователь, осуществляя поиск необходимой информации, отправляет поисковый запрос в поисковую систему.
Поисковый запрос - исходная информация для осуществления поиска с помощью поисковой системы. Формат поискового запроса зависит как от устройства поисковой системы, так и от типа информации для поиска.
Чаще всего поисковый запрос задаётся в виде набора слов или фразы, иногда - используя расширенные возможности языка запросов поисковой системы. Но бывают и совсем иные виды запросов. В некоторых поисковых системах запросом является изображение, а результатом поиска - страницы в интернете, на которых это изображение встречается.
.2 Особенности работы поискового движка
В целом, принцип работы поисковой системы не является тайной за семью печатями. Выглядит он примерно так: поисковые роботы, блуждая по гиперпространству, индексируют информацию, размещённую в виде html-документов и, собирают её в базы данных, располагая в определённом порядке. При вводе запроса в строке поисковой системы автоматически формируется обращение к необходимой базе данных (поисковый запрос). Система, на основании этого поискового запроса, выдаёт наиболее релевантные ответы, ранжируя сайты в определённом порядке, т.е. присваивая им позиции в поисковой выдаче в зависимости от их значимости.
Поисковые машины постоянно совершенствуют свои алгоритмы поиска. Для более релевантной выдачи поисковики учитывают поведенческие факторы пользователей, своего рода искусственный интеллект, который построен на более сложных вычислительных методах информационного поиска. И сейчас уже сложно представить, что изначально поисковые системы использовались лишь для управления информацией в научной литературе и осуществляли довольно примитивный поиск по ключевым словам.
Алгоритмы поисковых машин - это (зачастую) коммерческая, а поэтому закрытая информация. То, что именно учитывают поисковые системы при ранжировании сайтов, знают лишь разработчики этих систем. Каждая поисковая система использует свои алгоритмы для поиска, которые время от времени обновляются с целью осуществления более качественной, релевантной выдачи. [11]
3.3 Использование индексов в поисковых системах
Поисковый индекс - структура данных, которая содержит информацию о документах и используется в поисковых системах.
Индексирование (или индексация), совершаемое поисковой машиной, - процесс сбора, сортировки и хранения данных с целью обеспечить быстрый и точный поиск информации. Создание индекса включает междисциплинарные понятия из лингвистики, когнитивной психологии, математики, информатики и физики. Веб-индексированием называют процесс индексирования в контексте поисковых машин, разработанных, чтобы искать веб-страницы в Интернете.
Одной из основных задач при проектировании поисковых систем является управление последовательными вычислительными процессами. Существует ситуации, в которых возможно создание состояния гонки и когерентных отказов. Например, новый документ добавлен к корпусу, и индекс должен быть обновлен, но в то же время индекс должен продолжать отвечать на поисковые запросы. Это коллизия между двумя конкурирующими задачами. Считается, что авторы являются производителями информации, а поисковый робот - потребителем этой информации, захватывая текст и сохраняя его в кэше (или корпусе). Прямой индекс является потребителем информации, произведенной корпусом, а инвертированный индекс - потребителем информации, произведенной прямым индексом. Это обычно упоминается как модель производителя-потребителя. Индексатор является производителем доступной для поиска информации, а пользователи, которые ее ищут, - потребителями. Проблема усиливается при распределенном хранении и распределенной обработке. Чтобы масштабировать большие объемы индексированной информации, поисковая система может основываться на архитектуре распределенных вычислений, при этом поисковая система состоит из нескольких машин, работающих согласованно. Это увеличивает вероятность нелогичности и делает сложнее поддержку полностью синхронизируемой, распределенной, параллельной архитектуры
Популярные поисковые машины сосредотачиваются на полнотекстовой индексации документов, написанных на естественных языках. Мультимедийные документы, такие как видео и аудио и графика также могут участвовать в поиске.
Метапоисковые машины используют индексы других поисковых сервисов и не хранят локальный индекс, в то время как поисковые машины, основанные на кешированных страницах, долго хранят как индекс, так и текстовые корпусы. В отличие от полнотекстовых индексов, частично-текстовые сервисы ограничивают глубину индексации, чтобы уменьшить размер индекса. Большие сервисы, как правило, выполняют индексацию в заданном временно́м интервале из-за необходимого времени и затрат на обработку, в то время как поисковые машины, основанные на агентах, строят индекс в масштабе реального времени.
Архитектура поисковой системы различается по способам индексирования и по методам хранения индексов, удовлетворяя факторы. Индексы бывают следующих типов:
· Прямой индекс. Прямой индекс хранит
список слов для каждого документа.
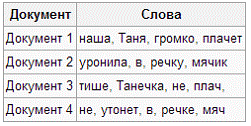
Пример прямого индекса
· Инвертированный индекс. Хранилище списка
вхождений каждого критерия поиска, обычно в форме хеш-таблиц или бинарного
дерева.
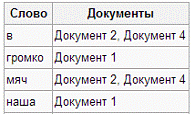
Пример инвертированного индекса
· Индекс цитирования. Хранилище цитат или гиперссылок между документами для поддержки анализа цитирования, предмет библиометрии.
· N-грамма. Хранилище последовательностей длин данных для поддержки других типов поиска или анализа документов.
· Матрица термов документа. Используется в латентно-семантическом анализе (ЛСА), хранит вхождения слов в документах в двумерной разреженной матрице.
Инвертированный индекс заполняется путем слияния или восстановления. Архитектура может быть спроектирована так, чтобы поддерживать инкрементную индексацию, где слияние определяет документ или документы, которые будут добавлены или обновлены, а затем анализирует каждый документ в слова. Для технической точности, слияние объединяет недавно индексированные документы, обычно находящиеся в виртуальной памяти, с индексным кэшем, который находится на одном или нескольких жестких дисках компьютера.
После синтаксического анализа индексатор добавляет указанный документ в список документов для соответствующих слов. В более крупной поисковой системе процесс нахождения каждого слова для инвертированного индекса может быть слишком трудоемким, поэтому его как правило разделяют на две части:
· разработка прямого индекса,
· сортировка прямого индекса в инвертированный индекс.
Инвертированный индекс называется так из-за того, что он является инверсией прямого индекса.
Для получения данных для индексов используется синтаксический анализ документов. Синтаксический анализ (или парсинг) документа предполагает разбор документа на компоненты (слова) для вставки в прямой и инвертированный индексы. Найденные слова называют токенами (анг. tokens), и в контексте индексации поисковых систем и обработки естественного языка парсинг часто называют токенизацией (то есть разбиением на токены). Синтаксический анализ иногда называют частеречной разметкой (анг. tagging), морфологическим анализом, контент-анализом, текстовым анализом, анализом текста, генерацией согласования, сегментацией речи, лексическим анализом. Термины "индексация", "парсинг" и "токенизация" взаимозаменяемы в корпоративном сленге.
Обработка естественного языка является предметом постоянных исследований и технологических улучшений. Токенизация имеет проблемы с извлечением необходимой информации из документов для индексации, чтобы поддерживать качественный поиск. Токенизация для индексации включает в себя несколько технологий, реализация которых может является коммерческой тайной.
3.4 Особенности поиска текстовой информации
Так или иначе, поиск информации сводится к поиску необходимого в базе проиндексированных документов (чаще всего имеются в виду HTML документы).
Рассмотрим алгоритмы поисковых систем как способы поиска информации в собранной поисковиками базе html-документов, такие как прямой поиск и алгоритм обратных индексов.
Метод простого перебора всех html-страниц содержащихся в
базах данных поисковых систем называется алгоритмом прямого поиска, но даже
притом, что этот метод позволяет, точно найти нужную информацию, не пропустив
ничего важного, он совершенно не подходит для работы с большими объемами данных
из-за длительности обработки. И поэтому более результативным методом поиска, является
алгоритм обратных индексов, на котором основан полнотекстовый поиск. Именно
этот алгоритм используется всеми крупными поисковыми системами в мире. Прямые
индексы, содержащие оригинальный текст документов, поисковики тоже сохраняют,
но только для составления сниппетов.
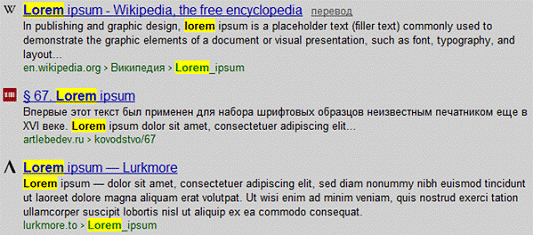
При использовании алгоритма обратных индексов, поисковые системы преобразовывают html-документы в текстовые файлы, которые содержат полный список имеющихся в документе слов. Эти слова располагаются в алфавитном порядке, а рядом с ними указаны координаты мест, где они встречаются. Кроме этого для каждого слова приводятся еще некоторые параметры (которые являются секретной информацией), определяющие его значение в документе. На примере это выглядит как список слов используемых в книге, с указанием номеров страниц, где эти слова встречаются. При вводе запроса поисковые системы выдают информацию не сразу из сети, а из собственных баз данных на основе обратных индексов. [12]
Так же в последнее время поисковые системы осваивают искусственный интеллект, направленный на развитие методов построения алгоритмов на основе машинного обучения, которые тесно связаны с извлечением информации и интеллектуальным анализом данных. В 2009 году Яндекс внедрил новый метод машинного обучения Матрикснет, который учитывает очень много факторов ранжирования и при этом не увеличивает количество оценок асессоров. [13]
При вводе одного и того же поискового запроса в разных поисковых системах результаты выдачи будут отличаться, потому что каждая поисковая система использует свои алгоритмы ранжирования.
Некоторые поисковые системы, занимающиеся поиском именно
текстовой информации строятся на основе графовых баз данных, то есть
структурами для хранения индексов являются графы (или чаще гиперграфы). Это
обосновано тем, что такие структуры намного нагляднее отражают все возможные
связи, а определения компонуются в области, что позволяет вести поиск не только
по точным соответствиям, но и по смежным определениям.
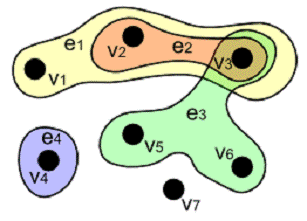
Пример гиперграфа
3.5 Особенности поиска графической информации
Современные поисковые системы способны производить поиск также и графической информации. В отличие от текстовой информации, поиск графических документов затруднен хотя бы тем, что графические документы можно преобразовывать в различные форматы и изменять их размеры, что делает затруднительным их прямой и индексный поиск ввиду различия в низкоуровневой организации.
Так например, любое изображение хранящееся без какого-либо сжатия возможно преобразовать в сжатое, тем самым изменив место, занимаемое документом на жестком диске и, возможно, удалив часть незначительной информации (при сжатии алгоритмами, предусматривающими потери). С точки зрения "анатомии" эти графические файлы хоть и не имеют (а если и имеют то незначительные) визуальных отличий, но их структура будет кардинально отличаться.
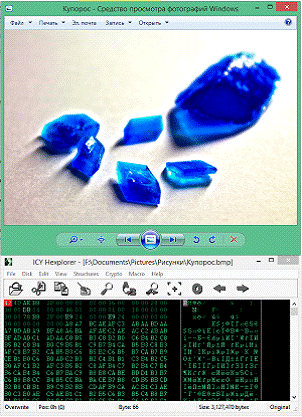
Визуальное и внутренне сравнение графических файлов в форматах jpeg (слева) и bmp (справа)
Дело обстоит иначе, в случае, когда графические файлы имеют некоторую дополнительную информацию (метаданные или EXIF). Такой информацией может являться:
· Дата и время создания изображения;
· Имя автора;
· Параметры съемки и наименование цифровой аппаратуры (программы) при помощи которой было получено изображение;
· Координаты места, где было получено изображение (геометка);
· Иная информация.
Также допускается внесение дополнительной информации непосредственно на веб-страницах без внесения оной непосредственно в графический документ (контекстуальная информация).
Такую информацию довольно легко можно получить из графического документа и занести её в базу данных и тем самым совершать поиск изображения аналогично поиску текстовой информации.
Вышеуказанный способ поиска называется прямым, то есть мы ищем непосредственное изображение по ключевым признакам. Существует также т. н. реверсивный поиск изображений, который заключается как в поиске подобных изображений, так и в поиске метаданных об изображении.
На данный момент существует довольно много сервисов, обеспечивающих такую возможность. В общем случае принцип таких систем не отличается от принципа работы тестовых поисковых систем. Все различие заключается в алгоритмах индексации и поиска, которые, опять же, чаще всего являются закрытыми.
В общем случае не трудно представить, каким образом
производится реверсивный поиск изображений. Как и в случае с текстовыми
поисковыми системами, поисковые роботы исследуют просторы интернета с целью
нахождения различных изображений. Также, для ускорения поиска происходит
индексация найденных изображений, однако данными для индексации являются уже не
слова (то есть определения), а признаки, применимые исключительно к графическим
документам. Такими признаками могут быть: цветовая гамма изображения, параметры
анализа цветового контраста и пр. То есть формируется скелет изображения или,
лучше сказать, его оттиск.