Таблица
|
Наименование
поисковой системы (движка)
|
Тип
|
Лицензия
|
Назначение
|
Типы индексируемых
документов
|
Тип индекса
|
API/ протоколы
|
Варианты поиска
|
Производительность
(предполагаемая)
|
|
Google
|
Поисковая
система
|
Проприентарная
|
Интернет поиск
|
Html,
xml, PDF, RTF, PostScript, doc (x), xls (x), ppt (x) и др.
|
Информация
закрыта
|
Открытый API, возможно встраивание в сайт
|
Собственный
мощный язык запросов
|
Индексирует
>45 млрд страниц, среднее время вывода 0.12 сек. /терм.
|
|
Bing
|
Поисковая
система
|
Проприентарная
|
Интернет поиск
|
Html,
xml, PDF, RTF, PostScript, doc (x), xls (x), ppt (x) и др.
|
Информация
закрыта
|
Закрытый API
|
Упрощенный язык
запросов
|
Индексирует
>18 млрд страниц, среднее время вывода 0.2 сек. /терм.
|
|
Яндекс. Поиск
|
Поисковая
система
|
Специальная, с
закрытым исходным кодом
|
Интернет поиск
|
Html,
xml, PDF, RTF, PostScript, doc (x), xls (x), ppt (x) и др.
|
Монолитный +
индекс цитирования + распределенный поиск
|
Собственный
язык запросов
|
Индексирует
>12 млрд страниц, среднее время вывода 0.11 сек. /терм.
|
|
DataparkSearch
|
Поисковая
машина
|
Свободное ПО с
открытым исходным кодом (GNU
GPL)
|
Поиск на одном
или нескольких веб-серверах
|
Html,
xml и др.
|
Монолитный GIST.
|
SQL
DB
|
Булевый поиск,
поиск по фразам, учёт близости слов
|
Точные данные
неизвестны
|
|
Sphinx
|
Поисковая
система
|
Свободное ПО с
открытым исходным кодом (GNU
GPL)
|
Поиск на одном
или нескольких веб-серверах
|
Только текст
или SQL DB
|
Монолитный +
дельта-индекс, возможность распределённого поиска
|
SQL DB, собственный XML-протокол,
встроенные API для РНР, Ruby, Python, Java, Perl
|
Полнотекстовый
поиск, булевый поиск, возможно использование синонимов, акронимов и всех
морфологических форм слова.
|
Среднее время
0.1 сек. при 4 ГиБ индекса.0.5 сек при 100 ГиБ. Есть примеры работ на базах
данных объемом несколько ТиБ.
|
|
Lucene
|
Библиотека для
организации поиска
|
Свободное ПО с
открытым исходным кодом (Apache License 2.0)
|
Построение
поисковых систем для интернета, в P2P сетях
|
Текст, возможна
индексация базы данных через JDBC
|
Инкрементный
индекс, но требующий оптимизации
|
Java API
|
Булевый поиск,
поиск по фразам, нечёткий поиск, учёт близости слов, поиск по маске
|
Известна лишь
скорость индексации: около 20 МиБ/минута
|
3.8 Обзор
популярных поисковых систем, предназначенных для поиска изображений
Для обзора поисковых систем для изображений были выбраны
следующие популярные сервисы:
· Tineye;
· Google картинки;
· Поиск Mail.ru;
· Яндекс. Картинки.
Tineye (произносится "Тин-Ай" - дословно
оловянный глаз) - Поиск дубликатов фотографий. Ищет точно такие же фотографии
или фотографии более высокого разрешения. Кроме того, TinEye может использоваться
тогда, когда нужно найти одного и того же человека на разных фотографиях.
Пользователь может загрузить свою фотографию в поисковик или же указать адрес
картинки, размещенной в интернете. После этого система произведет поиск похожих
и в поисковой выдаче представит список фотографий с указанием сайтов, на
которых фото размещено, и имен найденных графических файлов.
Google картинки
Google использует технологии компьютерного зрения,
чтобы сопоставить картинку с другими изображениями в индексе Google Картинок и других
коллекциях. Поисковая система подбирает похожие графические файлы, а также
наиболее точное текстовое описание запроса. Поэтому в результатах поиска есть
изображения, похожие на картинку запроса или соответствующие ее описанию.
Страница результатов Поиска по картинке отличается от страницы результатов
обычного поиска и поиска изображений. Главное отличие в том, что здесь показаны
не только картинки, но и веб-страницы, имеющие отношение к запросу. Иными
словами, результаты подбираются на основе поискового запроса и связанной с ним
информации.
Поиск Mail.ru
Аналогично обычному поиску, Mail.ru позволяет находить
изображения согласно введенному запросу. Поддерживается только прямой способ
поиска, то есть поиск изображения согласно текстовому запросу.
Яндекс. Картинки
На начальном этапе своего существования поиск изображений
основывался исключительно на извлечении и анализе метаданных, связанных
непосредственно с изображениями: атрибутов alt, заголовков страниц и текстов
ссылок на изображения. Постепенно для поиска изображений стали учитывать также
и текст, расположенный на той же веб-странице, что и картинка. Параллельно с
поиском изображений по метаданным развивалось, и продолжает успешно
развиваться, другое направление - поиск изображений по их содержанию. Этот вид
поиска основывается на технологии компьютерного зрения. Она призвана обучить
машину смотреть на изображение глазами человека, понимать и анализировать его
содержимое: цвета и формы объектов, их текстуру, взаимное расположение. Набор
метаданных, характеризующих изображение, ограничен, а компьютерное зрение
позволяет значительно расширить количество атрибутов, которые учитываются при
поиске картинок и ранжировании результатов.
Таблица
|
Наименование
поисковой системы
|
Возможность
производить прямой поиск
|
Возможность
производить инверсный поиск
|
Поиск
изображения по цветовой гамме
|
Тип поиска
|
Ограничения
|
Поддержка
поисковых ограничений
|
Использование API, количество индексированных изображений
|
|
Tineye
|
отсутствует
|
Изображение, URL
|
присутствует
|
Поиск по
метаданным, полное или частичное совпадение, коррекция размера
|
Ограничение
количества поисковых запросов (для бесплатного сервиса), форматы файлов: JPEG, PNG, GIF объемом до 20 МиБ
|
Только robot. txt
|
Использование API разрешено только при использовании
оплаченного сервиса. Индексировано более 4 млрд. изображений
|
|
Google картинки
|
присутствует
|
Изображение, URL
|
отсутствует
|
Поиск по
метаданным, полное и частичное совпадение, поиск подобного изображения (по
цветовой гамме, форме и т.п.), коррекция размера
|
Форматы файлов:
JPEG, PNG, BMP, GIF размер не более 8000x6000 пикс. объем файла ограничивается
объемом, разрешенным для разовой передачи по HTTP
|
robot.
txt, nofollow
|
Открытый API. Количество индексированных изображений
зависит от индексированных веб-страниц и количества загруженных изображений
на сервисы Google
|
|
Поиск Mail.ru
|
присутствует
|
отсутствует
|
отсутствует
|
-
|
robot. txt
|
Зависит от
количества изображений, загруженных на сервисы Mail.ru
|
|
Яндекс.
Картинки
|
присутствует
|
Изображение, URL
|
присутствует
|
Поиск по
метаданным, полное и частичное совпадение, коррекция размера
|
Форматы файлов:
JPEG, PNG, BMP, GIF объемом до 20 МиБ
|
robot. txt, nofollow, noindex
|
Открытый API. Количество индексированных изображений
зависит от индексированных веб-страниц и количества загруженных изображений
на сервисы Yandex
|
3.9 Обзор
популярных поисковых систем, предназначенных для поиска аудио композиций
Поисковые системы, предназначенные для идентификации
аудиокомпозиций в том или ином случае обращаются к базам данных CD. Существуют сервисы
работающие как по принципу веб-сервисов, так и с использованием специфического
ПО. Рассмотрим наиболее популярные:
· TrackID (MusicID);
· Tunatic;
· Shazam;
· Last. fm;
· Яндекс. Музыка;
· ThankYou.
TrackID (от англ. Track Identification - идентификация дорожки
(звуковой)) - сервис, созданный в начале 2006 года калифорнийской компанией Gracenote (произносится
"Грейсноут") для телефонов серии Walkman (англ. Плеер) компании Sony Ericsson (кроме ранних моделей
серии - W200,
W300, W550, W700 и W800), позволяющий
узнавать исполнителя и название музыкального произведения по его короткому
отрывку, записанному на микрофон телефона. На данный момент приложение доступно
для аппаратов на базе ОС Android (произносится "Андроид"). Для
распознавания музыкального произведения пользователь запускает программу - она
записывает отрывок (10-12 секунд) музыкального произведения с помощью
встроенного микрофона телефона в формате AMR и отсылает на Web-сервис Sony
Ericsson, где он сравнивается с образцами, существующими в базе данных, и через
несколько секунд, в случае успеха, на экране высвечивается информация о песне.
Tunatic
Tunatic (произносится "Тьюнатик") - Бесплатное
программное обеспечение для онлайн-идентификации музыки, разработанное Sylvain Demongeot для операционных систем Windows и Mac OS. Принцип распознавания
песни таков: снимается акустический отпечаток, со сравнительно небольшого
участка аудио материала, через любой канал аудиокарты (канал можно выбрать в
настройках микшера, будь то микрофон, или линейный вход, или даже общий) и
отправляет данные в базу данных Tunatic, где происходит поиск совпадений с
аудиоотпечатками уже опознанных композиций. Если совпадение будет найдено, Tunatic вернёт название песни и
имя автора вместе с ссылкой для получения более подробной информации. По ссылке
можно перейти на страницу веб-сайта, где также уже будут указан исполнитель и
название композиции, а также приглашение скачать её в iTunes или рингтон, поискать
упоминание композиции в Google.
Shazam
Shazam (произносится "Шазам") - это
коммерческий кроссплатформенный проект (ранее был доступен только для мобильных
устройств, в данный момент существует приложение для Windows 8), осуществляющий поиск
информации о песнях. Пользователь Shazam использует микрофон своего мобильного
телефона для записи фрагмента музыки, которая играет где-либо. Затем фрагмент
сравнивается с центральной базой данных и при успешном сопоставлении выдается
информация о треке. Shazam может идентифицировать записанные звуки, которые передаются из
любых источников, таких, как радио - или телетрансляция, музыка в кинофильме
или клубе, при условии, что уровень фонового шума не слишком высок. Shazam хранит каталог аудио,
опознанных при помощи программы, давая прямые ссылки на данные треки на YouTube, если таковые там
имеются.. fm
Last. fm - интернет-портал музыкальной тематики, основным
сервисом которого является сбор информации о музыке, которую слушает
пользователь, и её каталогизация в индивидуальных и общих чартах. Регистрация
бесплатна. Функция интернет-радио бесплатна только для граждан США, Германии,
Великобритании, от остальных требуется подписка за $3, €3 или £3 в месяц.
Компания с такими амбициями на рынке музыкальных услуг, как Last. fm, не может зависеть от сторонних
провайдеров данных, в том числе акустических отпечатков пальцев. Поэтому Last. fm разрабатывает свою
технологию, используя внушительное комьюнити как источник данных и рабочую
силу. Пока технология находится в бета-версии, но компания заявляет, что ее
база уже содержит свыше 10 миллионов отпечатков.
Яндекс. Музыка
"Яндекс. Музыка" - сервис компании Яндекс,
позволяющий искать и легально бесплатно прослушивать музыкальные композиции,
альбомы и подборки музыкальных треков. Доступен посетителям из России, Украины,
Белоруссии и Казахстана. Сервис "Яндекс. Музыка" даёт возможность
пользователям:
· прослушивать лицензионную музыку с
использованием Adobe Flash-плеера или HTML 5 (для мобильных устройств);
· искать музыку с помощью простого поиска
или хорошо структурированного каталога;
· вставлять треки в блоги и страницы
социальных сетей;
· составлять свои плей-листы;
· получать музыкальные рекомендации;
· отправлять статистику в Last. fm
("скробблинг");
· импортировать аудиозаписи из своих
коллекций в соцсети "ВКонтакте".
ThankYou
ThankYou (англ. Спасибо) - интернет-портал,
распространяющий творческий контент по схеме "pay what you want" ("плати,
сколько хочешь"). В настоящее время на сайте работают музыкальный и
литературный разделы. Музыку и книги, размещенные на сайте, можно свободно
скачать, а затем, при желании, заплатить их правообладателям, нажав кнопку
"Спасибо". Создатели проекта считают самой справедливой моделью
оплаты творческого труда схему "pay what you want" ("плати,
сколько хочешь"), когда пользователи сначала свободно скачивают интересный
им контент, а затем платят (или не платят) за него по желанию.
Таблица
|
Наименование
поисковой системы
|
Используемая CDDB
|
Платформа
|
Тип поискового
запроса
|
Способ
получения результатов
|
|
TrackID
|
Gracenote
|
Java (SEMC), Android
|
Звук в формате AMR
|
Переадресация в
интернет-магазин
|
|
Tunatic
|
Собственная
(Sylvain Demongeot)
|
Windows,
Mac OS
|
Звуковой
отрывок (формат неизвестен)
|
Переадресация
на страницу веб-сайта, где будут указан исполнитель и название композиции, а
также приглашение скачать её в iTunes или
поискать упоминание композиции в Google
|
|
Shazam
|
Собственная
|
Windows
Phone, iOS, BlackBerry, Symbian, Android, Windows 8
|
Fingerprint+AMR
|
Представление
метаданных
|
|
Last. fm
Fingerprinter
|
Собственная
|
Web-based,
Windows, Mac OS, Linux
|
Fingerprint
или метаданные
|
Представление
упоминаний о композиции на сайте Last. fm и приглашение посетить веб-страницы с
упоминанием
|
|
Яндекс. Музыка
|
Собственная,
возможен импорт из других источников
|
Web-based, Android, iOS
|
Метаданные
|
Страница с
возможными результатами и возможностью прослушать результаты.
|
|
ThankYou
|
Собственная,
импорт из официальных источников
|
Web-based
|
Страница с
возможными результатами и возможностью прослушать и/или скачать результаты.
|
3.10 Обзор
специализированных поисковых систем
Помимо систем, занимающихся поиском полнотекстовой
информации, существуют системы, позволяющие находить текстовые документы
(электронные публикации с имеющимся текстовым слоем), в которых данная
информация присутствует. Отличие таких систем от систем обычного текстового
поиска в том, что движок старается найти наиболее точное соответствие всем
имеющимся термам в запросе с учетом их положения и, как правило, поисковые
запрос в таких системах гораздо объемнее. Многие поисковые системы,
рассмотренные ранее (Yandex, Google, Bing) позволяют находить упоминание информации в
ограниченном наборе типов публикаций, поэтому они рассматриваться не будут.
Рассмотрим следующие системы:
· Антиплагиат;
· Turtle (проект Дмитрия Крюкова);
· БД ВИНИТИ РАН;
· elibrary.
Антиплагиат
Антиплагиат (Антиплагиат. Ру) - российский интернет-проект,
программно-аппаратный комплекс для проверки текстовых документов на наличие
заимствований из открытых источников в сети Интернет и других источников.
Проект доступен как для рядовых пользователей, так и (в специальной версии) для
высших учебных заведений. С технической точки зрения система сочетает в себе
обыкновенную поисковую систему и систему полнотекстового поиска в электронных
публикациях. Существует несколько типов поиска согласно используемой лицензии.
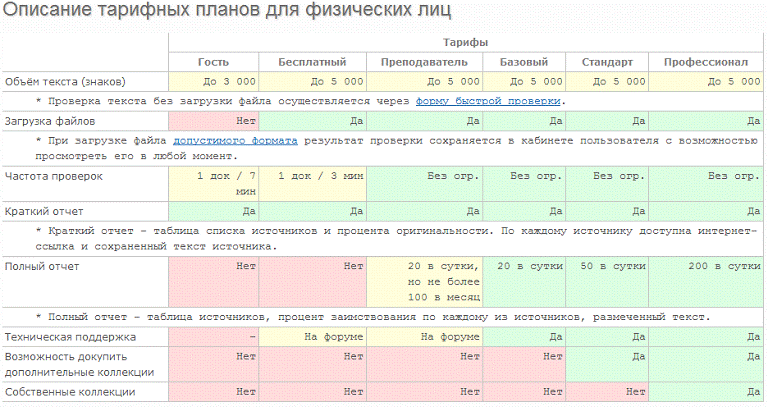
Существует возможность развертывания локальной версии системы
вне зависимости от доступа к Интернету.
Тем не менее, не смотря на популярность данной системы, её
работа вызывает много критики, как со стороны преподавателей, так и со стороны
учеников/студентов. Так неоднократно были замечены случаи, при которых данная
система кэшировала поисковый запрос и оставляла его для собственных целей,
после чего они (запросы) появлялись в интернете (на сайтах, на которых не
ведется поиск Антиплагиат-ом). Также до сих пор ведутся споры о правомерности
системы проверки, на основе которой построена система. Антиплагиат не имеет
никакого отношения ни к Минобрнауки России, ни к Высшей аттестационной
комиссии. Система разработана в инициативном порядке; какой-либо аттестации или
аккредитации при министерстве, либо ВАК данная система не проходила.
Turtle или Черепаха (turtle.ru) - проект Крюкова
Дмитрия, автора поисковой системы Rambler. Отличительной особенностью Turtle является
"Поиск по фрагменту", т.е. поиск с помощью технологии сравнения
похожих документов с заданным фрагментом текста, хотя также доступен
стандартный алгоритм поиска. Главная цель этой функции - обеспечить возможность
быстрого поиска "плагиата", т.е. материалов, которые
несанкционированно копируются с одного сайта на другой. Данная система имеет
своего поискового робота, который автоматически добавляет сайты в собственную
базу данных.
Поисковая система поддерживает стандартные приемы поиска,
однако в ней отсутствует собственный язык запросов. Также поддерживается поиск
по синонимам и поиск по всем формам слова.
По причине смерти Дмитрия Крюкова (14 апреля 2009) проект
временно приостановлен.
БД ВИНИТИ РАН
ВИНИТИ (Всероссийский Институт Научной и Технической
Информации) - крупнейший информационный центр России, основан в 1952г. с целью
улучшения информационного обеспечения ученых и специалистов. База данных (БД)
ВИНИТИ РАН - Федеральная база отечественных и зарубежных публикаций по
естественным, точным и техническим наукам, генерируется с 1981 г., обновляется
ежемесячно, пополнение составляет около 1 млн. документов в год. БД ВИНИТИ РАН
включает 28 тематических фрагментов, состоящих из 217 разделов. Для проведения
поиска одновременно по нескольким тематическим фрагментам, а также с целью
навигации по БД ВИНИТИ генерируется единая Политематическая БД. Также
существует возможность проведения специализированного on-line поиска: диалоговый поиск
и поиск специалистами ВИНИТИ.(от англ. Electronic Library - электронная
библиотека) − российский информационный портал в области науки, медицины,
технологии и образования. На платформе аккумулируются полные тексты и рефераты
научных статей и публикаций. По состоянию на январь 2012 в базе данных
eLIBRARY.ru насчитывается более 15 млн статей. Ресурс создан в 1998 году
компанией "Научная электронная библиотека". Старт проекта был связан
с необходимостью разработки единой web-платформы с интегрированным поисковым
аппаратом для обеспечения доступа российского научного сообщества к электронным
версиям ведущих мировых научных изданий, подписку на которые осуществлял
Российский фонд фундаментальных исследований. Существует возможность публикации
и полнотекстового и контекстуального поиска загруженной информации. Возможен
поиск с учетом морфологии и поиск похожего текста.
Проект аналогичен Google Scholar.
Список
использованной литературы
1. Когаловский
М.Р. Энциклопедия технологий баз данных. - М.: Финансы и статистика, 2002. -
800 с. - ISBN 5-279-02276-4.
2. Материалы
на сайте Центра информационных технологий CITForum -
http://citforum.ru/database/articles/ordbms10.
3. Renzo
Angles, Claudio Gutierrez Survey of Graph Database Models. - ACM Computing
Surveys, Vol.40, No.1, Article 1, 2008.
4. Материалы
на сайте Ibuildings - http://ibuildings.
nl/blog/2009/09/07/graphs-in-the-database-sql-meets-social-networks.
. Материалы
на сайте High Scalability http://highscalability.com/paper-graph-databases-and-future-large-scale-knowledge-management.
. Материалы
на сайте Мариупольского строительного колледжа
http://msk.edu.ua/ivk/Informatika/kolomna-school7-ict/st40401. htm.
7. Josefsson
S. The Base16, Base32, and Base64 Data Encodings. - The Internet Society, 2006
8. Материалы
на сайте Компьютерной лингвистики http://www.secreti. info/kl15.html.
. Захаров
Н.В. Информационно-поисковые системы в филологических науках [электронный
ресурс] http://www.zpu-journal.ru/e-zpu/2008/5/Zakharov_ISS/.
. Поисковая
система, релевантность, компоненты, алгоритмы поисковых систем [электронный
ресурс] http://www.web-analyst.ru/search_system.html.
. Поисковые
системы [электронный ресурс] - http://www.smartincom.ru/search-engines/.
. Материалы
на сайте Google https: // www.google.ru/insidesearch/howsearchworks/crawling-indexing.html.
. Материалы
на сайте Яндекс http://company. yandex.ru/technologies/matrixnet/.
14. Proceedings
of the 7th Annual Conference ZNALOSTI 2008, Bratislava, стр.54-65, Словакия, фев. 2008. - ISBN 978-80-227-2827-0.
15. EchoPrint
- открытая система распознавания музыки [электронный ресурс] http://habrahabr.ru/post/122969/.
. Музыкальные
сервисы в Интернете: опознание музыки [электронный ресурс]
http://www.mobile-review.com/mp3/articles/music-recognition. shtml.
17. Top
15 Most Popular Search Engines December 2013 [электронный ресурс]
http://www.ebizmba.com/articles/search-engines.
18. Взлом
при помощи Google на SecurityLab [электронный ресурс]
http://www.securitylab.ru/contest/212086. php.
. Поисковая
система Яндекс [электронный ресурс] http://dataword. info/poiskovaya-sistema-yandeks.
php.
. Материалы
на официальном сайте проекта DataparkSearch http://www.dataparksearch.org/.
. Материалы
на официальном сайте проекта Sphinx http://sphinxsearch.com/info/powered/.
. Материала
на официальном сайте проекта Lucene
http://lucene. apache.org/.