Дипломная (вкр): Страховое покрытие денежных остатков и запасов товаров в торговых точках ритейловой компании
Объем всего рынка страхования в России ежегодно растет. В 2016 году сборы страховых компаний превысили триллион рублей (рис. 2). Наибольшие доли рынка занимают КАСКО и ОСАГО: в 2015 году они вместе составляли 43% страхового рынка. Объем страхования имущества юридическими лицами в третьем квартале 2015 года составлял 27,3 миллиарда рублей, а в аналогичном периоде 2016 года 24,6 миллиарда. Падение объемов данного вида страхования вызвано сокращением его доли в структуре рынка (рис. 3). За год структура страхования сильно изменилась: значительно сократилась доля КАСКО и ОСАГО (до 34,4%), увеличились сегменты страхования жизни, ответственности и страхования от несчастных случаев.
Таблица 3
Рейтинг компаний по страхованию имущества юридических лиц
|
Компания |
Премии по страхованию имущества юр. лиц за 2015 год, тыс. руб. |
Динамика премий за год |
Доля отказов в выплате |
|
СОГАЗ |
46 018 252 |
2,0% |
8,1% |
|
Чулпан |
827 708 |
64,3% |
0,0% |
|
ВТБ страхование |
3 344 079 |
89,0% |
22,1% |
|
Росгосстрах |
4 452 886 |
-6,3% |
8,3% |
|
Согласие |
2 399 401 |
32,0% |
10,6% |
Источник: Лучшие страховые компании 2015 года (по работе с юридическими лицами) [26]
Лучшей компанией в секторе страхования имущества юридических лиц, согласно рейтингу лучших страховых компаний для юридических лиц в 2015 году, является «СОГАЗ». Собранные премии по страхованию имущества юридических лиц превышают 46 миллиардов рублей, что больше, чем у компании «Ингосстрах» (второго лидера по объему премий) более чем в 4 раза. Наибольший рост страховых премий за год произошел в компании «ВТБ страхование», там премии выросли практически в два раза. Отрицательную динамику собранных премий показали «Росгосстрах», «Энергогарант», «Ингосстрах» и «ВСК страховой дом». По объему выплат в 2015году лидировали «СОГАЗ», «ВТБ страхование» и «Альфа страхование». Их выплаты составляли 8,7; 3,0; 2,5 миллиарда рублей соответственно.
Основным понятием, используемым в данном исследовании, является страховая сумма. Согласно статье 10 Закона РФ «Об организации страхового дела в РФ» [29] под страховой суммой понимается «денежная сумма, которая установлена федеральным законом и (или) определена договором страхования и, исходя из которой, устанавливается размер страховой премии (страховых взносов) и размер страховой выплаты при наступлении страхового случая». Страховая премия выплачивается страхователем в соответствии с договором и тарифами за то, что страховщик берет на себя риски страхователя.
Чаще всего в страховании объект страхования или риск имеет определенную
стоимость, согласно которой и определяется не превышающая эту стоимость
страховая сумма. Особенностью данного исследования является наличие у
компании-ритейлера, выступающей в роли страхователя, страховых рисков,
стоимость которых трудно оценить однозначно вследствие ее быстрой изменчивости.
Целью ритейловой компании является страхование запасов товаров и остатков
денежных средств в следующем году, однако эти величины не определены и должны
быть предсказаны. Прогноз данных величин и представляет собой страховую сумму.
От качества модели и прогноза зависит размер страховых премий и выплат в случае
наступления застрахованных рисков. Если прогнозы товаров и денежных средств
будут занижены, то при наступлении убытков компания получит недостающую
компенсацию, если завышены, то ритейлер будет выплачивать слишком высокие
страховые премии. Это и определяет сложность и практическую значимость
исследования.
1.3 Обзор современных подходов к моделированию временных рядов денежных средств и товарных запасов ритейловых компаний
Так как массив анализируемых данных представлен в виде временных рядов, чтобы рассчитать страховое покрытие, необходимо прежде всего построить временную эконометрическую модель для прогнозирования денежных средств и запасов на ближайший год. Объекты страхования обладают различными характеристиками: запасы товаров имеют гладкий ряд с небольшим трендом, в ряду остатков денежных средств множество выбросов. Следовательно, каждый вид данных требует подбора наиболее оптимальной временной модели. Ниже были описаны модели, соответствующие характеристикам страховых объектов, и рассмотрены примеры моделирования похожих временных рядов.
Одной из наиболее распространенных и хорошо зарекомендовавших себя на практике эконометрических моделей временных рядов является интегрированная модель авторегрессии-скользящего среднего (ARIMA). Эта модель была впервые представлена Боксом и Дженкинсом [11] и впоследствии большинство инноваций в области моделирования временных рядов усовершенствовали или усложняли модель ARIMA.
Одной наиболее известной моделью для прогнозирования временных рядов является модель ARMA (модель авторегрессии-скользящего среднего). Данная модель позволяет моделировать стационарные временные ряды и обобщает две простые модели: модель авторегрессии AR и модель скользящего среднего MA.
Уравнение модели ARMA (p,q) имеет вид:
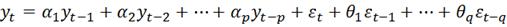
где p - порядок авторегрессии;- порядок разностей;- временная переменная;
 скользящее среднее ряда;
α - оценки параметров авторегрессии
θ - оценки параметров скользящего среднего
Для того, чтобы ряд был стационарным, должны выполнятся следующие предпосылки:
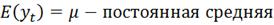
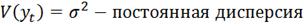
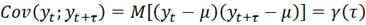
Однако в реальной жизни
стационарные ряды встречаются достаточно редко, обычно в данных присутствует
сезонность, периодичность, случайное блуждание или же линейная составляющая
времени. В этом случае ряд называют нестационарным и применяют модель
авторегрессии интегрированного скользящего среднего ARIMA(p,d,q), имеющее вид:
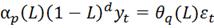
где d - порядок разностей;-лаг переменной;
Идея данной модели состоит в том, что при переходе к d-й разности, временной ряд становится стационарным и можно применять модель ARMA.
Данная модель достаточно гибкая и агрегирует большое количество информации, содержащейся во временных рядах. Кроме того, было доказано, что ARIMA применима для нестационарных рядов, которые имеют ярко выраженный тренд (Stoffer & Dhumway, 2010). Леонард в своей статье [19] доказал, что ARIMA также подходит для моделирования спроса на продукт и влияния маркетинговых мероприятий на продажи. Можно сделать вывод, что ARIMA применима для анализируемой задачи, так как спрос на товар имеет схожую динамику с продажами товаров.
Для того, чтобы сделать
модель ARIMA более реалистичной и отразить влияние сезонности, которая
характерна для таких переменных как продажи товаров, туризм или дневная
температура, была разработана сезонная модель авторегрессии-скользящего
среднего (SARIMA). Однако было доказано, что модели ARIMA с включенными
сезонными дамми-переменными показывают лучшие результаты, чем SARIMA на примере
агрегированных ритейл продаж в Южной Африке [15].
SARIMA (p, d, q)(Ps, Ds, Qs)s
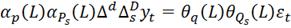
где Ps - сезонный параметр авторегрессии;s - порядок сезонной разности;s - сезонный параметр скользящего среднего;
Δ - оператор разности
Основной особенностью временных рядов, отражающих продажи или объем наличных денежных средств, является наличие выбросов, находящихся значительно выше среднего значения, характерных для праздничных дней. Данные выбросы тяжело смоделировать с помощью обычных моделей, но именно они представляют наибольший интерес. Одной из попыток решения данной проблемы является использование нейронных сетей (Shine and Basak, 2015). Для того, чтобы учесть нестационарность данных, которая возникает в объеме продаж из-за праздничных дней, нейронные сети были интегрированы в модель ARIMA: ARIMA моделировала линейную компоненту, а нейронные сети нелинейную компоненту, наблюдавшуюся в остатках.
Однако, так как применение
нейронных сетей к большому объему данных достаточно проблематично, данное
исследование опирается на Interrupted ARIMA - временные модели с интервенцией
(McDowall, McCleary, Meidinger and Hay, 1980). Данные модели оценивают
параметры авторегрессионной модели, а также параметры, моделирующие дискретные
события, которые постоянно или временно изменяют уровень среднего значения
временного ряда [17]. Interrupted ARIMA моделирует аномальные значения ряда T с
помощью введения dummy (фиктивной) переменной, которая принимает значения:
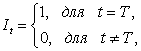
Таким образом, модель позволяет учитывать выбросы без влияния на среднее значение ряда без выбросов.
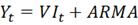
где Yt - временная переменная- коэффициент при аномальных значенияхt - dummy переменная- авторегрессионная модель
Кроме того, данная модель
может быть расширена до следующей спецификации:
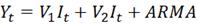
где V1 - коэффициент при аномальных значениях, объясняющий влияние выброса на тренд временного ряда;2 - коэффициент при аномальных значениях, объясняющий влияние выброса на среднее временного ряда.
Еще одной модификацией модели ARIMA является модель ARFIMA (Autoregressive fractionally
integrated moving average) [23]. Модели
ARFIMA моделируют процессы с длинной памятью. Стационарный процесс является
процессом с длинной памятью (Long memory processes), если существуют α, c
(0<α<1, c>0) и для
автокорреляционной функции (ACF) выполняется соотношение:
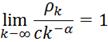
Процесс ARFIMA достаточно трудно отличить от обычных I (1) c помощью тестов малой мощности - Дики-Фуллера и Филипса-Перрона. Тест KPSS (Kwiatkowski-Phillips-Schmidt-Shin) состоятелен для стационарных процессов с длинной памятью, но необходимо большое количество наблюдений. Поэтому наиболее надежным является использование R/S анализа (анализ фрактальной структуры временных рядов). Также процессы с длинной памятью можно обнаружить исходя из графика автокорреляционной функции (ACF), который убывает с более медленной гиперболической скоростью.
Таким образом, были
проанализированы предпосылки и примеры временных моделей. Для прогнозирования
запасов товаров оптимальной моделью является ARIMA, а в
случае выявления сезонности SARIMA. Наиболее подходящими моделями для расчета страховых
сумм остатков денежных средств являются ARFIMA и Interrupted ARIMA. Первая модель хорошо подходит для данных с длинной
памятью и большим числом наблюдений. Вторая позволяет учесть влияние аномально
высоких продаж в праздники и выходные. В следующих главах представлены оценки
коэффициентов данных моделей и прогноз страховых сумм.
Глава 2. Моделирование и прогнозирование запасов товаров в торговых точках
.1 Основные характеристики временного ряда запасов товаров
Данная глава посвящена моделированию страхового покрытия запасов товаров в торговых точках. Первоначальный набор данных содержит ежемесячные наблюдения по 594 торговым точкам с 1 января 2012 года по 1 ноября 2016 года. Таким образом, в данной главе изучается 465 торговых точек с числом наблюдений от 47 до 59.
Чтобы выдвинуть предположение о виде будущей модели, необходимо
проанализировать графическое представление временных рядов. Ниже (рис. 4)
представлены временные ряды нескольких типичных торговых точек.
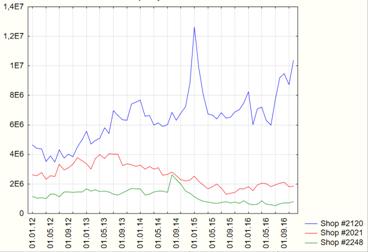
Рис. 4. Запасы товаров в торговых точках 2120, 2021, 2248, 2012-2016 гг.
На графике (рис. 4) видно, что ряды являются не стационарными, поведение ряда не похоже на белый шум. Наблюдается выраженный тренд для торговой точки №2120. Данная точка имеет один значительный скачок во время январских праздников в 2015 году. Поведение двух других торговых точек является стабильным и временные ряды не имеют заметных выбросов. Таким образом, можно предположить, что для моделирования запасов товаров наиболее подходящей будет модель ARIMA, построенная для первой разности.
Также рассмотрим распределение средних значений временного ряда для 465
точек.
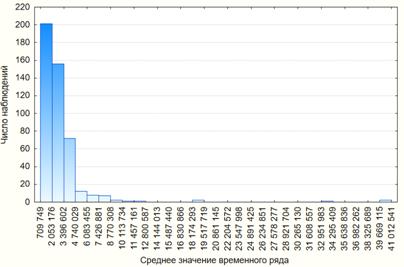
Рис. 5. Гистограмма распределения средних значений запасов в торговых
точках
Можно видеть, что средние значения распределены крайне неравномерно (рис. 5). Большая часть наблюдений лежит в интервале от 700 тысяч до 5 миллионов рублей. Однако есть также торговые точки с очень большими средними запасами товаров (до 42 миллионов рублей). Гистограмма средних значений товаров напоминает форму плотности логнормального распределения. Поэтому для дальнейшего анализа и разбиения наблюдений на группы денежные величины были прологарифмированы.
Рассмотрим гистограмму средних значений прологарифмированных значений
запасов товаров в торговых точках. Форма данной гистограммы близка к форме
нормального закона распределения. Однако тест Жарка-Бера отвергает гипотезу о
нормальном законе распределения (J-B=125, prob = 0,000). Но в целях нашего
исследования близость логарифмированных данных по виду гистограммы к нормальной
кривой можно считать достаточной.
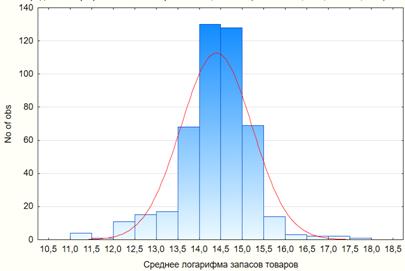
Рис. 6. Гистограмма среднего значения логарифма запасов товаров в точках
Так как число торговых точек очень велико, построение отдельной модели
для каждой из них не целесообразно. Поэтому, для обобщения большого числа
данных и упрощения оценки стоимости страховых рисков, торговые точки следует
разбить на группы. Кроме того, разбиение на группы будет производиться на
основе логарифмированных данных, так как алгоритм k-средних чувствителен к
выбросам, которые наблюдаются в данных, отличных от нормального распределения.
2.2 Классификация торговых точек со схожими характеристиками запасов товаров с помощью кластерного анализа
Данный параграф посвящен разделению торговых точек на группы. Прежде
всего, необходимо рассмотреть графическое представление точек в пространстве.
Можно видеть, что практически все точки расположены плотно друг к другу и
представляют одну большую совокупность (рис. 7). Кроме того, точечная диаграмма
построена только в двух координатах, а кластеризация позволяет учесть и другие
факторы. Данные факты обуславливают применение метода кластерного анализа.
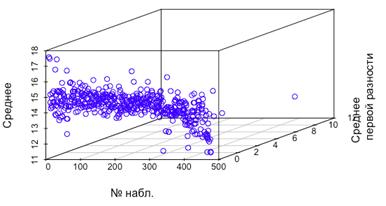
Рис. 7. Точечная диаграмма средних запасов и средних первых разностей
торговых точек
Наиболее удобным способом разбиения точек на группы с однородными
характеристиками является метод кластеризации k-средних. Суть метода k-средних
заключается в том, что изначально алгоритм случайно разбивает объекты на k
кластеров, а затем изменяет принадлежность наблюдений к этим кластерам таким
образом, чтобы минимизировать значение суммы квадратов расстояния от объекта до
центра соответствующего кластера:
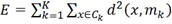 ,
где d - мера расстояния между наблюдением x и центром кластера m, к которому эта точка принадлежит.
Существует несколько наиболее часто употребляемых мер расстояния:
. Евклидово расстояние, квадрат Евклидова расстояния
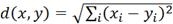 ,
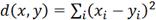
2. Манхэттенское расстояние
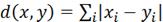
3. Расстояние Чебышева
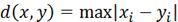
В данном исследовании в качестве меры длины используется Евклидово расстояние, наиболее подходящее природе используемых данных.