Дипломная (вкр): Страховое покрытие денежных остатков и запасов товаров в торговых точках ритейловой компании
В качестве характеристик, по которым будут кластеризованы точки, были взяты различные описательные статистики как самого временного ряда, так и его первой разности:
. Среднее значение запасов товаров в данной торговой точке
2. Стандартное отклонение запасов товаров;
. Размах временного ряда (max-min);
. Максимальный размах между соседними наблюдениями;
. Среднее первой разности;
. Стандартное отклонение первой разности.
При классификации торговых точек по запасам товаров количество выбросов не учитывается, так как экстремальные значения наблюдаются лишь у небольшого количества точек и не имеют повторяющихся закономерностей.
Метод k-средних очень удобен в применении, однако требует, чтобы число кластеров было задано изначально. Существует несколько способов определения числа кластеров.
Прежде всего, рассмотрим двумерную частотную таблицу, которая строится на основе среднего значения и стандартного отклонения значения логарифма запасов товаров (табл. 4).
Таблица 4
Двумерная частотная таблица логарифма запасов товаров
|
Пики частот |
Среднее значение логарифма запасов товаров |
|||||
|
|
(11.4,12.6] |
(12.6,13.8] |
(13.8,15.1] |
(15.1,16.3] |
(16.3,17.5] |
|
|
Стандартное отклонение логарифма запасов товаров |
(0.08,1.4] |
0 |
18 |
251 |
67 |
5 |
|
|
(1.4,2.7] |
0 |
7 |
21 |
0 |
0 |
|
|
(2.7,4.0] |
3 |
25 |
39 |
1 |
0 |
|
|
(4.0,5.2] |
8 |
7 |
0 |
0 |
0 |
|
|
(5.2,6.5] |
11 |
2 |
0 |
0 |
0 |
Можно видеть, что существует несколько областей концентрации частот. В данной таблице можно выделить от трех до четырех групп.
Отчетливо выделяется класс со стандартным отклонением в интервале (4; 6,5) и средним в интервале (11,4; 12,6). Остальные пики частот концентрируются в области со средним (12,6; 16,3) и стандартным отклонением (0,08; 4). В данной области можно выделить три или две группы в зависимости от того, выделять интервал со значением частоты, равным 21, в отдельный класс или нет.
Рассмотрим двумерную гистограмму для другой пары переменных: среднее
значение и максимальный размах между соседними наблюдениями. На гистограмме
(рис. 8) также видно два сгустка частот. Одна область намного больше другой и
содержит три ярко выраженные группы. Таким образом, первичный анализ показал,
что вся совокупность может быть разбита на три-четыре кластера.
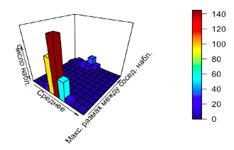
Рис. 8. Двумерная гистограмма средних запасов товаров и максимального размаха между соседними наблюдениями
Еще одним способом определения числа кластеров является иерархический
кластерный анализ. Преимущество данного анализа заключается в том, что он
учитывает не отдельные пары переменных, а весь набор характеристик. В данном
анализе используется метод Варда и расстояние Евклида. Число кластеров зависит
от значения меры расстояния, на которой выделяются кластеры (рис. 9): для
расстояния, равного 50, количество кластеров равно четырем; для расстояния 100,
трем. Так как совокупность точек велика, совокупность будет разбита на 4
кластера.
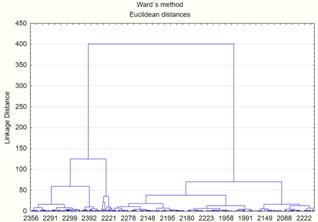
Рис. 9. Дендрограмма классификации торговых точек с помощью
иерархического кластерного анализа с использованием метода Варда
Ниже изображено (рис. 10) разбиение торговых точек на четыре кластера.
Видно, что кластеры разделены на 4 совокупности, различающиеся по двум
переменным.
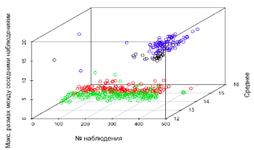
Рис. 10. Разбиение торговых точек по запасам товаров и их различным характеристикам на четыре кластера
Ниже (табл. 5) представлено обобщение результатов кластеризации. Черный
кластер содержит в себе наименьшее количество наблюдений. Зеленый и красный
кластеры похожи друг на друга по количеству наблюдений и по среднему значению.
Более подробные характеристики кластеров представлены ниже (табл.5).
Таблица 5
Характеристики четырех кластеров торговых точек по запасам товаров и их характеристикам
|
Кластер |
Логарифм товарных запасов |
Первая разность логарифма товарных запасов |
Число наблюдений |
||||
|
|
Среднее |
Максимальный размах между соседними наблюдениями |
Стандартное отклонение |
Среднее |
Размах временного ряда |
Стандартное отклонение |
|
|
Черный |
12,47 |
15,08 |
4,92 |
0,87 |
0,12 |
0,16 |
33 |
|
Красный |
15,14 |
0,98 |
0,24 |
0,34 |
0,09 |
0,08 |
159 |
|
Зеленый |
14,27 |
1,23 |
0,30 |
0,48 |
0,10 |
0,10 |
181 |
|
Синий |
13,97 |
15,03 |
2,90 |
0,64 |
0,11 |
0,13 |
92 |
Можно видеть, что все кластеры различаются по всем переменным. Синий с
черным и красный с зеленым кластеры похожи по максимальному размаху между
соседними наблюдениями и стандартному отклонению. Для того, чтобы проверить
значимость разбиения был проведен дисперсионный анализ. Дисперсионный анализ
проверяет значимость различий хотя бы между двумя центроидами кластеров по всем
характеристикам разбиения.
Таблица 6
Дисперсионный анализ разбиения на четыре кластера
|
|
Черный |
Красный |
Зеленый |
Синий |
|
SS Within |
187 |
49 |
194 |
234 |
|
SS Between |
18989 |
|||
|
SS Total |
19653 |
|||
Дисперсионный анализ показал, что
дисперсия между кластерами объясняет 97% от общей дисперсии. Также была
рассчитана F-статистика по следующей формуле:
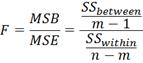
где SSbetween - сумма квадратов отклонений между кластерами,within - сумма квадратов отклонений внутри кластеров,- число кластеров,- число кластеризованных наблюдений.
Полученная F-статистика = 148 больше значима, следовательно, полученное разбиение на кластеры значимо.
Таким образом, было получено четыре группы со значимыми различиями по характеристикам кластеризации. Далее временные ряды для каждой из них будут усреднены и на их основе будут построены временные модели.
.3 Прогнозирование временных рядов запасов товаров по кластерам с помощью модели ARIMA
Прежде всего, необходимо провести графический анализ усредненных временных рядов для каждого из пяти кластеров.
На графике (рис. 11) видно, что красный кластер значительно превышает
другие ряды по среднему значению. Кластеры черный, синий и зеленый имеют
одинаковую динамику и пики в похожие даты. Например, самый заметный скачек в
данных кластерах произошел в начале 2015 года. Черный кластер имеет
значительный рост в 2012 году и к 2013 году сокращает разрыв с синими кластером
практически до нуля. Зеленый кластер имеет наиболее спокойное поведение, и пики
в нем практически отсутствуют.
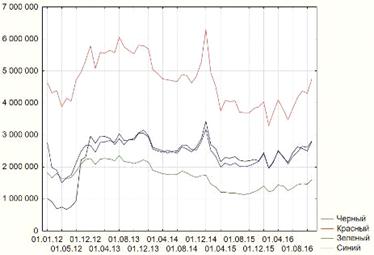
Рис. 11. Усредненные временные ряды для четырех кластеров
Все кластеры имеют примерно схожие характеристики временных рядов, поэтому исследование будет проводиться на примере одного кластера.
Данные временные ряды имеют слабый тренд, и, чтобы получить стационарный белый шум, необходимо перейти к первой разности. Чтобы доказать это, прежде всего необходимо провести анализ корреллограмм и периодограммы. Рассмотрим данные графики для синего кластера (рис. 12-15).
Рис. 12. Коррелограмма временного ряда запасов точек синего кластера
На данной коррелограмме (рис. 12) значимы первые 5 лагов, в то время как
у стационарных рядов автокорреляции не наблюдается.
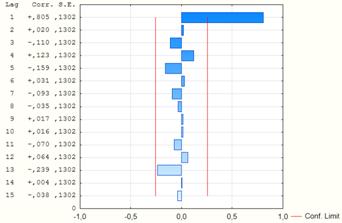
Рис. 13. Частная коррелограмма запасов точек синего кластера
Частная коррелограмма также показывает значимость первого лага.
Периодограмма позволяет понять, есть ли в данных сезонность и тренд.
Периодограмма (рис. 13) показывает, что временной ряд синего кластера имеет
тренд, так как наблюдается скачок на нулевой частоте. Сезонности в данных не
наблюдается.
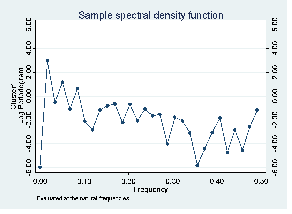
Рис. 14. Периодограмма запасов точек синего кластера
Проведем также тест на единичный корень Дики-Фуллера. Первым был проведен
тест Дики-Фуллера с константой и трендом, в результате чего было выявлено, что
тренд не значим. Тест с исключенным трендом представлен ниже (табл.7).
Таблица 7
Тест Дики-Фуллера для синего кластера
|
Level |
Critical values |
t-статистика |
Prob |
|
1% |
-4,12 |
-2,25 |
0,45 |
|
5% |
-3,49 |
|
|
|
10% |
-3,17 |
|
|
Таким образом, гипотеза о наличии единичного корня не отвергается.
Рассмотрим те же характеристики для ряда после взятия первой разности. Видно
(рис. 15), что практически все значения автокорреляционной функции лежат внутри
доверительного интервала. Кроме того, наибольшие значения корреляционная
функция принимает на лаге 12, следовательно, можно предположить, что в модель
ARIMA войдет именно этот лаг.
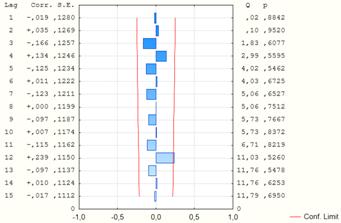
Рис. 15. Автокорреляционная функция для первой разности синего кластера
Тест Дики-Фуллера также показал отсутствие единичных корней: t-статистика равна -8,17 (prob = 0,0001). Таким образом, можно переходить к построению модели ARIMA, наиболее оптимальной модели для ряда первой разности (рис. 16), чье поведение похоже на белый шум.
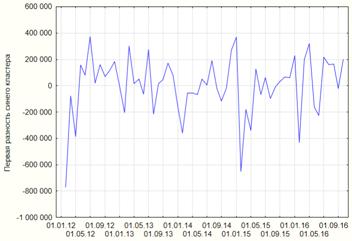
Рис. 16. Временной ряд первой разности запасов точек синего кластера
Первая разность временного ряда синего кластера не имеет тренда, сезонности (рис. 16) и, как уже говорилось ранее, имеет наибольшее значение корреляции на 12 лаге (рис. 14). Поэтому при подборе модели было включено более 12 лагов и на каждом шаге исключались незначимые.
Для всех кластеров модель ARIMA построена после взятия первой разности (d
= 1). Все кластеры имеют в качестве наилучшей модель с AR(12) и MA(12) лагами.
Результаты моделирования для всех кластеров представлены ниже. Все лаги значимы
на уровне 0,001. Оценки лагов имеют похожие значения для зеленого и красного
кластера, несмотря на то, что данные временные ряды имеют разное поведение.
Таблица 8
Результаты модели ARIMA запасов товаров для точек 4 кластеров
|
Кластер |
Черный |
Красный |
Зеленый |
Синий |
|
AR(12) |
- |
0,75*** |
0,70*** |
0,80*** |
|
MA(12) |
0,88*** |
-0,88*** |
-0,85*** |
-0,58*** |
|
Akaike |
27,3 |
28,06 |
25,47 |
26,86 |
***-Значимость на уровне 0,001
В черный кластер вошел только MA(12) лаг. Таким образом, можно сделать вывод, что на прогноз следующего года влияют значения прошлогодних запасов товаров.
Для красного кластера был построен динамический прогноз на год вперед.
Данный прогноз является усредненным для всех точек. На основе оценок моделей
кластеров можно спрогнозировать также запасы товаров в каждой конкретной
торговой точке. Исходя из прогноза (рис.17) можно сказать, что в начале 2017
года страховая сумма не превысит пяти с половиной миллионов. Весь 2017 год
запасы товаров будут иметь общий возрастающий тренд. Пик запасов придется на
конец 2017 года, в новогодние праздники. В это время страховая сумма не
превысит 6 миллионов в среднем для каждой точки.
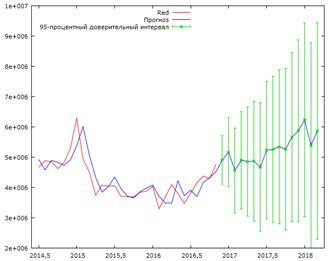
Рис. 17. Прогноз продаж красного кластера на 2017 год
В таблице представлены характеристики прогноза на 2017 год для всех
кластеров. Черный, зеленый и синий кластеры в 2017 году демонстрируют слабую
динамику, рост не превышает 10%. Только в зеленом кластере с наименьшими
средними значениями наблюдается небольшое падение запасов товаров. Прогнозные
ряды имеют небольшой разброс: среднее и максимальное значение ряда отличаются
слабо.
Таблица 9
Характеристики прогноза запасов товаров в точках выделенных кластеров на 2017 год
|
Кластер |
Красный |
Черный |
Зеленый |
Синий |
|
Среднее значение ряда |
4 743 682 |
2 830 171 |
1 560 829 |
2 927 980 |
|
Максимальное значение ряда |
5 869 469 |
2 890 043 |
1 686 831 |
3 054 781 |
|
Динамика запасов товаров |
13,50% |
3% |
-2,60% |
7,40% |
|
Страховое покрытие с надежностью 0,95 |
6 381 818 |
3 598 864 |
1 961 818 |
3 527 273 |
Выводы по главе 2
Таким образом, все торговые точки были разделены на четыре кластера со значимыми различиями в характеристиках ряда и его первой разности. Данные кластеры имеют схожие временные ряды и характеристики автокорреляционной и частной автокорреляционной функций. Было доказано, что ряды становятся стационарными после взятия первой разности. Была построена модель ARIMA с лагами AR(12) и MA(12). Высокие корреляции на 12 лаге означают зависимость прогноза от прошлогодних наблюдений. Для определения страховой суммы были построены прогнозы для всех кластеров. В 2017 году ряды демонстрируют слабую динамику. Наибольшая страховая сумма приходится на красный кластер, максимальное значение прогноза 5,8 миллионов рублей. В других кластерах страховая сумма не превышает трех миллионов.